Votre mémoire d’informatique repose sur un vrai jeu de données — logs applicatifs de l’entreprise d’accueil, export d’une base utilisateurs, corpus scrapé sur le web — et personne ne vous a expliqué ce que le RGPD impose avant de le manipuler pour votre recherche. Contrairement à un mémoire de sciences sociales où l’entretien est la donnée, un mémoire d’informatique traite souvent des volumes de données personnelles bien supérieurs, avec des risques de ré-identification spécifiques à l’analyse automatisée. Ce guide détaille la conformité RGPD et les techniques d’anonymisation adaptées à un projet de mémoire en informatique.
Le RGPD s’applique-t-il à un jeu de données de mémoire ?
Oui, dès que le jeu de données contient des informations permettant, directement ou indirectement, d’identifier une personne physique — un identifiant utilisateur, une adresse IP, un pseudonyme lié à un compte, une combinaison de caractéristiques rares. Le RGPD (règlement UE 2016/679) prévoit un régime allégé pour le traitement à des fins de recherche scientifique, mais « allégé » ne signifie pas « absent » : les principes de minimisation, de finalité déterminée et de sécurité du traitement s’appliquent pleinement à un mémoire de master, y compris quand les données proviennent d’un stage en entreprise.
Deux situations doivent être distinguées d’emblée :
- Les données de l’entreprise d’accueil : leur usage pour votre mémoire suppose un accord explicite du responsable de traitement de l’entreprise (souvent le DPO), au-delà de l’accord de votre maître de stage sur le sujet lui-même. Cet accord doit préciser le périmètre de données autorisé, la durée d’usage et les conditions de diffusion du mémoire.
- Les données collectées par scraping ou API publique : même publiquement accessibles, des données personnelles collectées sur le web restent soumises au RGPD. La collecte doit respecter les conditions d’utilisation de la plateforme source et rester proportionnée à votre question de recherche.
Anonymisation ou pseudonymisation : une distinction technique, pas cosmétique
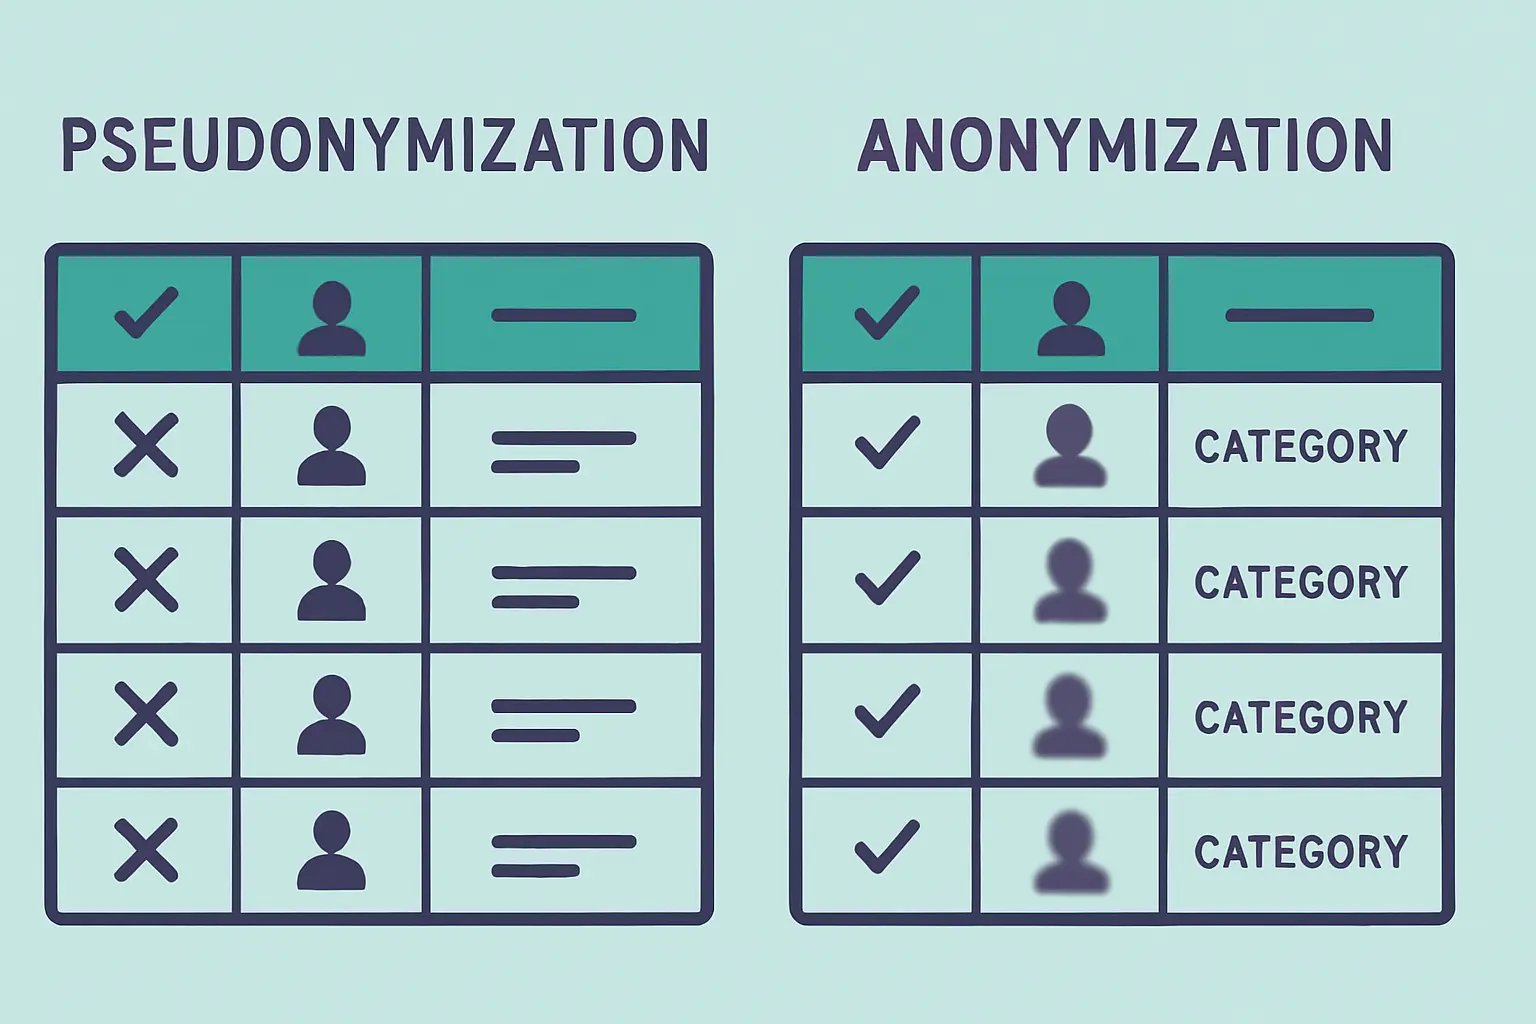
La CNIL distingue strictement ces deux notions, et la confusion entre les deux est l’erreur la plus fréquente relevée dans les mémoires d’informatique traitant de données réelles :
| Notion | Ce qu’elle garantit | Statut RGPD |
|---|---|---|
| Pseudonymisation | Remplacement des identifiants directs par un code, réversible avec une table de correspondance conservée séparément | Reste une donnée personnelle : le RGPD continue de s’appliquer intégralement |
| Anonymisation | Irréversibilité garantie : aucune ré-identification possible, même avec des moyens raisonnables | Sort du champ d’application du RGPD une fois l’anonymisation démontrée robuste |
Un jeu de données où vous avez remplacé les noms par des identifiants numériques (user_1, user_2…) est pseudonymisé, pas anonymisé : si la table de correspondance existe quelque part, même non consultée pour votre mémoire, le jeu reste une donnée personnelle. Écrire « données anonymisées » dans votre chapitre méthode alors que la table existe est une erreur méthodologique que le jury identifie immédiatement à la première question sur votre pipeline de traitement.
Techniques d’anonymisation applicables à un jeu de données de mémoire
Plusieurs techniques, combinables, permettent de réduire le risque de ré-identification d’un jeu de données réel :
- Suppression des identifiants directs : noms, adresses e-mail, numéros de téléphone, identifiants de compte — la première étape, insuffisante seule.
- Généralisation : remplacer une valeur précise par une catégorie plus large (un âge exact devient une tranche d’âge, une ville devient une région), ce qui réduit le pouvoir discriminant de chaque attribut pris isolément.
- Le k-anonymat : garantir que chaque combinaison de caractéristiques quasi-identifiantes (âge, sexe, code postal) correspond à au moins k individus dans le jeu de données, pour qu’aucune ligne ne soit unique et donc ré-identifiable par recoupement.
- L’ajout de bruit statistique (confidentialité différentielle) : pour des agrégats ou des statistiques descriptives, ajouter une perturbation aléatoire calibrée qui préserve les tendances globales tout en rendant impossible la reconstruction d’une valeur individuelle exacte.
- Le hachage salé des identifiants : utile pour relier plusieurs tables entre elles sans exposer l’identifiant d’origine, à condition que le sel ne soit pas conservé avec le jeu de données livré.
Pour un mémoire, documentez explicitement la ou les techniques retenues et leur niveau de garantie dans le chapitre méthode : un jury attend que vous distinguiez « j’ai supprimé les noms » (insuffisant) de « j’ai appliqué une généralisation garantissant un k-anonymat de 5 sur les variables quasi-identifiantes » (une garantie mesurable).
Travailler sur des données réelles d’entreprise dans le cadre d’un stage
Un mémoire d’ingénieur ou de master informatique adossé à un stage manipule fréquemment des données de production : logs de connexion, historique de tickets, données d’usage d’une application. Trois précautions structurent un usage conforme :
- Obtenir un accord écrit précisant que ces données peuvent nourrir un travail académique diffusé, distinct de l’accord sur le sujet de stage lui-même.
- Travailler autant que possible sur un extrait agrégé ou échantillonné plutôt que sur l’export complet de la base de production, pour limiter le volume de données personnelles réellement manipulées.
- Vérifier, avant le dépôt du mémoire, que la version diffusée ne contient aucune capture d’écran, aucun tableau ni aucune annexe exposant des données individuelles identifiables — un jury et un dépôt institutionnel constituent une diffusion au sens du RGPD, même à échelle universitaire restreinte.
Les conditions d’utilisation d’une plateforme priment sur la seule question RGPD
Un mémoire d’informatique qui constitue son corpus par scraping ou via une API publique (réseau social, forum, plateforme d’avis) doit vérifier deux couches de règles distinctes, souvent confondues par les étudiants. D’une part, la conformité RGPD sur les données personnelles éventuellement présentes. D’autre part, et indépendamment, les conditions d’utilisation contractuelles de la plateforme source, qui peuvent interdire la collecte automatisée, limiter le volume de requêtes ou interdire la redistribution du corpus collecté — y compris en annexe d’un mémoire universitaire déposé publiquement. Une collecte techniquement possible n’est pas nécessairement autorisée : consultez systématiquement les conditions d’utilisation (souvent nommées « Terms of Service » ou « politique développeur ») avant de bâtir votre méthodologie sur une source précise, et prévoyez une alternative si la plateforme interdit explicitement l’extraction automatisée à des fins de recherche.
Si votre mémoire prévoit de publier le code de collecte et de traitement sur un dépôt public (GitHub, GitLab), assurez-vous que ce dépôt ne contienne lui-même aucune donnée brute non anonymisée : séparez le code, publiable, du jeu de données traité, qui reste soumis aux règles de diffusion décrites plus haut.
Préférer un jeu de données déjà ouvert quand c’est possible
Avant de vous lancer dans une anonymisation manuelle complexe, vérifiez si un jeu de données déjà anonymisé et publié n’existe pas pour votre question de recherche. Les portails de données ouvertes généralistes recensent de nombreux jeux exploitables en informatique (traces d’usage, corpus textuels, jeux annotés pour l’apprentissage automatique), déjà nettoyés de leurs identifiants directs par leurs producteurs. Consultez ce recensement de 25 sources de données ouvertes par discipline pour identifier une alternative avant d’entreprendre une collecte ou une anonymisation depuis zéro : c’est souvent l’option la plus rapide et la plus sûre juridiquement pour un mémoire de master.
Pour un projet où aucun jeu existant ne convient, la génération de données synthétiques — produites algorithmiquement pour reproduire les propriétés statistiques d’un jeu réel sans exposer aucun individu réel — constitue une alternative de plus en plus utilisée en informatique, en particulier pour les projets d’apprentissage automatique où la structure des données compte plus que l’identité des individus sous-jacents.
Solliciter le DPO de son université avant de commencer
La plupart des universités et écoles d’ingénieurs françaises disposent désormais d’un délégué à la protection des données (DPO) accessible aux étudiants, souvent via le service de la recherche ou l’école doctorale. Solliciter ce contact avant de démarrer la collecte ou le traitement de données réelles — et non après avoir constaté un problème — permet de faire valider votre méthode d’anonymisation et de sécuriser la conformité de votre mémoire sans retarder votre calendrier. Cette démarche s’articule avec le plan de gestion des données (PGD) attendu par un nombre croissant d’établissements, qui documente précisément l’origine, le traitement et la conservation de chaque jeu de données mobilisé dans votre mémoire.
Que faire des données après la soutenance
Une fois le mémoire soutenu, la question de la conservation des données réelles ne disparaît pas. Le RGPD impose de limiter la durée de conservation à ce qui est strictement nécessaire à la finalité de recherche annoncée : conserver indéfiniment un jeu de données pseudonymisé « au cas où » sur un disque personnel est une pratique non conforme. Les règles précises de durée de conservation et de destruction sécurisée après soutenance, y compris pour les données issues d’un stage en entreprise, sont détaillées dans ce guide sur la conservation des données après soutenance.
Si votre mémoire combine un jeu de données quantitatif avec des entretiens utilisateurs (par exemple pour évaluer l’expérience utilisateur d’un outil développé), le traitement de ces verbatims suit des règles d’anonymisation distinctes, détaillées dans ce guide sur l’anonymisation des entretiens — les deux types de données (structurées et verbatims) demandent des techniques différentes dans le même mémoire.
Exemple de paragraphe pour le chapitre méthode
« Le jeu de données mobilisé dans ce mémoire est un extrait des journaux de connexion de l’application [nom], fourni par l’entreprise d’accueil sous accord écrit du [date], limité à une période de [durée] et à un échantillon de [N] comptes utilisateurs sélectionnés aléatoirement. Les identifiants de compte ont été remplacés par un identifiant haché non réversible, sans conservation de table de correspondance. Les variables d’âge et de localisation ont été généralisées respectivement en tranches de dix ans et à l’échelle régionale, garantissant un k-anonymat minimal de 5 sur ces deux variables combinées. Aucune donnée individuelle brute n’apparaît dans les annexes du présent mémoire. »
Ce niveau de précision — techniques nommées, garanties mesurables, traçabilité de l’accord — est ce qu’un jury d’informatique attend désormais systématiquement dès lors qu’un mémoire manipule des données réelles, et ce qu’une simple mention « les données ont été anonymisées » ne satisfait jamais.
Questions fréquentes
Peut-on publier un mémoire d’informatique contenant des extraits de données réelles d’entreprise ?
Seulement après anonymisation robuste et avec l’accord explicite du responsable de traitement de l’entreprise. Un mémoire déposé dans une bibliothèque universitaire ou une archive institutionnelle constitue une diffusion au sens du RGPD, même à audience académique restreinte.
Le scraping de données publiques dispense-t-il du RGPD ?
Non. Le fait qu’une donnée soit publiquement accessible ne la fait pas sortir du champ d’application du RGPD dès lors qu’elle concerne une personne identifiable. Respectez en plus les conditions d’utilisation de la plateforme source, qui peuvent interdire ou encadrer la collecte automatisée.
Une donnée pseudonymisée peut-elle être considérée comme anonyme dans un mémoire ?
Non. Tant qu’une table de correspondance permettant de remonter à l’identité réelle existe, même non consultée, la donnée reste personnelle au sens du RGPD. Seule une anonymisation démontrée irréversible fait sortir le jeu de données du champ d’application du règlement.
Faut-il une autorisation de la CNIL pour un mémoire d’informatique traitant des données personnelles ?
Dans la majorité des cas non, hors traitement de données de santé qui suit des méthodologies de référence spécifiques. Une déclaration ou autorisation préalable systématique auprès de la CNIL a été supprimée pour la plupart des traitements depuis l’entrée en application du RGPD, qui responsabilise le porteur du traitement plutôt qu’il n’impose une formalité préalable. Consultez néanmoins le DPO de votre établissement dès que votre corpus comporte des données sensibles ou un volume important de données personnelles.
Structurez votre chapitre méthode avec Tesify
Tesify aide à rédiger la partie méthode d’un mémoire d’informatique : description du jeu de données, procédure d’anonymisation retenue et justification des choix éthiques, dans un format conforme aux attentes du jury.