Catégorie : Tutoriels

  • Comment numéroter les pages d’un mémoire à partir de l’introduction sur Word en 2026 (tutoriel pas à pas)

    Comment numéroter les pages d’un mémoire à partir de l’introduction sur Word en 2026 (tutoriel pas à pas)

    Comment numéroter les pages d’un mémoire à partir de l’introduction sur Word en 2026 (tutoriel pas à pas)

    Votre mémoire affiche «1» sur la page de garde, ou l’introduction porte le numéro «4» parce que les pages de remerciements comptent dans la numérotation : c’est l’une des erreurs de mise en page les plus souvent relevées par les directeurs de mémoire. La solution réside dans les sauts de section de Word — une fonctionnalité méconnue qui permet de numéroter les pages à partir de l’introduction tout en appliquant des chiffres romains aux pages liminaires et en supprimant le numéro sur la page de garde.

    Ce tutoriel vous guide pas à pas, de l’insertion des sauts de section jusqu’au résultat final, sur Word Windows et Word Mac, en 2026.

    Résumé en trois points : Pour numéroter les pages à partir de l’introduction sur Word, insérez deux sauts de section «Page suivante» (après la page de garde, puis après les pages liminaires), désactivez «Lier au précédent» dans le pied de page de chaque nouvelle section, puis configurez indépendamment la numérotation de chaque section — chiffres romains pour les pages liminaires, numérotation arabe commençant à «1» pour l’introduction.

    Pourquoi les sauts de section sont indispensables

    Par défaut, Word traite votre document comme un bloc continu et applique la même numérotation du début à la fin. Pour obtenir des styles de numérotation différents selon les parties — ou pour supprimer complètement les numéros sur certaines pages — vous devez diviser le document en sections indépendantes.

    Chaque section dispose de son propre pied de page, que vous pouvez paramétrer séparément. La clé est de couper le lien entre les sections («Lier au précédent»), sinon toute modification se propage à l’ensemble du document et annule vos réglages.

    Important : N’utilisez pas un simple «Saut de page» (Ctrl + Entrée). Seul un Saut de section – Page suivante crée une section indépendante avec son propre pied de page.

    Structure cible d’un mémoire bien numéroté

    Avant d’insérer quoi que ce soit, visualisez le résultat attendu :

    Partie du mémoire Section Word Numérotation
    Page de garde Section 1 Aucune
    Remerciements, avant-propos, sommaire, listes Section 2 i, ii, iii, iv…
    Introduction → corps → conclusion → bibliographie → annexes Section 3 1, 2, 3…
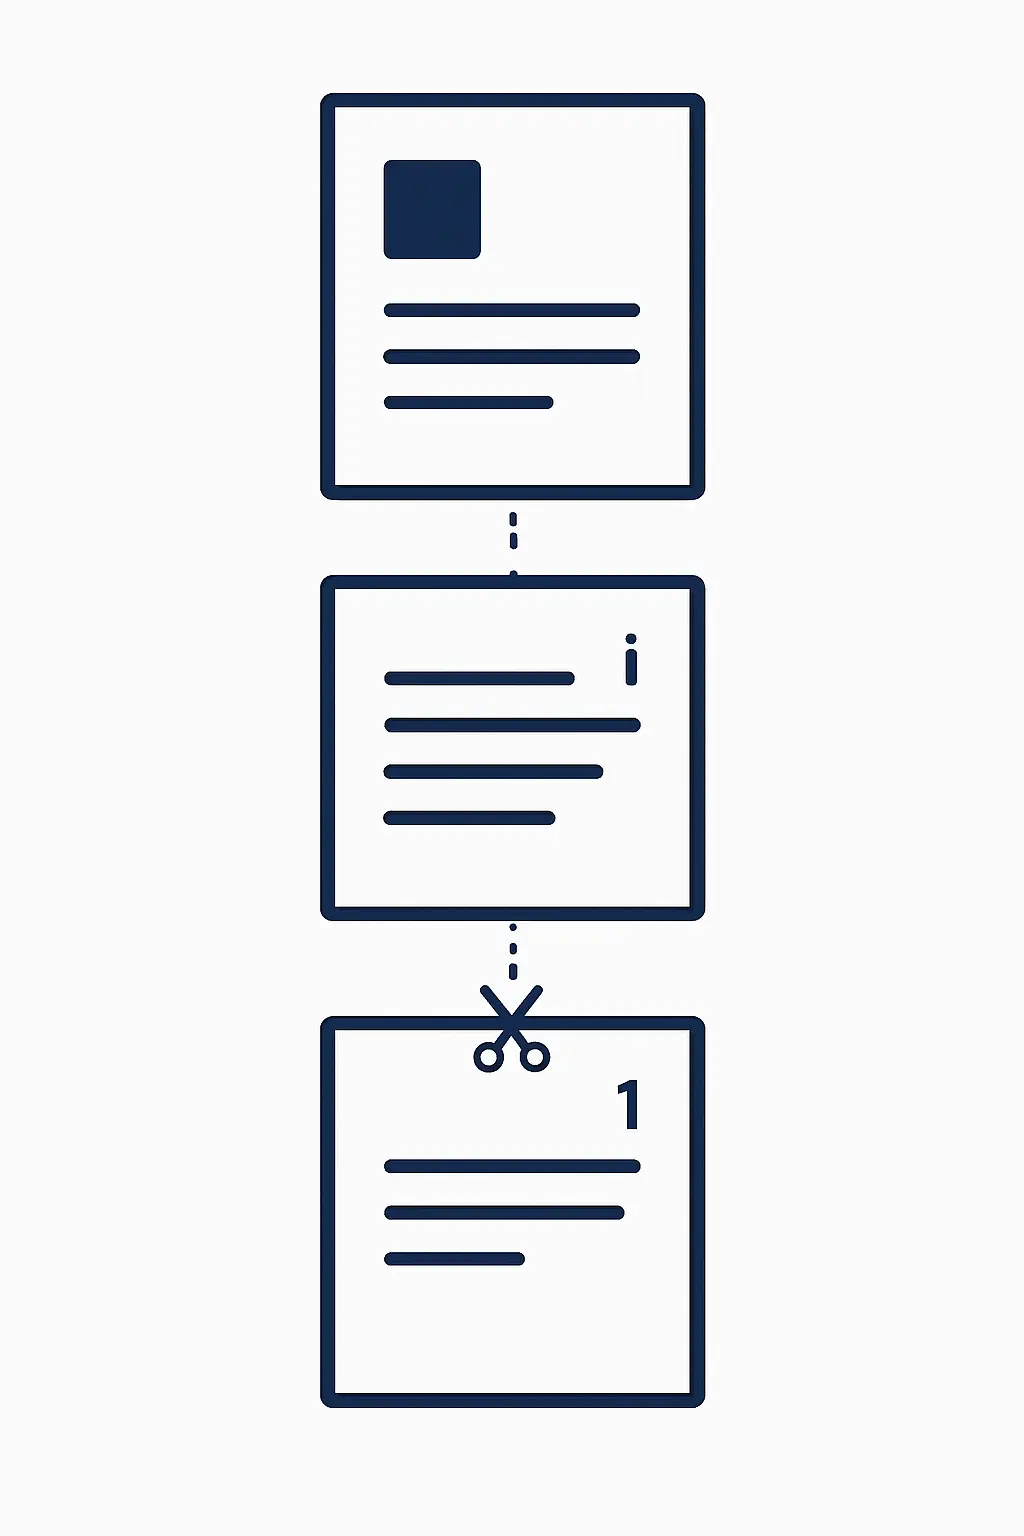
    Schéma des trois sections d'un mémoire Word : page de garde sans numéro, pages liminaires en chiffres romains (i, ii, iii) et corps du mémoire numéroté à partir de 1 — séparées par des sauts de section
    Les trois sections d’un mémoire Word bien numéroté : page de garde (aucun numéro), pages liminaires (chiffres romains i, ii, iii) et corps du texte numéroté à partir de 1 dès l’introduction

    Étape 1 — Insérer les sauts de section aux bons endroits

    Vous devez insérer deux sauts de section : un après la page de garde, un second après la dernière page liminaire, juste avant l’introduction.

    1. Placez le curseur à la toute fin du contenu de la page de garde (après le dernier texte ou tableau, avant toute autre page).
    2. Dans le ruban, allez dans Mise en page → Sauts → Sauts de section → Page suivante.
      (Word 365 : l’onglet s’intitule parfois «Disposition» au lieu de «Mise en page».)
    3. Placez ensuite le curseur à la fin de la dernière page liminaire (après le sommaire ou la liste des abréviations, avant la première ligne de l’introduction).
    4. Répétez : Mise en page → Sauts → Sauts de section → Page suivante.

    Pour vérifier que les sauts sont bien en place, activez l’affichage des marques de mise en forme via Accueil → ¶ (ou Ctrl + Maj + 8 sur Windows). La mention «Saut de section (page suivante)» doit apparaître entre chaque partie.

    Conseil : Insérez tous vos sauts de section en premier, avant de configurer la numérotation. Modifier les sauts après coup peut réinitialiser les réglages de pied de page et vous obliger à recommencer les étapes suivantes.

    Étape 2 — Dissocier «Lier au précédent» dans chaque pied de page

    C’est l’étape que la majorité des étudiants oublient — et qui fait échouer toute la configuration.

    1. Double-cliquez sur le pied de page de la première page de la Section 2 (la première page liminaire après la page de garde). Le ruban bascule sur l’onglet «En-tête et pied de page».
    2. Repérez le bouton «Lier au précédent» dans cet onglet. S’il est activé (surligné ou enfoncé), la mention «Identique au précédent» s’affiche dans le pied de page.
    3. Cliquez sur «Lier au précédent» pour le désactiver. La mention «Identique au précédent» disparaît : les deux sections sont maintenant indépendantes.
    4. Répétez exactement la même manipulation sur le pied de page de la première page de la Section 3 (votre page d’introduction).

    Une fois cette étape réalisée pour les deux sections, vous pouvez configurer la numérotation de chacune sans que les modifications se propagent aux autres.

    Étape 3 — Chiffres romains pour les pages liminaires (Section 2)

    Restez dans le pied de page de la Section 2 (ou double-cliquez dessus si vous l’avez fermé).

    1. Dans l’onglet «En-tête et pied de page», cliquez sur Numéro de page → Bas de page et choisissez un style centré (par exemple «Numéro de page 2»).
    2. Cliquez ensuite sur Numéro de page → Format des numéros de page…
    3. Dans la boîte de dialogue, sous «Format de numéro», sélectionnez i, ii, iii, … (chiffres romains en minuscules).
    4. Sous «Numérotation des pages», cochez «À partir de :» et entrez i.
    5. Cliquez sur OK.

    Les pages de remerciements, sommaire et listes affichent maintenant i, ii, iii… La page de garde reste vierge : la Section 1 ne contient aucun champ de numérotation.

    Étape 4 — Numérotation arabe à partir de l’introduction (Section 3)

    Double-cliquez sur le pied de page de la première page de la Section 3 — votre page d’introduction. Vérifiez que «Lier au précédent» est bien désactivé.

    1. Cliquez sur Numéro de page → Bas de page et choisissez le même style qu’en Section 2 pour une cohérence visuelle.
    2. Cliquez sur Numéro de page → Format des numéros de page…
    3. Sous «Format de numéro», sélectionnez 1, 2, 3, …
    4. Sous «Numérotation des pages», cochez «À partir de :» et entrez 1.
    5. Cliquez sur OK.

    L’introduction porte désormais le numéro «1». La numérotation se poursuit automatiquement jusqu’à la fin du document. Si certaines parties de votre mémoire nécessitent encore des ajustements de marges ou de styles, notre guide formater un mémoire sur Word (interlignes, marges et styles 2026) couvre ces paramètres en détail.

    Une fois les numéros de page configurés, l’étape naturelle est la génération de votre table des matières : consultez notre tutoriel table des matières automatique sur Word pour un mémoire pour synchroniser les numéros avec votre sommaire.

    Étape 5 — Masquer le numéro sur la page de garde

    Deux méthodes permettent d’obtenir une page de garde sans numéro visible :

    • Méthode A (recommandée) : Ne jamais insérer de numérotation dans la Section 1. Si vous avez suivi les étapes précédentes sans toucher au pied de page de la Section 1, la page de garde est automatiquement vierge de tout numéro.
    • Méthode B — «Première page différente» : Si votre document comporte une seule section, double-cliquez sur le pied de page de la page de garde, cochez «Première page différente» dans l’onglet En-tête et pied de page, puis supprimez le champ de numéro qui reste sur cette première page. Attention : cette option ne gère pas les chiffres romains et ne remplace pas les sauts de section pour un document complet.

    Word Windows vs Word Mac : différences d’interface

    La procédure est identique sur les deux plateformes. Les seules différences sont cosmétiques :

    Action Word Windows / 365 Word Mac
    Sauts de section Mise en page → Sauts → Page suivante Disposition → Sauts → Page suivante
    Format numéros de page Insertion → Numéro de page → Format… Insertion → Numéros de page → Format…
    Afficher marques ¶ Accueil → ¶ ou Ctrl + Maj + 8 Accueil → ¶ ou ⌘ + 8
    Lier au précédent Onglet «En-tête et pied de page» → bouton dédié Même onglet ; parfois libellé «Identique au précédent»

    Word 365 en ligne (navigateur) : les sauts de section ne sont pas disponibles dans l’éditeur web. Ouvrez impérativement le document dans l’application de bureau pour appliquer cette configuration.

    Erreurs fréquentes et comment les corriger

    L’introduction porte le numéro «4» au lieu de «1»
    Vous n’avez pas coché «À partir de : 1» dans «Format des numéros de page» pour la Section 3. Double-cliquez sur le pied de page de l’introduction, rouvrez le format et corrigez la valeur de départ.
    La modification en Section 3 affecte aussi la Section 2
    «Lier au précédent» est encore actif dans le pied de page de la Section 3. Désactivez-le avant de modifier la numérotation (voir Étape 2).
    La suppression d’un saut de section efface mes réglages
    Un saut de section porte les paramètres de mise en page de la section précédente. Sa suppression fusionne les deux sections et les réglages de la section absorbée disparaissent. Recréez le saut et reconfigurez le pied de page dissocié.
    La page de garde affiche encore un numéro
    La Section 1 contient probablement un numéro inséré manuellement. Double-cliquez sur le pied de page de la page de garde, sélectionnez le champ de numérotation et supprimez-le.
    Les chiffres romains s’affichent en majuscules (I, II, III)
    Dans «Format des numéros de page», vérifiez que vous avez sélectionné i, ii, iii (minuscules) et non I, II, III. La majorité des guides de rédaction universitaires français préconisent les minuscules pour les pages liminaires.

    Si votre mémoire inclut des figures ou des tableaux avec leur propre numérotation, sachez que celle-ci est entièrement indépendante des numéros de page. Notre tutoriel sur la liste des tableaux et figures automatique sur Word vous explique comment la configurer séparément.
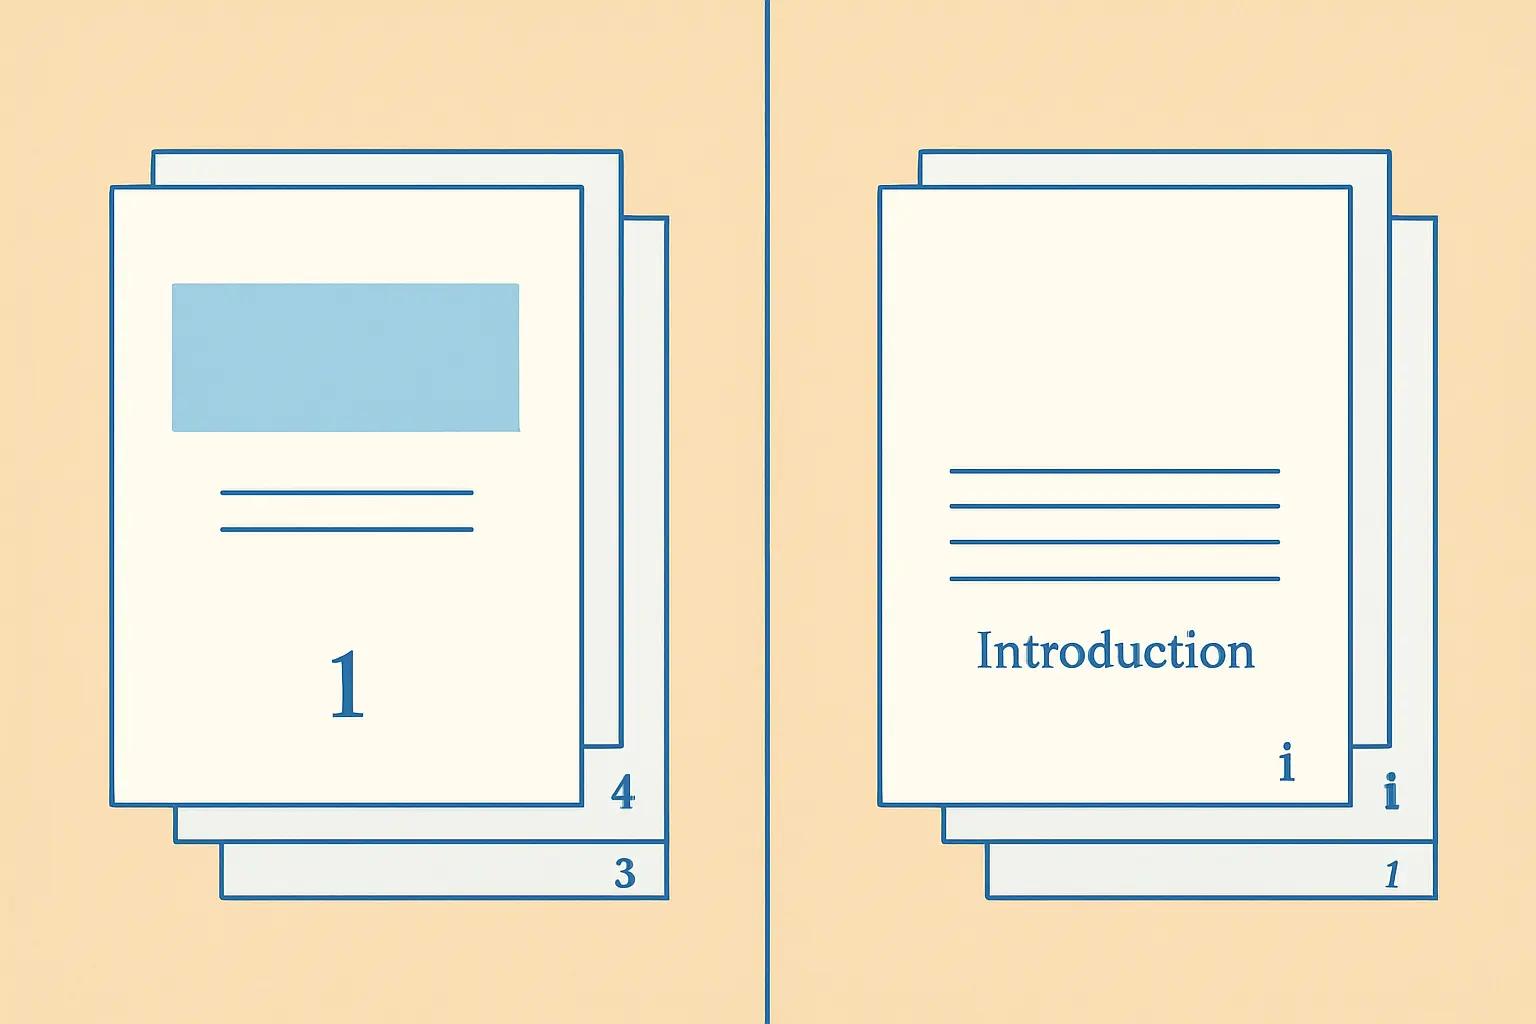
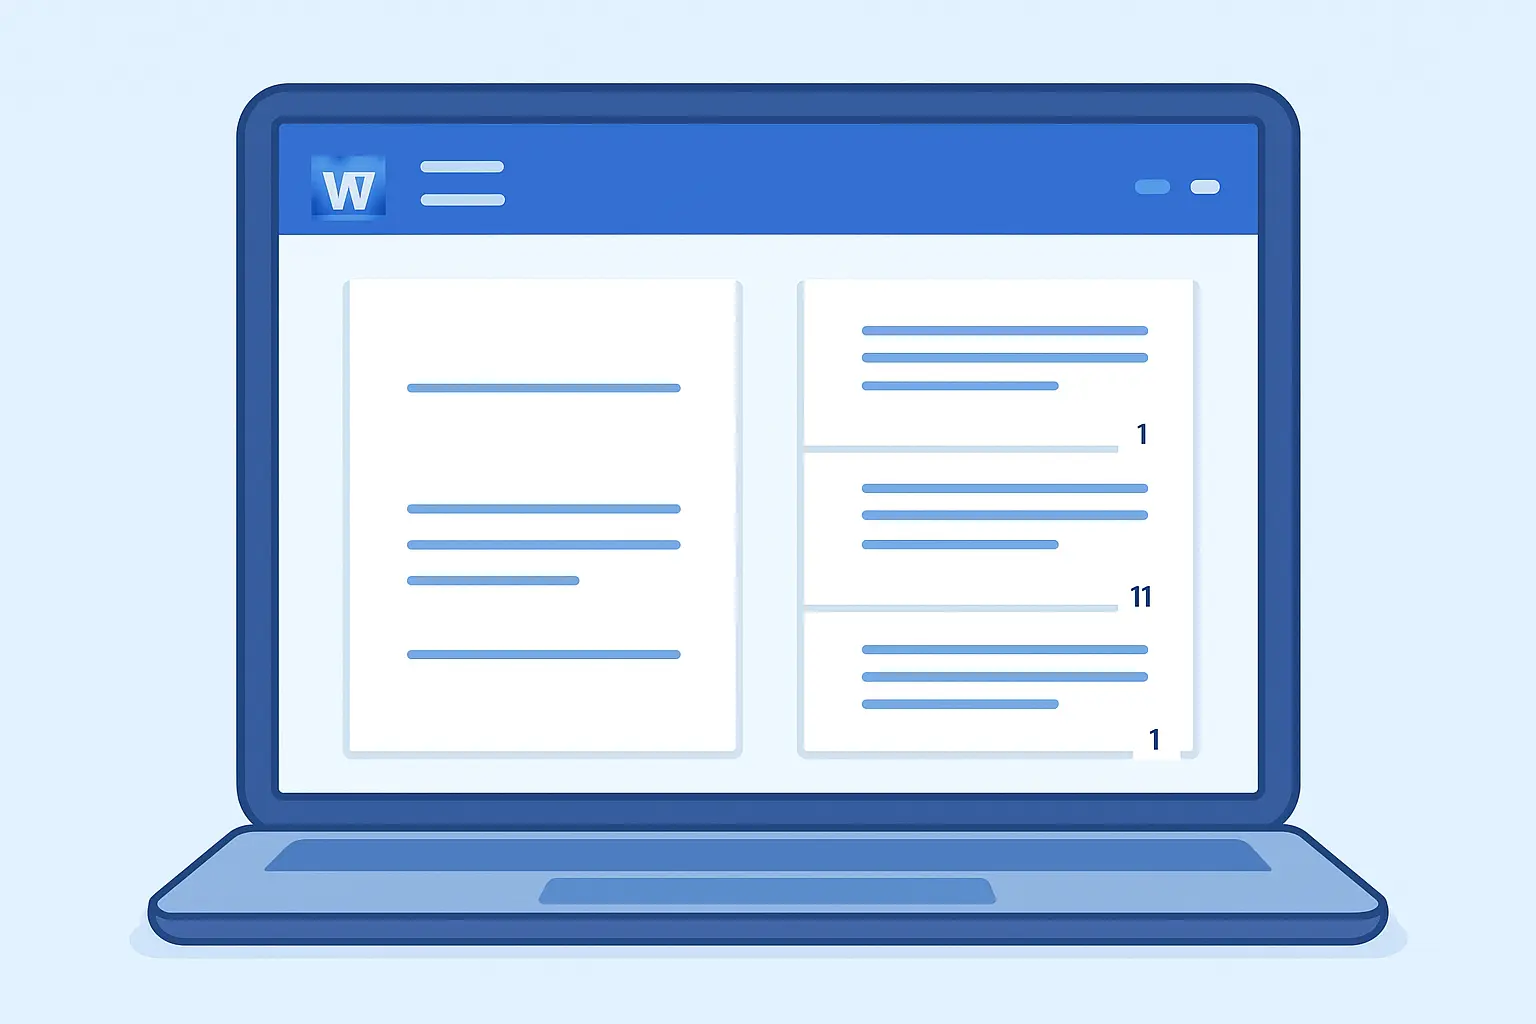
    Comparaison avant/après d'une numérotation de pages dans un mémoire Word : à gauche, numérotation incorrecte commençant sur la page de garde ; à droite, numérotation correcte avec chiffres romains pour les pages liminaires et numérotation arabe démarrant à 1 dès l'introduction
    Avant / après : numérotation incorrecte (page de garde numérotée «1», pages liminaires comptées) vs numérotation corrigée (page de garde sans numéro, chiffres romains i/ii/iii, introduction à partir de 1)

    Préparez votre mémoire sereinement avec Tesify. Avant de peaufiner la mise en page sur Word, assurez-vous que votre texte est solide, original et bien structuré. Essayez Tesify gratuitement →

    Questions fréquentes

    Faut-il obligatoirement utiliser des chiffres romains pour les pages liminaires ?

    Ce n’est pas une règle universelle, mais c’est la convention la plus répandue dans les universités françaises. Les chiffres romains en minuscules (i, ii, iii) indiquent que ces pages précèdent le corps principal du mémoire. Certains établissements demandent que les pages liminaires ne portent aucun numéro visible. Consultez toujours le guide de rédaction de votre université avant de finaliser votre choix.

    La numérotation doit-elle se poursuivre dans les annexes ?

    Par défaut, la numérotation continue sans interruption de l’introduction jusqu’aux annexes — c’est l’usage le plus fréquent. Certaines universités demandent que les annexes soient numérotées de façon distincte (ex. : Annexe A — p. 1). Dans ce cas, créez une Section 4 débutant après la bibliographie, dissociez-la et paramétrez une nouvelle numérotation indépendante.

    Puis-je appliquer cette méthode dans Google Docs ?

    Non. Google Docs ne gère pas les sauts de section au sens Word du terme et ne permet pas de configurer des numérotations différentes dans un même document. Pour une mise en page professionnelle conforme aux exigences universitaires, utilisez Microsoft Word (version bureau) ou LibreOffice Writer.

    Comment procéder si mon mémoire est réparti sur plusieurs fichiers Word ?

    Fusionnez d’abord tous les fichiers en un seul document via Insertion → Objet → Texte d’un fichier (Word Windows) ou par copier-coller soigné (Word Mac). Une fois le document réuni, appliquez les cinq étapes de ce tutoriel. Travailler sur un document fragmenté rend la gestion des sections et des pieds de page extrêmement difficile.

    La méthode fonctionne-t-elle avec LibreOffice Writer ?

    LibreOffice Writer utilise des «Styles de page» plutôt que des sauts de section. La logique est identique : créez un style «Liminaires» (numérotation romaine) et un style «Corps» (numérotation arabe démarrant à 1), puis appliquez-les via Insertion → Saut → Insérer un saut de page avec style. Le résultat final est équivalent à la méthode Word décrite ici.

    Où positionner le numéro de page : en bas ou en haut ?

    La grande majorité des universités françaises acceptent les deux positions. Le pied de page centré est le choix le plus courant et le plus sobre. Vérifiez la charte graphique de votre université : certaines imposent le numéro en haut à droite (en-tête). La procédure de configuration est identique, à ceci près que vous ouvrez l’en-tête plutôt que le pied de page à chaque étape.

    Pour une vue comparative des techniques de numérotation avancées — numérotation discontinue, sauts multiples, documents longs — le guide numéroter les pages d’un mémoire sur Word 2026 détaille les configurations les plus complexes.
  • Comment Calculer la Taille de son Échantillon avec G*Power : Tutoriel Pas à Pas 2026

    Comment Calculer la Taille de son Échantillon avec G*Power : Tutoriel Pas à Pas 2026

    Comment Calculer la Taille de son Échantillon avec G*Power : Tutoriel Pas à Pas 2026

    Votre directeur de mémoire vous demande de justifier votre taille d’échantillon — et vous ne savez pas par où commencer. C’est l’une des questions les plus fréquentes en méthodologie quantitative : combien de répondants faut-il recruter pour que vos résultats soient statistiquement valides ? G*Power est le logiciel gratuit de référence pour répondre à cette question, utilisé dans des milliers de mémoires et d’articles scientifiques chaque année. Ce tutoriel pas à pas vous guide depuis le téléchargement jusqu’à la formulation dans votre section méthodologie.

    Calculer la taille de son échantillon avec G*Power n’exige aucune compétence avancée en statistiques. Il suffit de connaître trois paramètres — le niveau de signification, la puissance souhaitée et la taille d’effet anticipée — pour obtenir en quelques clics le nombre minimum de participants à recruter. Ce guide couvre les tests les plus courants dans les mémoires de master : t-test, ANOVA, corrélation et régression linéaire.

    Réponse rapide

    Pour calculer la taille d’échantillon avec G*Power : téléchargez le logiciel gratuitement sur psychologie.hhu.de, choisissez votre test statistique, saisissez α = 0,05, puissance = 0,80 et la taille d’effet de Cohen correspondante (petite, moyenne ou grande), puis cliquez sur « Calculate ». G*Power affiche directement le nombre total de participants nécessaires dans le champ « Total sample size ».

    1. Les notions clés : puissance, alpha et taille d’effet

    Avant d’ouvrir G*Power, il faut maîtriser trois paramètres fondamentaux. Ces concepts sont directement ceux que le logiciel vous demandera de renseigner.

    Le niveau de signification α (alpha)

    Alpha correspond au risque d’erreur de type I : la probabilité de rejeter l’hypothèse nulle alors qu’elle est vraie (faux positif). La convention scientifique internationale fixe α = 0,05, c’est-à-dire un risque de 5 %. Dans certaines disciplines médicales ou pharmaceutiques, on descend à α = 0,01 pour plus de rigueur. Dans les mémoires de master en sciences humaines et sociales, α = 0,05 est le seuil standard attendu par les jurys.

    La puissance statistique (1 − β)

    La puissance est la probabilité de détecter un effet réel lorsqu’il existe. β représente le risque d’erreur de type II (faux négatif) : manquer un effet qui existe pourtant. La convention minimale recommandée par Jacob Cohen est une puissance de 0,80, c’est-à-dire 80 % de chances de détecter un effet si celui-ci est présent dans la population. Certaines disciplines visent 0,90, mais 0,80 est généralement acceptable pour un mémoire de master.

    La taille d’effet

    La taille d’effet mesure l’ampleur du phénomène étudié, indépendamment de la taille de l’échantillon. Cohen a défini des conventions par type de test, largement utilisées lorsque vous n’avez pas d’estimation préalable :

    Test Indice Petit Moyen Grand
    t-test (2 groupes) d de Cohen 0,20 0,50 0,80
    ANOVA f de Cohen 0,10 0,25 0,40
    Corrélation (r) r de Pearson 0,10 0,30 0,50
    Régression linéaire (R²) f² de Cohen 0,02 0,15 0,35
    Diagramme illustrant les conventions de taille d'effet de Cohen selon le type de test statistique : petite, moyenne et grande taille d'effet pour t-test, ANOVA, corrélation et régression
    Conventions de taille d’effet de Cohen par type de test statistique — repères à utiliser en l’absence d’étude de référence dans votre domaine

    Conseil pratique : si vous avez accès à des études similaires dans votre domaine, utilisez leur taille d’effet rapportée plutôt que les conventions de Cohen — votre calcul sera plus précis et mieux reçu par le jury.

    Pour approfondir la réflexion sur la taille d’échantillon en lien avec le type d’approche, consultez ce guide sur la taille d’échantillon qualitatif vs quantitatif.

    Étape 1 — Télécharger et ouvrir G*Power

    G*Power est un logiciel gratuit développé par l’Université Heinrich-Heine de Düsseldorf (Allemagne). Il fonctionne sur Windows et macOS (Intel). Voici comment procéder :

    1. Rendez-vous sur psychologie.hhu.de (section G*Power) ou cherchez « G*Power HHU download » dans votre navigateur. La version actuelle est G*Power 3.1.9.6.
    2. Téléchargez le fichier correspondant à votre système : GPower_3_1_9_6.zip pour Windows, ou le fichier .dmg pour macOS.
    3. Décompressez (Windows) ou montez le disque virtuel (macOS), puis lancez l’exécutable. Aucune installation complexe n’est requise : G*Power s’ouvre directement.
    4. L’interface s’affiche avec deux zones principales : Test family en haut (famille de tests : F, t, χ², z) et Statistical test (test précis). Sur la gauche : les champs de paramètres d’entrée. Sur la droite : les résultats.
    Note macOS Apple Silicon (M1/M2/M3) : G*Power 3.1.9.6 a été compilé pour processeurs Intel. Il fonctionne via Rosetta 2, automatiquement activé sous macOS Ventura et versions ultérieures. Aucune manipulation supplémentaire n’est nécessaire.

    Étape 2 — Choisir le bon test statistique

    G*Power couvre des dizaines de tests statistiques. Pour un mémoire de master en sciences humaines, sociales ou de gestion, les quatre familles suivantes couvrent la grande majorité des besoins :

    t-test indépendant (comparer deux groupes)

    Utilisez-le si vous comparez deux groupes distincts (ex. : femmes vs hommes sur un score d’engagement). Dans G*Power : Test family → t tests, puis Statistical test → Means: Difference between two independent means (two groups).

    ANOVA one-way (comparer trois groupes ou plus)

    Utilisez-le si vous comparez plus de deux groupes (ex. : trois niveaux d’expérience). Dans G*Power : Test family → F tests, puis Statistical test → ANOVA: Fixed effects, omnibus, one-way.

    Corrélation de Pearson

    Utilisez-la pour tester l’association linéaire entre deux variables continues. Dans G*Power : Test family → t tests, puis Statistical test → Correlation: Point biserial model ou Bivariate normal model selon votre cas.

    Régression linéaire multiple

    Utilisez-la lorsque vous prédisez une variable continue à partir de plusieurs prédicteurs. Dans G*Power : Test family → F tests, puis Statistical test → Linear Multiple Regression: Fixed model, R² deviation from zero.

    La sélection du bon test dans G*Power conditionne la pertinence du calcul. Si vous hésitez sur le type d’analyse adapté à vos données, le guide Méthodologie quantitative pour un mémoire de master vous aidera à choisir. Pour une introduction complète aux méthodes quantitatives, qualitatives et mixtes, consultez également le guide sur la méthodologie de recherche 2026.

    Étape 3 — Saisir les paramètres (α, puissance, taille d’effet)

    Une fois le test sélectionné, vérifiez que le Type of power analysis est réglé sur A priori: Compute required sample size. C’est le mode de référence pour planifier une étude avant de collecter vos données.

    Renseignez ensuite les champs Input Parameters :

    1. Effect size — saisissez la valeur de la taille d’effet selon le test choisi (voir tableau ci-dessus). Par défaut, entrez la valeur « moyenne » de Cohen si vous n’avez pas de référence dans la littérature.
    2. α err prob — saisissez 0.05 (risque d’erreur de type I de 5 %).
    3. Power (1 − β err prob) — saisissez 0.80 (puissance minimale recommandée).
    4. Pour les tests nécessitant d’autres paramètres :
      • t-test : Allocation ratio N2/N1 = 1 (groupes de taille égale). Choisir Two-tailed sauf si votre hypothèse est directionnelle.
      • ANOVA : Number of groups = nombre de groupes à comparer.
      • Régression : Number of predictors = nombre de variables indépendantes dans votre modèle.
    Exemples illustratifs (données fictives à titre pédagogique, non issues d’une étude publiée)

    • t-test, d = 0,50, α = 0,05, puissance = 0,80, bilatéral → G*Power indique environ 64 participants par groupe (128 au total).
    • ANOVA à 3 groupes, f = 0,25, α = 0,05, puissance = 0,80 → G*Power indique environ 52 participants par groupe (156 au total).
    • Corrélation, r = 0,30, α = 0,05, puissance = 0,80, bilatéral → G*Power indique environ 84 participants.
    • Régression multiple, 3 prédicteurs, f² = 0,15, α = 0,05, puissance = 0,80 → G*Power indique environ 77 participants.
    Illustration de l'interface G*Power montrant les paramètres d'entrée (alpha, puissance, taille d'effet) et le résultat de calcul de la taille d'échantillon
    Interface G*Power : panneau des paramètres d’entrée (α, puissance, taille d’effet) et affichage du résultat Total sample size avec courbe de puissance

    Étape 4 — Lire et interpréter le résultat

    Après avoir saisi vos paramètres, cliquez sur le bouton Calculate. La zone Output Parameters affiche immédiatement les résultats :

    • Total sample size : le nombre total de participants à recruter. C’est la valeur à retenir.
    • Actual power : la puissance réelle obtenue avec l’échantillon arrondi (légèrement supérieure ou égale à la puissance cible).
    • Critical t / F / z : la valeur critique du test (utile pour l’interprétation des résultats, pas pour le calcul d’effectif).

    G*Power génère également un graphique de puissance dans l’onglet « Power curve for a priori analyses ». Ce graphique montre comment la puissance évolue en fonction de la taille d’échantillon pour vos paramètres — très utile pour visualiser les compromis si vous avez des contraintes de recrutement.

    Une fois votre taille d’échantillon calculée, pensez à croiser cette information avec votre méthode de collecte. Si vous administrez un questionnaire en ligne, le guide sur comment diffuser son questionnaire et améliorer le taux de réponse vous donnera des repères sur les taux de retour à anticiper selon le canal.

    Étape 5 — Ajuster pour l’attrition et les données manquantes

    Le nombre fourni par G*Power correspond au minimum de participants exploitables dans l’analyse finale. Dans la pratique, une partie des réponses sera incomplète, des questionnaires seront mal remplis, et certains participants abandonnent en cours de route. Il faut donc recruter davantage.

    La formule d’ajustement est simple :

    N_recruter = N_gpower / (1 − taux_attrition_estimé)

    Le taux d’attrition à retenir dépend de votre contexte :

    • Questionnaire en ligne distribué au réseau personnel : prévoyez 20 à 30 % de réponses inutilisables.
    • Questionnaire distribué en présentiel : 5 à 10 % suffisent généralement.
    • Étude longitudinale ou expérimentale : l’attrition peut atteindre 30 à 50 % selon la durée.

    Exemple illustratif (non issu d’une étude publiée) : G*Power indique un minimum de 128 participants pour un t-test. Avec un questionnaire en ligne et un taux d’attrition estimé à 25 %, vous devrez distribuer votre questionnaire à au moins 171 personnes (128 / 0,75 ≈ 171).

    Sur les stratégies d’échantillonnage (probabiliste, raisonné, boule de neige), consultez ce guide sur les méthodes d’échantillonnage pour mémoire de master.

    Étape 6 — Rapporter le calcul dans votre mémoire

    La justification de la taille d’échantillon doit figurer dans la section Participants ou Procédure de votre chapitre méthodologie. Le jury s’attend à voir trois informations : le logiciel utilisé, les paramètres saisis et le résultat obtenu.

    Formulation type (à adapter à votre contexte)

    « La taille d’échantillon a été déterminée à l’aide du logiciel G*Power 3.1.9.6 (Faul et al., 2007). Pour un t-test bilatéral avec un niveau de signification de α = 0,05, une puissance de 0,80 et une taille d’effet moyenne (d de Cohen = 0,50), le calcul a priori indique un minimum de 128 participants (64 par groupe). Afin de compenser un taux d’attrition estimé à 20 %, nous avons recruté 160 participants. »

    La référence à citer pour G*Power est :

    Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146

    Si votre mémoire s’appuie sur une analyse multivariée plus complexe, le guide Comment analyser ses données quantitatives avec SPSS ou Excel vous donnera les étapes suivantes, une fois votre collecte terminée.

    Erreurs fréquentes à éviter

    G*Power est simple à prendre en main, mais certaines erreurs reviennent systématiquement dans les mémoires. Voici les plus courantes :

    1. Choisir le mauvais type d’analyse de puissance. G*Power propose cinq modes différents (A priori, Post hoc, Criterion, Sensitivity, Compromise). Pour planifier une étude avant la collecte, utilisez toujours A priori. Le mode Post hoc — utilisé pour calculer la puissance après coup — donne des résultats différents et ne justifie pas une taille d’échantillon a posteriori.
    2. Utiliser la mauvaise taille d’effet par défaut. Certains étudiants entrent d = 0,80 (grande taille d’effet) pour minimiser l’effectif requis. Cela produit un échantillon trop petit si l’effet réel est moyen ou petit, et les résultats risquent de ne pas atteindre la significativité. Préférez une estimation conservatrice (petite ou moyenne) ou basez-vous sur la littérature existante.
    3. Oublier de préciser le nombre de groupes pour l’ANOVA. Le champ Number of groups est crucial : une ANOVA à 3 groupes ne donnera pas le même résultat qu’une ANOVA à 2 groupes, même avec les mêmes paramètres.
    4. Ne pas ajuster pour l’attrition. Fournir à votre jury le chiffre brut de G*Power sans mentionner l’ajustement donne l’impression que vous n’avez pas anticipé les réalités du terrain.
    5. Confondre « puissance » et « niveau de confiance ». La puissance (1 − β) n’est pas le niveau de confiance (1 − α). Ce sont deux concepts distincts. La puissance mesure la sensibilité du test à détecter un effet ; le niveau de confiance mesure la fiabilité d’une estimation.
    6. Ne pas citer G*Power dans la bibliographie. G*Power est un outil scientifique cité par des dizaines de milliers d’articles. L’omettre dans votre bibliographie est une erreur méthodologique aux yeux du jury.

    Questions fréquentes (FAQ)

    G*Power est-il gratuit et fiable pour un mémoire de master ?

    Oui. G*Power est un logiciel entièrement gratuit développé par l’Université Heinrich-Heine de Düsseldorf et disponible sur psychologie.hhu.de. Il est cité dans des dizaines de milliers de publications scientifiques internationales et constitue la référence standard pour le calcul de taille d’échantillon en sciences humaines et sociales. Son utilisation dans un mémoire de master est tout à fait appropriée et appréciée par les jurys.

    Quelle taille d’effet choisir si je n’ai aucune étude de référence ?

    Sans étude préalable dans votre domaine, utilisez les conventions de Cohen pour une taille d’effet moyenne : d = 0,50 pour un t-test, f = 0,25 pour une ANOVA, r = 0,30 pour une corrélation, f² = 0,15 pour une régression multiple. C’est le choix le plus neutre et le plus défendable devant un jury. Évitez délibérément la grande taille d’effet uniquement pour réduire l’effectif requis.

    Peut-on utiliser G*Power pour une analyse de régression logistique ?

    Oui. G*Power propose un module dédié à la régression logistique : Test family → z tests → Logistic regression. Ce module demande des paramètres supplémentaires (proportion de la variable dépendante dans chaque groupe, odds ratio anticipé). Si vous ne disposez d’aucune estimation, une revue de la littérature dans votre domaine est vivement recommandée avant d’utiliser ce module.

    Comment justifier une taille d’échantillon inférieure à celle calculée par G*Power ?

    Si votre population est restreinte (ex. : une profession rare, un dispositif spécifique) ou si vos contraintes de temps et de budget limitent le recrutement, vous pouvez argumenter avec honnêteté : indiquez la puissance réelle obtenue avec votre effectif disponible (via le mode Post hoc de G*Power), reconnaissez la limite et expliquez pourquoi la collecte reste valide dans ce contexte exploratoire. Un jury comprend les contraintes du terrain à condition qu’elles soient clairement explicitées.

    Faut-il utiliser G*Power pour une approche qualitative ?

    Non. G*Power est conçu exclusivement pour les études quantitatives où des tests d’inférence statistique sont réalisés. En recherche qualitative, la taille d’échantillon est déterminée par le principe de saturation théorique (généralement 8 à 15 entretiens selon la méthode) et non par un calcul de puissance. Pour les approches qualitatives, référez-vous à votre cadre théorique et aux pratiques de votre discipline.

    G*Power fonctionne-t-il pour les tests non paramétriques ?

    G*Power propose quelques tests non paramétriques (notamment via la famille des tests exacts). Cependant, la couverture des tests non paramétriques est limitée comparée aux tests paramétriques. Pour des tests comme Mann-Whitney U ou Kruskal-Wallis, G*Power peut fournir une approximation en utilisant le test paramétrique équivalent avec un léger suréchantillonnage (règle pratique : multiplier la taille obtenue par 1,15 à 1,20 pour compenser la perte de puissance).

    Construisez votre méthodologie plus rapidement avec Tesify

    G*Power vous donne le chiffre — mais rédiger la section méthodologie complète (population, échantillon, instruments, procédure, plan d’analyse) reste une tâche longue et exigeante. Tesify est l’assistant IA spécialisé en rédaction académique qui vous aide à structurer et rédiger chaque section de votre mémoire selon les normes de votre discipline — de la problématique à la conclusion.

    Commencer gratuitement →

  • Comment analyser ses données quantitatives avec SPSS ou Excel pour un mémoire : tutoriel étape par étape (2026)

    Comment analyser ses données quantitatives avec SPSS ou Excel pour un mémoire : tutoriel étape par étape (2026)

    Comment analyser ses données quantitatives avec SPSS ou Excel pour un mémoire : tutoriel étape par étape (2026)

    Vous avez distribué votre questionnaire, récupéré vos réponses et vous vous retrouvez face à un tableur rempli de chiffres — sans savoir par où commencer. Analyser ses données quantitatives pour un mémoire de master est souvent l’étape qui génère le plus d’angoisse, non pas parce qu’elle est impossible, mais parce que personne n’a pris le temps de l’expliquer dans l’ordre. Ce tutoriel vous accompagne de la ligne brute dans Excel jusqu’à la phrase rédigée dans votre chapitre Résultats, en passant par le choix du bon test statistique dans SPSS.

    Que vous travailliez sur un mémoire de master 1 en sciences sociales, un master 2 en gestion ou une licence professionnelle, la même logique s’applique : nettoyer les données, choisir le bon test selon vos variables, lire les sorties du logiciel et traduire les chiffres en propos académique. Ce guide suit exactement cet enchaînement.

    En bref : Pour analyser vos données quantitatives dans un mémoire, commencez par nettoyer votre fichier Excel (doublons, valeurs manquantes, encodage), puis importez-le dans SPSS ou restez sous Excel selon la complexité de vos tests. Choisissez le test adapté à vos variables via le tableau de décision ci-dessous, interprétez le seuil de significativité (p < 0,05) et rédigez vos résultats en prose académique structurée.

    Étape 1 — Comment préparer et nettoyer vos données dans Excel

    Avant tout traitement statistique, vos données doivent être dans un état exploitable. Une base de données mal structurée produit des résultats erronés même si vous maîtrisez parfaitement votre logiciel. Prévoyez vingt à trente minutes pour cette phase de nettoyage, quelle que soit la taille de votre échantillon.

    Structurer le tableau de base

    Chaque ligne doit représenter un répondant ; chaque colonne, une variable. Nommez vos colonnes sans accents, sans espaces et sans caractères spéciaux (écrivez age, sexe, score_Q1) : SPSS refusera les noms non conformes à l’importation. Évitez les cellules fusionnées et les lignes de sous-titres intercalées dans les données.

    Supprimer les doublons

    Sous Excel, allez dans Données > Supprimer les doublons, sélectionnez les colonnes identifiantes (par exemple l’adresse e-mail ou l’identifiant de répondant) et confirmez. Pour un contrôle plus fin, utilisez Données > Filtre avancé avec l’option « Extraction sans doublons » vers une nouvelle plage, puis comparez les totaux avant/après.

    Traiter les valeurs manquantes

    Sélectionnez l’ensemble de votre plage, puis Ctrl+G > Cellules vides pour les mettre en évidence d’un seul coup. Selon leur proportion, vous avez trois options :

    • Moins de 5 % par variable : remplacer par la médiane (variables ordinales) ou la moyenne (variables métriques continues), en notant la procédure dans votre section méthode.
    • Entre 5 % et 15 % : envisager l’imputation multiple ou l’exclusion listwise selon le logiciel.
    • Plus de 15 % : signaler la limite dans votre mémoire et exclure la variable si elle n’est pas centrale.

    Standardiser l’encodage textuel

    Les variables catégorielles textuelles (« Homme », « homme », « HOMME ») doivent être uniformisées avant l’encodage numérique. Utilisez la formule =PROPER(cellule) pour homogénéiser la casse, =TRIM(cellule) pour éliminer les espaces superflus et =CLEAN(cellule) pour les caractères non imprimables issus d’exports de formulaires en ligne. Une fois uniformisé, convertissez chaque catégorie en code numérique (1 = Homme, 2 = Femme, 3 = Autre) dans une colonne dédiée : c’est cette colonne codée que vous importerez dans SPSS.

    Le guide de nettoyage de données proposé par DataCamp détaille également l’usage des mises en forme conditionnelles avec =ISERROR() pour repérer les cellules qui résistent à vos formules de nettoyage.

    Étape 2 — Comment importer vos données dans SPSS

    SPSS (IBM SPSS Statistics) accepte directement les fichiers Excel .xlsx. Voici la procédure standard pour 2026 :

    1. Enregistrez votre fichier Excel nettoyé (Fichier > Enregistrer sous > Classeur Excel) avec votre ligne d’en-têtes en ligne 1.
    2. Dans SPSS, allez dans Fichier > Ouvrir > Données, sélectionnez le type « Excel (*.xlsx) ».
    3. Cochez « Lire les noms de variables dans la première ligne » et ajustez la plage si nécessaire.
    4. Vérifiez dans l’onglet Vue des variables que chaque variable a le bon type (Numérique pour les codes, Chaîne pour les textes libres) et le bon niveau de mesure (Nominal, Ordinal ou Échelle).
    5. Renseignez les étiquettes de valeurs (ex. : 1 = « Homme », 2 = « Femme ») dans la colonne Valeurs : vos tableaux de sortie seront immédiatement lisibles.

    Rester sous Excel est une option valide pour les analyses simples (statistiques descriptives, corrélation de Pearson, t-test via l’Utilitaire d’analyse). SPSS devient indispensable dès que vous avez besoin d’une ANOVA à facteurs multiples, d’une régression linéaire avec diagnostics ou d’un test du khi-deux avec tableau de contingence complet. Le tutoriel de référence de Redaxio détaille l’ensemble des menus SPSS pour chaque test.

    Étape 3 — Comment choisir le bon test statistique

    Le choix du test dépend de deux critères : la nature de vos variables (nominales, ordinales, métriques) et votre question de recherche (décrire, comparer, associer, prédire). Le tableau suivant couvre les cas les plus fréquents en mémoire de master.

    Objectif Variable indépendante Variable dépendante Test recommandé SPSS : chemin de menu
    Décrire la distribution Nominale / Ordinale Effectifs et fréquences Analyse > Statistiques descriptives > Fréquences
    Décrire la distribution Métrique (continue) Moyenne, médiane, écart-type Analyse > Statistiques descriptives > Descriptives
    Lien entre deux variables catégorielles Nominale Nominale Khi-deux (χ²) Analyse > Stat. descriptives > Tableaux croisés > Statistiques
    Comparer deux groupes indépendants Nominale (2 modalités) Métrique t-test pour échantillons indépendants Analyse > Comparer les moyennes > Test t pour échantillons indépendants
    Comparer trois groupes ou plus Nominale (3+ modalités) Métrique ANOVA à un facteur Analyse > Comparer les moyennes > Analyse de variance à 1 facteur
    Lien entre deux variables métriques Métrique Métrique Corrélation de Pearson (ou Spearman si non-normale) Analyse > Corrélation > Bivariée
    Prédire une variable à partir d’une ou plusieurs Métrique(s) Métrique Régression linéaire Analyse > Régression > Linéaire

    Conseil pratique : avant tout test comparatif ou de corrélation, vérifiez la normalité de votre distribution avec le test de Shapiro-Wilk (Analyse > Explorer > Graphiques > Tests de normalité). Si la distribution est non-normale et votre échantillon inférieur à 30 répondants, utilisez les équivalents non-paramétriques : test de Mann-Whitney à la place du t-test, test de Kruskal-Wallis à la place de l’ANOVA, corrélation de Spearman à la place de Pearson.

    Pour dimensionner votre échantillon en amont, consultez notre guide sur la taille d’échantillon pour un mémoire qualitatif vs quantitatif — un t-test exige au minimum 30 répondants par groupe, une régression multiple entre 10 et 20 observations par prédicteur.

    Étape 4 — Comment réaliser les tests dans SPSS et Excel

    Dans SPSS : déroulement type

    1. Vérifier l’hypothèse de normalité : Analyse > Statistiques descriptives > Explorer, cochez « Tests de normalité avec graphiques ».
    2. Lancer le test principal en suivant le chemin indiqué dans le tableau de décision ci-dessus.
    3. Lire les tableaux de sortie dans la fenêtre Visionneur : chaque procédure produit plusieurs tableaux. Concentrez-vous sur la colonne « Sig. » (ou « p ») qui donne la probabilité observée.
    4. Vérifier les postulats du test (homogénéité des variances pour le t-test : si Levene p < 0,05, lisez la ligne « Hypothèse de variances inégales » ; pour l’ANOVA, vérifiez le test de Levene fourni en sortie).
    5. Exporter les tableaux vers Word via Fichier > Exporter dans le Visionneur (format .docx) ou par copier-coller direct.

    Dans Excel : Utilitaire d’analyse

    Si SPSS n’est pas disponible, activez l’Utilitaire d’analyse via Fichier > Options > Compléments > Compléments Excel > Utilitaire d’analyse. Vous trouverez ensuite sous Données > Analyse de données : statistiques descriptives, corrélation, régression, test t (deux échantillons supposés de variances égales ou inégales) et ANOVA à un facteur. La limitation principale d’Excel est l’absence de test de Shapiro-Wilk natif et de tableaux de contingence automatisés pour le khi-deux — pour ces analyses, SPSS (ou jamovi, gratuit) reste préférable.

    Cas pratique : comparer la satisfaction selon le statut professionnel

    Supposons que vous ayez mesuré la satisfaction au travail (score de 1 à 10) auprès de deux groupes : salariés en CDI et salariés en CDD. Votre objectif est de tester si les moyennes diffèrent significativement.

    • Variable indépendante : statut (nominale, 2 modalités) → t-test pour échantillons indépendants.
    • Dans SPSS : Analyse > Comparer les moyennes > Test t pour échantillons indépendants. Glissez satisfaction dans « Variable(s) de test », statut dans « Variable de regroupement », définissez les groupes (1 et 2).
    • Lisez le tableau « Test de Levene pour l’égalité des variances » : si p > 0,05, reportez-vous à la ligne « Hypothèse de variances égales » ; sinon à « Hypothèse de variances inégales ».
    • Note la valeur t, les degrés de liberté et la valeur Sig. (bilatérale).

    Étape 5 — Comment interpréter les résultats (p-value et intervalles de confiance)

    La valeur p (ou « Sig. » dans SPSS) exprime la probabilité d’observer un résultat au moins aussi extrême que celui obtenu si l’hypothèse nulle était vraie. La convention académique standard est :

    • p < 0,05 : résultat statistiquement significatif au seuil de 5 % — vous pouvez rejeter l’hypothèse nulle.
    • p < 0,01 : significatif au seuil de 1 % (résultat plus robuste).
    • p > 0,05 : absence de significativité statistique — ne signifie pas l’absence d’effet, mais que vos données ne permettent pas de le confirmer avec ce niveau de confiance.

    Les intervalles de confiance à 95 % sont systématiquement fournis par SPSS pour les différences de moyennes et les coefficients de régression. Un intervalle de confiance [IC 95 %] qui ne contient pas zéro confirme la significativité de l’effet. Préférez rapporter l’IC plutôt que de vous limiter à p : les jurys de master apprécient cette précision, car elle renseigne sur la taille et la direction de l’effet.

    Taille de l’effet : la significativité statistique ne renseigne pas sur l’importance pratique d’un effet. Complétez systématiquement par une mesure de taille d’effet :

    • Khi-deux → V de Cramér (disponible dans SPSS via Tableaux croisés > Statistiques > Phi et V de Cramér).
    • t-test → d de Cohen (calculer manuellement : différence des moyennes divisée par l’écart-type poolé).
    • ANOVA → η² (êta carré) ou ω² : dans SPSS, cochez « Estimation de la taille d’effet » dans les options de l’ANOVA.
    • Régression → R² (coefficient de détermination, affiché directement dans le tableau Récapitulatif du modèle).

    Pour aller plus loin sur la mise en forme des tableaux de résultats selon les normes APA 7, consultez notre guide sur comment présenter les résultats d’un mémoire avec des tableaux et figures.

    Étape 6 — Comment rédiger les résultats en prose académique

    La rédaction de la section Résultats suit une logique immuable : annoncer le test utilisé, rapporter les statistiques dans l’ordre conventionnel, conclure sur la significativité, puis interpréter brièvement — sans anticiper la discussion.

    Formulations types par test

    Statistiques descriptives :

    « Les participants présentent un score moyen de satisfaction de 6,8 (ET = 1,4, n = 87). La distribution est approximativement symétrique (asymétrie = −0,21). »

    Khi-deux :

    « L’analyse de l’indépendance entre le genre et le choix de filière révèle une association statistiquement significative, χ²(2, N = 120) = 8,43, p = 0,015, V de Cramér = 0,27. »

    t-test :

    « Les salariés en CDI obtiennent un score de satisfaction significativement plus élevé (M = 7,2, ET = 1,1) que les salariés en CDD (M = 5,9, ET = 1,6), t(98) = 4,12, p < 0,001, IC 95 % [0,68 ; 1,92], d = 0,94. »

    ANOVA :

    « L’analyse de variance indique un effet significatif du niveau d’études sur le score d’engagement, F(2, 117) = 6,78, p = 0,002, η² = 0,10. Les comparaisons post-hoc (Tukey) révèlent que les diplômés de master diffèrent significativement des titulaires d’un bac+2 (p = 0,004). »

    Régression linéaire :

    « Le modèle de régression explique 34 % de la variance du score de performance (R² = 0,34, F(3, 86) = 14,7, p < 0,001). L’ancienneté (β = 0,42, p < 0,001) et la formation continue (β = 0,28, p = 0,012) sont des prédicteurs significatifs. »

    Notez que les valeurs numériques présentées dans ces formulations-types sont des exemples illustratifs de format de rédaction, non des données empiriques issues d’une étude publiée. Elles vous servent de modèle de mise en forme.

    La méthodologie quantitative guide proposée par Expert Mémoire insiste également sur l’importance de contextualiser chaque résultat par rapport à la littérature avant d’entrer dans la section Discussion — une frontière que les étudiants franchissent trop souvent involontairement.

    Pour structurer l’ensemble de votre démarche scientifique, reportez-vous à notre article sur comment justifier le choix de sa méthodologie dans un mémoire en 2026.

    Tesify peut vous aider
    L’assistant IA Tesify structure automatiquement votre chapitre Résultats à partir de vos données et génère les tableaux APA conformes. Commencer gratuitement →

    FAQ — Questions fréquentes sur l’analyse des données quantitatives pour un mémoire

    Quelle est la différence entre SPSS et Excel pour analyser des données de mémoire ?

    Excel suffit pour les statistiques descriptives (moyenne, médiane, écart-type, histogrammes) et les tests simples disponibles via l’Utilitaire d’analyse (t-test, corrélation, régression simple). SPSS est indispensable dès que vous avez besoin d’un khi-deux avec tableau de contingence complet, d’une ANOVA avec tests post-hoc, d’une régression multiple avec diagnostics de multicolinéarité ou de tests de normalité (Shapiro-Wilk, Kolmogorov-Smirnov). Pour un mémoire de master 2 avec une démarche hypothético-déductive rigoureuse, SPSS est fortement conseillé.

    Combien de répondants faut-il pour que les résultats soient significatifs ?

    Le minimum absolu est de 30 répondants par groupe pour un t-test. Pour une ANOVA à trois groupes, prévoyez 30 répondants par modalité (soit 90 au total). Pour une régression multiple avec trois prédicteurs, la règle empirique de 10 observations par prédicteur recommande au moins 30 répondants, mais 50 ou plus offre une puissance statistique satisfaisante. Un khi-deux requiert que chaque cellule du tableau de contingence contienne au moins 5 effectifs théoriques — ce qui dépend de votre croisement de variables.

    Comment interpréter un p-value supérieur à 0,05 dans mon mémoire ?

    Un p > 0,05 ne signifie pas que votre hypothèse est fausse ni que votre mémoire est raté. Cela signifie que vos données ne fournissent pas suffisamment de preuves statistiques pour rejeter l’hypothèse nulle au seuil de 5 %. Vous pouvez rédiger : « Les analyses n’ont pas permis de mettre en évidence un effet statistiquement significatif (p = 0,12). Cette absence de résultat significatif pourrait s’expliquer par une puissance statistique limitée liée à la taille de l’échantillon (n = 42). » Discutez les pistes dans votre section Limites.

    Peut-on utiliser jamovi à la place de SPSS pour un mémoire ?

    Oui, jamovi est une alternative gratuite et open source qui couvre la quasi-totalité des tests disponibles dans SPSS (t-test, ANOVA, régression, corrélation, khi-deux, tests non-paramétriques). Son interface est plus intuitive et ses sorties sont préformatées selon les normes APA. Un nombre croissant d’universités françaises l’acceptent dans les mémoires de master. Vérifiez les consignes de votre directeur de recherche avant de l’utiliser : certains programmes exigent spécifiquement SPSS.

    Comment présenter les tableaux SPSS dans le corps du mémoire ?

    Les tableaux SPSS bruts (avec leur fond gris et leurs polices par défaut) ne s’insèrent pas directement dans un mémoire. Recréez-les sous Word ou Excel en respectant le format APA 7 : pas de lignes verticales, en-tête en gras, note explicative sous le tableau commençant par « Note. ». N’exportez que les statistiques essentielles (moyennes, écarts-types, valeur du test, degrés de liberté, p-value, taille d’effet) — les tableaux complets peuvent figurer en annexe. Consultez notre guide sur la présentation des résultats avec tableaux et figures pour les formats exacts.

    Quel test utiliser pour analyser des données d’une échelle de Likert ?

    Les items d’une échelle de Likert sont techniquement ordinaux, mais la pratique académique courante en sciences sociales traite les scores agrégés (somme ou moyenne de plusieurs items) comme des variables métriques continues, autorisant ainsi les tests paramétriques (t-test, ANOVA, corrélation de Pearson). Si vous analysez un item isolé ou si votre échantillon est inférieur à 30, préférez les tests non-paramétriques équivalents. Assurez-vous de valider au préalable la fiabilité de votre échelle (alpha de Cronbach dans SPSS : Analyse > Échelle > Analyse de fiabilité).

    Comment corriger une distribution non-normale avant d’effectuer des tests paramétriques ?

    Trois approches sont courantes dans les mémoires de master. Première option : transformer la variable (logarithme, racine carrée) pour l’approcher d’une distribution normale — notez et justifiez la transformation dans votre section méthode. Deuxième option : utiliser les équivalents non-paramétriques (Mann-Whitney, Kruskal-Wallis, Spearman) sans transformation. Troisième option : invoquer le théorème central-limite si n > 30 par groupe, qui garantit la normalité asymptotique de la distribution des moyennes. La troisième option est la plus courante et la plus acceptée dans les mémoires de master en sciences sociales.

  • Comment construire le rétroplanning de son mémoire de master : calendrier semaine par semaine (2026)

    Comment construire le rétroplanning de son mémoire de master : calendrier semaine par semaine (2026)

    Comment construire le rétroplanning de son mémoire de master : calendrier semaine par semaine (2026)

    La date de soutenance approche à une vitesse déconcertante, et le mémoire ressemble encore à un projet flou. La cause est presque toujours la même : l’absence d’un rétroplanning solide dès le début de l’année de M2. Faire le rétroplanning de son mémoire master, ce n’est pas remplir un tableau pour rassurer son directeur — c’est construire une architecture temporelle qui transforme neuf mois de travail en jalons concrets, semaine après semaine, depuis la soutenance jusqu’au présent.

    Ce guide applique la méthode du backward-planning à l’année universitaire française 2025-2026 : vous partez de la date de dépôt, vous remontez vers septembre, et vous découpez le chemin en huit phases avec des livrables précis pour chacune. Vous trouverez aussi les outils gratuits à utiliser, les erreurs classiques à éviter et, surtout, le plan B pour quand la réalité dévie du plan A.

    Réponse rapide : Pour faire le rétroplanning de votre mémoire master, commencez par noter la date de dépôt officielle, puis remontez vers septembre en allouant des blocs de semaines à chacune des huit phases (sujet → revue de littérature → cadre théorique → collecte → analyse → rédaction → relecture → soutenance). Insérez une semaine tampon après chaque phase critique. Transcrivez le tout dans Google Sheets ou Notion pour le rendre visible au quotidien.

    Pourquoi le rétroplanning est plus efficace qu’un planning classique

    Un planning classique part du présent et projette des tâches vers l’avenir. Le problème : les premières semaines sont toujours sous-estimées, et l’étudiant passe des mois dans les phases préliminaires avant de réaliser qu’il ne lui reste plus assez de temps pour rédiger correctement. Le rétroplanning inverse cette logique. Vous commencez par la contrainte absolue — la date de soutenance — et vous remontez vers le présent en déduisant ce qui doit être terminé à quel moment.

    Cette approche a deux avantages concrets. Premièrement, elle rend visible les phases qui empiètent sur les périodes de vacances ou d’examens, et force à les anticiper plutôt qu’à les subir. Deuxièmement, elle crée une pression saine et régulière : chaque semaine, vous savez précisément si vous êtes en avance ou en retard par rapport à votre propre architecture, ce qui facilite les décisions de rattrapage avant qu’il soit trop tard.

    Selon les recommandations de Scribbr, un calendrier de travail pour mémoire doit partir de la date de remise et couvrir l’ensemble de l’année de M2, avec des points de rendez-vous mensuels avec le directeur pour ajuster les livrables intermédiaires.

    Étape 1 — Ancrer la date de dépôt comme point fixe

    Avant d’écrire une seule semaine dans votre tableau, vous devez connaître deux dates avec certitude :

    1. La date limite de dépôt du mémoire — communiquée par votre secrétariat pédagogique, généralement entre mi-mai et fin juin selon les universités françaises. En 2026, la majorité des sessions de soutenance de M2 se situent entre fin mai et fin juin.
    2. La date de soutenance — souvent fixée deux à trois semaines après le dépôt du manuscrit.

    Notez ces deux dates en rouge dans votre outil de planification. Tout le reste se construit à rebours depuis elles. Si votre université n’a pas encore communiqué les dates officielles en septembre, utilisez les dates de l’année précédente comme hypothèse de travail et ajustez dès confirmation.

    Conseil de mentor : Prévoyez toujours d’avoir rendu votre mémoire sept jours avant la date limite officielle. Cette semaine de marge finale absorbe les imprévus techniques (erreurs de format, problèmes d’impression, mise en page de dernière minute) sans jamais mettre votre dépôt en péril.

    Étape 2 — Les huit phases du mémoire et leur durée réaliste

    Un mémoire de M2 passe par huit phases distinctes. Voici leur durée indicative pour une année universitaire de 36 semaines actives :

    Phase Contenu principal Durée conseillée Livrable de fin de phase
    1. Sujet Exploration, sélection, faisabilité 3-4 semaines Sujet validé par le directeur
    2. Revue de littérature Recherche documentaire, fiches de lecture 5-6 semaines Bibliographie de 40-60 sources annotées
    3. Cadre théorique Problématique, hypothèses, plan détaillé 3-4 semaines Plan validé et problématique finalisée
    4. Collecte de données Entretiens, questionnaires, observations 4-6 semaines Corpus de données brutes complet
    5. Analyse Traitement des données, résultats 3-4 semaines Résultats interprétés et organisés
    6. Rédaction Écriture des chapitres, introduction, conclusion 8-10 semaines Manuscrit complet (première version)
    7. Relecture et correction Correction, mise en forme, vérification 2-3 semaines Manuscrit finalisé prêt au dépôt
    8. Soutenance Préparation slides, simulation, dépôt 2-3 semaines Soutenance réussie

    Pour approfondir deux des phases les plus chronophages, consultez notre guide sur comment faire une revue de littérature pour son mémoire et notre guide sur comment rédiger la méthodologie d’un mémoire.

    Étape 3 — Calendrier semaine par semaine (septembre 2025 – juin 2026)

    Le tableau ci-dessous traduit les huit phases en semaines concrètes pour l’année universitaire 2025-2026. Les dates de dépôt et de soutenance sont placées fin mai / début juin, conformément à la majorité des calendriers de M2 en France. Adaptez-les à votre université.

    Semaine Dates indicatives Phase Objectif de la semaine
    S1 8-12 sept. 2025 Sujet Construire le rétroplanning, lister 5 sujets possibles
    S2 15-19 sept. Sujet Premier rendez-vous directeur, retenir 1-2 sujets
    S3 22-26 sept. Sujet Analyse de faisabilité, angle définitif choisi
    S4 29 sept-3 oct. Sujet Sujet soumis et validé par écrit par le directeur
    S5-S6 6-17 oct. Revue de littérature Recherche documentaire intensive, bases de données (Scopus, Google Scholar)
    S7 20-24 oct. Revue de littérature Fiches de lecture pour les 20 sources prioritaires
    S8-S9 3-14 nov. Revue de littérature Synthèse des courants théoriques, carte conceptuelle
    S10 17-21 nov. Revue de littérature Bibliographie annotée soumise au directeur (40+ sources)
    S11-S12 24 nov-5 déc. Cadre théorique Formulation de la problématique et des hypothèses
    S13 8-12 déc. Cadre théorique Rédaction du plan détaillé (chapitres, sections, sous-sections)
    S14 15-19 déc. Cadre théorique Plan validé par le directeur avant les vacances
    Vacances 22 déc-4 janv. Marge tampon Lectures de rattrapage + recharge cognitive
    S15-S16 5-16 janv. 2026 Collecte de données Conception des outils (guide d’entretien, questionnaire)
    S17-S19 19 janv-6 févr. Collecte de données Terrain : entretiens, diffusion questionnaire, observations
    S20 9-13 févr. Collecte de données Clôture du terrain, transcription des entretiens
    Vacances 16-27 févr. Marge tampon Transcriptions, premières lectures analytiques
    S21-S22 2-13 mars Analyse Codage des données, catégorisation thématique
    S23-S24 16-27 mars Analyse Interprétation, mise en relation avec la littérature
    S25-S26 30 mars-10 avr. Rédaction Rédaction chapitres 1 et 2 (première version)
    Vacances 13-24 avr. Rédaction (continu) Chapitre 3, introduction, conclusion
    S27-S30 27 avr-22 mai Rédaction Finalisation du manuscrit complet, envoi au directeur
    S31-S32 25 mai-5 juin Relecture Corrections suite aux retours du directeur, relecture finale
    S33 8-12 juin Relecture Mise en forme finale, impression, dépôt
    S34-S35 15-26 juin Soutenance Préparation slides, simulation, soutenance

    Pour la phase de relecture, la méthode détaillée est disponible dans notre guide comment relire et corriger son mémoire en 3 jours. Pour la représentation visuelle de ce calendrier sous forme de diagramme, consultez notre article comment faire un diagramme de Gantt pour son mémoire.

    Étape 4 — Insérer des marges tampons sans les gaspiller

    Un rétroplanning sans marge tampon est un rétroplanning qui échoue au premier imprévu. La règle d’or : insérez une semaine de tampon après chaque phase critique, c’est-à-dire après la revue de littérature, après la collecte de données et après la rédaction. Ces tampons ne sont pas des semaines de vacances — ce sont des semaines de rattrapage conditionnelles.

    La discipline consiste à ne consommer ces marges qu’en cas de retard avéré. Si une phase se termine à temps, la semaine tampon se transforme en avance sur la phase suivante. Cette pratique crée progressivement un coussin confortable en fin d’année, précisément quand le stress est le plus fort.

    1. Tampon de mi-décembre — absorbe les retards accumulés sur le sujet et la revue de littérature. Profitez-en pour écrire les premières pages du cadre théorique si vous êtes en avance.
    2. Tampon de mi-février — couvre les délais de terrain (répondants silencieux, entretiens reportés). Si le terrain est bouclé, avancez l’analyse.
    3. Tampon de fin mai — permet d’intégrer les dernières corrections du directeur sans stress. Si le manuscrit est rendu dans les délais, utilisez cette semaine pour préparer vos slides de soutenance.
    Règle des tampons : Ne rognez jamais la semaine tampon de la phase de relecture. C’est la dernière ligne de défense avant le dépôt. Si vous êtes en retard sur la rédaction, comprimez les semaines de rédaction — jamais les semaines de relecture ni de mise en forme.

    Étape 5 — Quels outils gratuits utiliser pour son rétroplanning

    Trois outils couvrent la quasi-totalité des besoins d’un étudiant de M2 pour structurer et suivre son rétroplanning :

    Google Sheets

    La solution la plus rapide à mettre en place. Créez un onglet « Rétroplanning » avec les semaines en lignes et les phases en colonnes colorées. L’avantage majeur : le fichier est accessible depuis n’importe quel appareil, partageable avec le directeur en lecture seule, et modifiable en temps réel. Idéal si vous souhaitez un outil simple sans courbe d’apprentissage.

    Notion

    Notion permet de combiner une base de données calendrier avec des pages de suivi pour chaque phase. Vous pouvez créer une vue « Timeline » qui ressemble visuellement à un Gantt, et une vue « Board » pour suivre l’état de chaque livrable (À faire / En cours / Terminé). Particulièrement utile si vous souhaitez centraliser rétroplanning, fiches de lecture et brouillons de rédaction dans un seul espace de travail.

    Planificateur de mémoire (Seveo Rédaction)

    Outil interactif gratuit qui génère automatiquement votre rétroplanning à partir de votre date de dépôt et du type de document. Il exporte en PDF, fichier .ics ou Google Calendar — pratique pour synchroniser les jalons sur votre agenda. Accessible sur seveoredaction.fr/outils/planificateur-memoire.

    Quel que soit l’outil choisi, l’essentiel est de le consulter chaque lundi matin, de cocher les livrables complétés et d’ajuster les semaines suivantes si nécessaire. Un rétroplanning qui n’est pas consulté régulièrement ne sert à rien.

    Superprof recommande également de partager ce planning avec votre entourage proche pour créer une responsabilité sociale — un proche qui sait que vous devez finir votre cadre théorique avant Noël peut devenir un soutien précieux.

    Étape 6 — Comment activer le plan B quand le planning déraille

    Aucun rétroplanning ne survit intact au contact de la réalité. Maladie, directeur injoignable, terrain qui s’étire, examens plus lourds que prévu — les causes de déraillement sont nombreuses. La question n’est pas de savoir si le plan déviera, mais quand et comment vous réagirez.

    Quand déclencher le plan B ?

    Déclenchez votre plan de rattrapage dès que vous accusez un retard de plus d’une semaine sur une phase critique, ou dès que vous entamez une semaine tampon. Ne laissez pas un retard d’une semaine devenir un retard de trois semaines par inertie.

    Les quatre leviers du rattrapage

    1. Réduire le périmètre de la collecte — Si vous prévoyiez 15 entretiens et n’avez que cinq semaines de terrain, visez 10 entretiens riches plutôt que 15 superficiels. La qualité prime sur la quantité dans la recherche qualitative.
    2. Compresser la phase de rédaction par parallélisation — Rédigez le chapitre 1 en même temps que vous terminez l’analyse du chapitre 2. Les deux phases ne sont pas strictement séquentielles.
    3. Prévenir le directeur et renégocier les jalons — Un directeur informé à temps peut remodeler les attentes. Un directeur surpris le dernier jour ne peut pas aider. Envoyez un email factuel : « J’ai pris deux semaines de retard sur la collecte à cause de [raison], voici comment je prévois de rattraper. »
    4. Solliciter une prorogation de dépôt — En cas de force majeure (maladie certifiée, décès familial), les universités françaises accordent des délais supplémentaires. Contactez le secrétariat pédagogique dès que vous connaissez l’ampleur du problème, pas à la dernière semaine.

    Cas particulier : le directeur qui ne répond pas

    Un directeur de mémoire peut prendre 10 à 15 jours ouvrés pour répondre à un envoi de chapitre. Anticipez ce délai dans votre rétroplanning en ne planifiant jamais un livrable critique « la semaine avant » une période chargée pour lui (congés d’été, période de jurys). Si l’absence de réponse dépasse trois semaines, envoyez un email de relance formel au responsable pédagogique du master — c’est son rôle de faciliter cet encadrement.

    Pour la préparation de la soutenance elle-même, une fois le manuscrit déposé, consultez notre guide complet sur comment soutenir un mémoire à distance en visio.

    Accélérez votre mémoire avec Tesify

    Tesify est l’outil IA conçu pour les étudiants de M2 : génération de plan, aide à la rédaction des chapitres, vérification des normes APA et suivi de l’avancement. Des milliers d’étudiants ont utilisé Tesify pour tenir leur rétroplanning sans sacrifier la qualité.

    Commencer gratuitement sur Tesify

    FAQ

    Quand commencer son rétroplanning de mémoire master ?

    Dès la première semaine de septembre en M2, idéalement le jour de la rentrée universitaire. Plus vous commencez tôt, plus les marges tampons sont larges et le stress faible. Même un rétroplanning construit à la fin septembre reste utile, mais chaque semaine perdue réduit vos marges de sécurité.

    Combien de temps faut-il pour rédiger un mémoire de master ?

    La phase de rédaction pure représente généralement 8 à 10 semaines pour un mémoire de 80 à 100 pages, en comptant les révisions après retours du directeur. En ajoutant la relecture et la mise en forme finale, prévoyez 12 semaines entre la fin de l’analyse et le dépôt.

    Quelle est la différence entre un rétroplanning et un diagramme de Gantt pour un mémoire ?

    Le rétroplanning est une méthode stratégique qui part de la date finale pour remonter vers le présent et déduire les jalons intermédiaires. Le diagramme de Gantt est un outil de représentation visuelle qui affiche chronologiquement les tâches et leurs durées. Le rétroplanning produit la séquence logique des phases ; le Gantt la met en forme graphiquement pour faciliter le suivi quotidien.

    Comment rattraper un retard dans son planning mémoire ?

    Identifiez précisément la phase en retard, réduisez son périmètre si possible (moins d’entretiens, moins de sources), parallélisez les phases qui le permettent, consommez la semaine tampon prévue à cet effet, et prévenez votre directeur par email pour renégocier les jalons. En cas de retard supérieur à trois semaines, contactez le secrétariat pédagogique pour explorer une prorogation.

    Quels outils gratuits utiliser pour son rétroplanning de mémoire ?

    Google Sheets est la solution la plus rapide (tableau hebdomadaire personnalisable, accessible depuis tous les appareils, partageable avec le directeur). Notion offre une vue Timeline et une vue Board pour suivre l’état de chaque livrable. Le planificateur interactif de Seveo Rédaction génère automatiquement votre rétroplanning à partir de votre date de dépôt. Les trois sont gratuits et suffisants pour un mémoire de M2.

    Mon directeur ne répond pas, comment adapter mon rétroplanning ?

    Prévoyez systématiquement 10 à 15 jours ouvrés de délai de réponse pour chaque envoi au directeur, et ne planifiez pas de livraison critique juste avant ses périodes de congés. Si l’absence de réponse dépasse trois semaines, envoyez un email de relance formel, puis contactez le responsable pédagogique du master pour débloquer la situation.

    Combien de phases doit contenir le rétroplanning d’un mémoire de M2 ?

    Un découpage en 8 phases couvre tous les jalons essentiels : choix du sujet, revue de littérature, cadre théorique, collecte de données, analyse, rédaction, relecture-correction et préparation de la soutenance. Certains étudiants ajoutent une phase « formatage et mise en page » distincte, ce qui donne 9 phases. En deçà de 6 phases, le découpage est trop grossier pour détecter les retards à temps.

    Sources et ressources complémentaires