Catégorie : Statistiques

  • Le plan d’analyse statistique : choisir vos tests avant d’avoir vos données (2026)

    Le plan d’analyse statistique : choisir vos tests avant d’avoir vos données (2026)

    La question arrive toujours dans le même ordre, et c’est le mauvais : « j’ai récupéré mes 200 réponses, maintenant quel test dois-je utiliser ? »

    Posée à ce moment-là, elle est déjà trop tard. Il arrive qu’aucun test ne convienne — parce que la variable a été mesurée sur trois modalités là où il en fallait une continue, parce que les groupes sont trop déséquilibrés, parce que la question n’a pas été posée à ceux qu’il fallait. À ce stade, la collecte est close et rien ne se rattrape.

    Le remède tient en une à deux pages écrites avant la collecte : le plan d’analyse statistique. Il ne demande pas de compétences supplémentaires, et il se recycle presque tel quel en sous-section de votre chapitre méthodologie.

    Pourquoi l’ordre change tout

    Deux raisons, l’une pratique, l’autre méthodologique.

    La raison pratique. Écrire « pour tester H2, je comparerai la moyenne de satisfaction entre les trois services » oblige immédiatement à vérifier que votre questionnaire produira bien une variable de satisfaction continue et une variable de service à trois modalités, avec assez de répondants dans chacune. Ce contrôle prend dix minutes tant que le questionnaire est modifiable, et devient impossible une fois qu’il est diffusé.

    La raison méthodologique. Un même jeu de données autorise énormément d’analyses différentes : plusieurs découpages de groupes, plusieurs variables de résultat, avec ou sans les cas atypiques. En explorant assez longtemps, on finit statistiquement par trouver quelque chose de significatif — même quand il n’y a rien. Fixer les analyses à l’avance supprime ce risque à la racine, et c’est une garantie que vous pouvez revendiquer en soutenance.

    Rien de tout cela n’interdit l’exploration. Cela impose seulement de la nommer : les analyses du plan sont confirmatoires, les autres sont exploratoires et se présentent comme telles.

    Frise chronologique où la décision est verrouillée avant l'arrivée des données
    La valeur du plan vient uniquement de sa date : après coup, ce n’est plus qu’une description.

    Les six lignes d’un plan d’analyse

    1. Vos variables et leur niveau de mesure

    Listez chaque variable qui interviendra dans une hypothèse, en précisant si elle est continue, ordinale ou catégorielle, et combien de modalités elle comporte. C’est fastidieux et c’est l’étape la plus rentable : le niveau de mesure détermine à lui seul la famille de tests disponibles. La plupart des impasses de fin de mémoire viennent d’une variable mesurée dans un format qui interdit l’analyse prévue.

    2. Une hypothèse, un test

    Pour chaque hypothèse issue de votre cadre théorique, nommez le test qui la tranchera. La discipline est simple : si une hypothèse n’a pas de test en face, elle n’est pas testable telle qu’elle est formulée et doit être reformulée. C’est le meilleur contrôle de qualité qui existe sur une série d’hypothèses de recherche, et il ne coûte rien.

    3. Les conditions à vérifier, et le plan de secours

    C’est la colonne que personne n’écrit, et celle qui sauve les mémoires. Chaque test paramétrique repose sur des conditions — normalité, égalité des variances, indépendance, linéarité — qui ne seront pas toutes remplies. Ce n’est pas une éventualité, c’est la situation ordinaire.

    Décidez donc à l’avance de ce que vous ferez : quel test de repli, quelle correction, quelle transformation. « Si la normalité est rejetée, je passe au test non paramétrique correspondant » est une phrase qui vaut des points en soutenance parce qu’elle prouve que la décision n’a pas été prise en fonction du résultat. Notre annuaire des conditions statistiques et de leurs plans de secours est fait pour être recopié dans cette colonne.
    Tableau associant chaque hypothèse de recherche au test statistique correspondant
    Le cœur du plan tient dans un tableau : une ligne par hypothèse, une colonne pour le repli.

    4. Le traitement des données imparfaites

    Deux décisions, à prendre avant de voir les données parce qu’elles influencent directement les résultats :

    • Les données manquantes. Quelle proportion de non-réponse rend un questionnaire inexploitable ? Écartez-vous le questionnaire entier ou seulement l’analyse concernée ? La distinction entre les mécanismes de données manquantes détermine ce qui est légitime.
    • Les valeurs extrêmes. Quel critère de repérage, et quelle règle de décision ? Fixer à l’avance qu’on ne supprime que les valeurs impossibles rend impossible la tentation d’écarter une observation gênante une fois le résultat connu.

    5. Le seuil, les tests multiples, la taille d’effet

    Annoncez le seuil de significativité retenu et précisez si vos tests sont uni ou bilatéraux. Si vous prévoyez de nombreuses comparaisons, dites comment vous en tiendrez compte plutôt que d’accumuler les tests en silence.

    Surtout, engagez-vous à rapporter une taille d’effet à côté de chaque p. C’est aujourd’hui attendu dans la plupart des disciplines, et cela vous protège de la conclusion la plus faible qui soit : « c’est significatif », sans jamais dire de combien.

    6. Le logiciel et sa version

    Une ligne, souvent oubliée, et systématiquement attendue dans la méthodologie. Nommez l’outil et sa version. Le choix n’a aucune incidence sur la validité de vos résultats ; son absence, en revanche, est une lacune facile à éviter.

    La forme : un tableau, pas un chapitre

    L’essentiel du plan tient dans un tableau d’une page, avec une ligne par hypothèse et cinq colonnes : l’hypothèse, les variables concernées avec leur niveau de mesure, le test prévu, les conditions à vérifier, le test de repli.

    Ajoutez autour trois courts paragraphes — préparation des données, seuil et tailles d’effet, logiciel — et votre plan est complet. Ce format a un avantage décisif : il se lit en dix minutes. C’est ce qui le rend utile en rendez-vous d’encadrement, là où un texte de six pages ne serait jamais relu.

    Vous avez déjà collecté ? Faites-le quand même

    Situation très fréquente, et la réponse n’est pas « tant pis ». Écrivez le plan avant d’ouvrir votre fichier de données, ou du moins avant de lancer le moindre test. Vous perdez la garantie d’antériorité, mais vous conservez l’essentiel : des décisions prises sur des critères plutôt qu’en fonction des p-valeurs obtenues.

    Datez le document, mentionnez qu’il a été rédigé après la collecte, et tenez-vous-y. Un mémoire qui assume cet ordre est plus solide qu’un mémoire qui prétend l’inverse.

    Et si vous n’avez pas encore collecté, une dernière étape s’impose logiquement à cet endroit : une fois les tests choisis, vous savez exactement quoi entrer dans un calcul de taille d’échantillon. C’est même la seule façon de le faire correctement, puisque le calcul dépend du test retenu.

    Écrire le plan, puis le chapitre

    Le plan d’analyse est un document de travail ; la sous-section « analyses statistiques » de votre mémoire en est la version rédigée, au passé et en prose continue. Le passage de l’un à l’autre est mécanique, et c’est exactement le genre de réécriture qui prend un après-midi de trop.

    Tesify vous accompagne sur ce trajet : transformer votre tableau de décisions en paragraphes académiques, articuler cette sous-section avec le reste de votre méthodologie, et maintenir une terminologie cohérente entre les hypothèses, la méthode et les résultats. Vos données et vos analyses restent les vôtres.

    Rédiger votre méthodologie quantitative avec Tesify

    Questions fréquentes

    Quelle longueur doit faire un plan d’analyse statistique ?

    Une à deux pages suffisent largement pour un mémoire de master, et l’essentiel tient souvent dans un seul tableau. Ce n’est pas un chapitre supplémentaire à rédiger : c’est un document de travail, qui deviendra ensuite quelques paragraphes de votre méthodologie. Si votre plan dépasse trois pages, vous êtes probablement en train d’écrire le chapitre au lieu de préparer les décisions.

    Puis-je changer de test après avoir vu mes données ?

    Oui — quand une condition d’application n’est pas remplie. C’est précisément ce que prévoit la colonne « plan de secours », et personne ne vous le reprochera. Ce qui n’est pas légitime, c’est de changer de test parce que le premier ne donnait pas le résultat espéré. La différence tient entièrement à la raison invoquée, et c’est pourquoi cette raison doit être écrite.

    Que faire si mon directeur ne me l’a pas demandé ?

    Faites-le quand même, et apportez-le au rendez-vous suivant. Un tableau d’une page se relit en dix minutes, alors qu’un chapitre méthodologie complet attend souvent des semaines. C’est le format qui permet à votre directeur de repérer une hypothèse mal opérationnalisée ou un test inadapté à un moment où tout reste modifiable — c’est-à-dire au seul moment où son avis peut vraiment vous servir.

    Faut-il un plan d’analyse pour un mémoire qualitatif ?

    L’équivalent existe, sous une autre forme : préciser la méthode d’analyse retenue, le mode de codage, qui code, comment les désaccords sont tranchés, et à quel moment vous considérerez le corpus suffisant. La logique est identique — fixer les règles avant de connaître les résultats — même si les objets sont différents.

    Faut-il inclure le plan d’analyse dans le mémoire final ?

    Pas sous sa forme de tableau de travail. Il se fond dans la sous-section « analyses statistiques » du chapitre méthodologie, rédigée en prose et au passé. Certains le placent aussi en annexe lorsqu’il est détaillé, ce qui est apprécié dans les disciplines de santé, mais ce n’est pas une attente générale en master.

    Mon plan prévoyait un test qui s’est révélé impossible : est-ce grave ?

    Non, à condition de le dire. Écrivez ce qui était prévu, pourquoi cela n’a pas pu être fait — effectif insuffisant dans un groupe, variable finalement trop peu variable — et ce que vous avez fait à la place. Ce paragraphe de trois lignes vaut mieux qu’un silence, et il démontre exactement la maîtrise méthodologique que le jury cherche à évaluer.
  • Vous n’avez pas pu randomiser : différence-de-différences, score de propension ou variable instrumentale ? (2026)

    Vous n’avez pas pu randomiser : différence-de-différences, score de propension ou variable instrumentale ? (2026)

    La question tombe en soutenance, et elle est presque toujours la même : « comment savez-vous que c’est votre dispositif qui a produit cet écart, et non le fait que les personnes qui y ont participé étaient déjà différentes au départ ? »

    C’est la question de l’identification causale, et elle n’a pas de réponse statistique automatique. Dans un essai randomisé, le tirage au sort y répond seul. Mais un mémoire de master travaille presque toujours sur des données observationnelles : les gens ont choisi de suivre la formation, les entreprises ont choisi de se certifier, les communes ont choisi d’adopter le dispositif.

    Trois stratégies existent pour s’en sortir honnêtement : la différence-de-différences, le score de propension et la variable instrumentale. Elles ne demandent pas les mêmes données, ne reposent pas sur les mêmes hypothèses, et ne sont pas également réalistes dans un mémoire. Voici comment choisir.

    Le vrai problème : le contrefactuel manquant

    Ce que vous voudriez mesurer, c’est la différence entre ce qui est arrivé aux personnes traitées et ce qui leur serait arrivé sans le traitement. Cette seconde quantité n’existe pas : c’est le contrefactuel, et il est par construction inobservable.

    Toute la méthodologie causale consiste donc à construire un substitut crédible du contrefactuel — un groupe, une période ou une variation qui puisse raisonnablement tenir lieu de « ce qui se serait passé sinon ».

    Le danger porte un nom : le biais de sélection. Si les personnes qui se portent volontaires pour une formation sont déjà les plus motivées, comparer leur performance à celle des non-participants mesure la motivation autant que la formation. Aucune quantité de sophistication statistique appliquée après coup ne répare une comparaison mal construite. C’est la version opérationnelle du principe bien connu selon lequel une corrélation n’établit pas une causalité.

    Pourquoi « j’ai ajouté des variables de contrôle » ne suffit pas

    Le réflexe naturel est d’introduire l’âge, le diplôme, l’ancienneté et le secteur comme covariables dans une régression linéaire multiple, puis de présenter le coefficient du traitement comme un effet « toutes choses égales par ailleurs ».

    C’est utile, mais il faut être lucide sur la portée : cette formule ne neutralise que les caractéristiques que vous avez mesurées. Elle ne dit rien de la motivation, du soutien hiérarchique, de l’ambition ou de l’état de santé antérieur si vous ne les avez pas dans votre base. Or ce sont précisément ces variables non observées qui déterminent le plus souvent qui reçoit le traitement.

    Les trois méthodes qui suivent se distinguent justement par ce qu’elles font de l’inobservé.

    Deux courbes parallèles qui divergent après une date d'intervention
    La différence-de-différences ne compare pas deux niveaux : elle compare deux évolutions.

    Différence-de-différences : comparer des évolutions, pas des niveaux

    C’est la stratégie la plus accessible en mémoire, et de loin.

    Le principe. Vous observez deux groupes — un traité, un non traité — à deux moments : avant et après l’intervention. Vous calculez l’évolution de chaque groupe, puis la différence entre ces deux évolutions. Le groupe témoin sert à absorber tout ce qui a bougé pour tout le monde pendant la période : la conjoncture, la saison, une réforme nationale.

    Le calcul se fait en une seule régression, avec trois termes : une indicatrice de groupe, une indicatrice de période, et leur produit. C’est le coefficient de ce produit qui est l’estimation de l’effet — la mécanique est rigoureusement celle d’un terme d’interaction, avec la même lecture des coefficients.

    Ce que ça neutralise. Toute différence stable entre les deux groupes, y compris non mesurée. Si votre groupe traité était déjà plus performant au départ, l’écart de départ est éliminé.

    L’hypothèse critique : les tendances parallèles. Sans le traitement, les deux groupes auraient évolué de la même façon. Elle n’est pas démontrable, mais elle se rend crédible : si vous disposez de plusieurs périodes avant l’intervention, montrez que les deux courbes évoluaient déjà en parallèle. Un graphique de ces trajectoires pré-traitement est l’élément le plus convaincant que vous puissiez mettre dans un mémoire d’évaluation.

    Le piège classique. Un traitement déclenché parce que le groupe allait mal — un dispositif d’accompagnement lancé dans les services où l’absentéisme grimpait déjà. Les tendances n’étaient alors pas parallèles avant, et la méthode attribuera au dispositif un retour à la moyenne qui se serait produit de toute façon.

    Le modèle à effets fixes sur données de panel est la généralisation directe de cette logique à plusieurs unités et plusieurs périodes.

    Score de propension : fabriquer un groupe témoin comparable

    Le principe. Vous n’avez pas de mesure « avant », mais vous avez beaucoup de caractéristiques observées. Vous estimez alors, pour chaque individu, la probabilité d’avoir reçu le traitement compte tenu de ces caractéristiques — c’est le score de propension, obtenu par une régression logistique binaire dont la variable dépendante est le fait d’être traité.

    Vous appariez ensuite chaque individu traité à un ou plusieurs non-traités ayant un score voisin, et vous comparez les résultats à l’intérieur de ces paires. L’idée : entre deux personnes qui avaient la même probabilité de participer, celle qui a participé et celle qui n’a pas participé sont raisonnablement comparables.

    Les deux contrôles obligatoires. Ils sont rarement faits dans les mémoires, et un jury informé les demandera.

    • Le support commun. Les distributions de scores des deux groupes doivent se recouvrir. Un individu traité dont le score est de 0,97 n’a aucun jumeau possible : il faut l’écarter, et dire combien vous en avez écartés.
    • L’équilibre après appariement. Vérifiez que chaque covariable est désormais distribuée de façon similaire dans les deux groupes. L’indicateur usuel est la différence de moyennes standardisée, qu’on souhaite ramener sous 0,10. C’est ce tableau « avant / après appariement » qui prouve que la méthode a fait son travail.

    La limite qu’il faut assumer par écrit. L’appariement n’équilibre que ce que vous avez mesuré. Il ne protège en rien contre une variable non observée qui déterminerait à la fois la participation et le résultat. Sur ce point précis, le score de propension est moins protecteur que la différence-de-différences, qui neutralise l’inobservé stable sans avoir eu besoin de le mesurer. Écrivez-le dans vos limites : cela vous vaudra des points plutôt que d’en coûter.

    Deux groupes d'individus appariés deux à deux, certains restant sans paire
    Apparier, c’est aussi accepter de perdre les individus qui n’ont aucun équivalent dans l’autre groupe.

    Variable instrumentale : élégante, et rarement praticable

    Le principe. Vous cherchez une variable — l’instrument — qui pousse les gens vers le traitement sans avoir d’effet propre sur le résultat. Elle joue le rôle d’un tirage au sort naturel : la part de variation du traitement qu’elle explique est, elle, indépendante des caractéristiques des individus.

    L’estimation se fait en deux temps : on prédit d’abord le traitement à partir de l’instrument, puis on utilise cette prédiction à la place du traitement réel dans l’équation de résultat.

    Deux conditions, dont une invérifiable.

    1. La pertinence : l’instrument doit être fortement corrélé au traitement. Cela se teste, et la règle usuelle est un F supérieur à 10 dans la première équation. Un instrument faible produit des estimations très biaisées, parfois pires que la régression naïve.
    2. La restriction d’exclusion : l’instrument ne doit influencer le résultat que par le canal du traitement. Cette condition ne se teste pas. Elle s’argumente, et c’est là que presque tous les candidats échouent.

    Les instruments crédibles de la littérature sont typiquement des accidents administratifs ou géographiques : la distance au centre de formation le plus proche, une date-seuil d’éligibilité, une loterie d’attribution. Ils sont rares, et un instrument bricolé est plus dangereux qu’utile.

    Verdict honnête pour un mémoire de master : ne partez pas sur une variable instrumentale à moins qu’un instrument évident ne soit déjà présent dans votre terrain et que votre directeur le valide. Une différence-de-différences bien conduite vaut mieux qu’une variable instrumentale mal défendue.

    Comment choisir en pratique

    La question à se poser n’est pas « quelle méthode est la meilleure » mais « quelle structure de données ai-je réellement ». Trois questions dans l’ordre :

    1. Ai-je des observations avant et après, sur un groupe traité et un groupe non traité ? → différence-de-différences. C’est le premier choix chaque fois qu’il est disponible.
    2. Sinon, ai-je une seule photographie, mais beaucoup de covariables de qualité ? → score de propension, avec les tableaux de support commun et d’équilibre.
    3. Sinon, ai-je un instrument que je peux défendre théoriquement en trois phrases ? → variable instrumentale. Si l’argument prend plus de trois phrases, vous n’avez pas d’instrument.

    Et si la réponse est non aux trois ? C’est fréquent, et ce n’est pas un échec. Vous présentez alors une association ajustée et non un effet causal : régression avec covariables, vocabulaire prudent, et une section de limites qui explique précisément quel confondant vous ne pouvez pas exclure. Un mémoire qui délimite honnêtement sa portée est mieux noté qu’un mémoire qui revendique une causalité que son plan de recherche ne permet pas.

    Ce qu’il faut écrire

    Quelle que soit la méthode, quatre éléments sont attendus dans le chapitre méthodologie : la nature du traitement et sa date, la manière dont le groupe de comparaison a été constitué, l’hypothèse d’identification énoncée en clair, et les tests ou éléments qui la rendent plausible.

    Modèle de phrase — différence-de-différences : « L’effet est estimé par différence-de-différences, en comparant l’évolution des services équipés à celle des services non équipés entre 2024 et 2026. L’identification repose sur l’hypothèse de tendances parallèles, dont la plausibilité est appuyée par l’évolution comparable des deux groupes sur les trois exercices antérieurs (figure 4). Le coefficient d’interaction indique une réduction de 3,2 points (p = 0,014). »

    Modèle de phrase — score de propension : « Les scores de propension ont été estimés par régression logistique sur huit covariables, puis les participants appariés au plus proche voisin dans la limite du support commun. Onze participants sans équivalent ont été exclus. Après appariement, toutes les différences de moyennes standardisées sont inférieures à 0,10 (tableau 3). L’identification suppose l’absence de confondant non observé, hypothèse discutée en limites. »

    Et la règle de vocabulaire qui traverse tout : est associé à tant que l’identification n’est pas défendue, a pour effet seulement une fois qu’elle l’est.

    Écrire le chapitre qui porte tout cela

    La difficulté d’un mémoire d’évaluation n’est pas le calcul — chacune de ces méthodes tient en quelques lignes de code. Elle est dans l’argumentation : expliquer pourquoi votre groupe de comparaison est crédible, énoncer une hypothèse d’identification sans jargon, et discuter ce qu’elle laisse ouvert.

    Tesify vous accompagne sur cette rédaction : structurer le chapitre méthodologie, articuler la stratégie d’identification avec votre question de recherche, et transformer vos choix techniques en argumentation défendable devant un jury. Vos données et vos analyses restent les vôtres.

    Structurer votre mémoire d’évaluation avec Tesify

    Questions fréquentes

    Puis-je faire une différence-de-différences sans groupe témoin ?

    Non — une comparaison avant/après sur le seul groupe traité n’est pas une différence-de-différences, c’est une simple évolution temporelle. Elle confond votre dispositif avec tout ce qui s’est passé d’autre pendant la période. Si aucun groupe non traité n’existe, cherchez une comparaison imparfaite mais argumentable — un service voisin, une région comparable, une cohorte antérieure — et discutez explicitement ses limites.

    Combien de variables faut-il pour un score de propension ?

    La règle n’est pas quantitative mais conceptuelle : incluez tout ce qui influence à la fois la participation et le résultat. En revanche, n’incluez jamais une variable postérieure au traitement, ni une conséquence du traitement : cela introduit un biais au lieu de le réduire. Une dizaine de covariables bien choisies vaut mieux que trente ajoutées au hasard.

    Faut-il un logiciel particulier ?

    Non. La différence-de-différences se fait dans n’importe quel logiciel de régression, y compris SPSS, puisqu’il s’agit d’une régression avec un terme produit. L’appariement sur score de propension demande une extension sous SPSS, et existe en standard sous R et Stata. Le choix de l’outil n’a aucune incidence sur la validité de la stratégie d’identification.

    Ces méthodes s’appliquent-elles à un mémoire qualitatif ?

    Non, elles supposent une variable de résultat mesurée sur un nombre suffisant d’unités. Un mémoire qualitatif répond à la question causale autrement : par la reconstitution du mécanisme et la comparaison raisonnée de cas, et non par l’estimation d’un effet moyen. Les deux démarches sont légitimes ; ce qui ne l’est pas, c’est d’emprunter le vocabulaire de l’une en pratiquant l’autre.

    Mon jury me demandera-t-il vraiment tout cela en master ?

    Il ne vous demandera pas une variable instrumentale. Il vous demandera presque à coup sûr pourquoi votre groupe de comparaison est comparable — c’est la question standard des soutenances sur données observationnelles. Avoir une réponse préparée, nommée et assumée en limites suffit à transformer le moment le plus redouté de la soutenance en démonstration de maîtrise. Notre guide du design expérimental couvre le cas symétrique, celui où la randomisation reste possible.

  • Faut-il supprimer les valeurs aberrantes de votre mémoire ? (2026)

    Faut-il supprimer les valeurs aberrantes de votre mémoire ? (2026)

    Vous demandez une boîte à moustaches, et le logiciel dessine quatre petits ronds au-dessus de la moustache supérieure, chacun avec son numéro d’observation. La tentation est immédiate : les supprimer, et voir si le résultat devient enfin significatif.

    Réponse courte : non, pas par défaut. Supprimer une observation n’est légitime que dans un seul cas — quand la valeur est fausse, ou quand l’individu n’appartient pas à la population que vous étudiez. Une valeur simplement grande, aussi gênante soit-elle, est une donnée. La supprimer parce qu’elle dérange est une faute méthodologique que les jurys repèrent, surtout quand la suppression fait passer un p juste sous 0,05.

    Voici la démarche complète : distinguer les trois espèces de valeurs aberrantes, les repérer correctement, décider, et surtout écrire ce que vous avez fait.

    Trois choses différentes qu’on appelle « valeur aberrante »

    La confusion vient de là. Le même mot désigne trois situations dont une seule justifie une suppression.

    1. L’erreur. Un âge de 220 ans, un score de 55 sur une échelle qui plafonne à 50, une virgule décimale déplacée. C’est une donnée fausse : elle se corrige si la source le permet, se supprime sinon. Aucun débat.
    2. L’individu hors population. Un cadre dirigeant dans une enquête sur les employés d’exécution ; un patient dont le dossier révèle une pathologie qui figurait dans vos critères d’exclusion. Ce n’est pas une valeur fausse, c’est une personne qui n’aurait pas dû entrer. Elle se retire, à condition que le motif d’exclusion soit énoncé et s’applique à tous de la même manière.
    3. La valeur extrême et vraie. Le répondant qui a réellement quarante ans d’ancienneté, l’entreprise réellement dix fois plus grande que les autres. Celle-là ne se supprime pas. Elle appartient à la réalité que vous prétendez décrire.

    Toute la difficulté du travail consiste à ranger chaque point signalé par le logiciel dans l’une de ces trois cases — et cela ne se fait pas depuis le graphique. Cela se fait en retournant à la source : le questionnaire papier, le dossier, le fichier d’origine.

    Boîte à moustaches stylisée avec trois points situés au-delà des moustaches
    Le logiciel signale des points ; il ne dit jamais lequel est une erreur et lequel est une réalité.

    Les repérer proprement

    Sur une seule variable

    La boîte à moustaches est l’outil le plus lisible. La convention usuelle marque comme atypique toute valeur située à plus d’une fois et demie l’écart interquartile au-delà d’un quartile, et comme extrême celle qui dépasse trois fois cet écart. SPSS affiche les premières par un cercle et les secondes par un astérisque, avec le numéro d’observation à côté — c’est ce numéro qui vous permet de retourner à la ligne concernée.

    Le score standardisé donne le même diagnostic autrement : on convertit la variable en scores centrés-réduits et on examine ceux qui dépassent environ 3,3 en valeur absolue. Sur de petits échantillons, un seuil de 2,5 est parfois retenu, mais il signale mécaniquement plus de points.

    Sur plusieurs variables à la fois

    Un point peut être parfaitement banal sur chaque variable prise isolément et complètement atypique dans leur combinaison : un étudiant de 19 ans avec quinze ans d’expérience professionnelle. Aucun boxplot ne le verra. La distance de Mahalanobis mesure l’éloignement de chaque observation au centre du nuage multivarié en tenant compte des corrélations entre variables ; on la compare à une loi du khi-deux dont le nombre de degrés de liberté est le nombre de variables considérées, avec un seuil très strict.

    En régression : atypique n’est pas influent

    C’est la distinction que la plupart des mémoires manquent, et celle qui impressionne quand elle est maîtrisée.

    Une observation peut être très éloignée du nuage sans changer quoi que ce soit à vos résultats, si elle se situe dans le prolongement de la tendance générale. À l’inverse, une observation modérément atypique mais placée à l’extrémité de la plage des valeurs prédictives peut, à elle seule, faire pivoter votre droite de régression.

    Ce qui compte n’est donc pas l’éloignement mais l’influence. Deux indicateurs à demander dans les options de sauvegarde de votre régression linéaire multiple :

    • la distance de Cook, qui résume de combien l’ensemble des coefficients changerait si l’observation était retirée. Une valeur supérieure à 1 est le signal d’alerte classique ; certains auteurs retiennent un seuil plus sensible, de l’ordre de quatre divisé par la taille de l’échantillon ;
    • le levier, qui mesure l’atypie de l’observation sur les variables explicatives seules.

    Le bon réflexe : trier votre fichier par distance de Cook décroissante et examiner les cinq premières lignes. C’est cinq minutes de travail, et c’est exactement ce qu’un directeur de mémoire vérifiera.

    L’arbre de décision

    Face à un point signalé, trois questions dans cet ordre — et une seule mène à la suppression.

    1. La valeur est-elle possible ? Non → erreur : corrigez depuis la source, ou supprimez la valeur en la traitant ensuite comme une donnée manquante plutôt qu’en supprimant l’individu entier.
    2. L’individu relève-t-il de votre population ? Non → exclusion documentée, avec un critère explicite appliqué uniformément.
    3. La valeur est vraie et l’individu est bien dans votre population ?vous la gardez. Reste alors à choisir comment analyser en sa présence.

    Quatre façons de gérer une valeur extrême qu’on garde

    Garder ne veut pas dire ignorer. Quatre options, de la plus légère à la plus interventionniste.

    1. Ne rien faire, et le dire. Si les indicateurs d’influence sont faibles, la valeur extrême ne pose aucun problème. Mentionnez que vous avez vérifié, et passez à la suite. C’est l’issue la plus fréquente et la plus sous-utilisée.

    2. Changer de test. Beaucoup de méthodes non paramétriques travaillent sur les rangs et sont donc insensibles à l’ampleur des valeurs extrêmes. C’est la raison pour laquelle on bascule d’un test t vers Mann-Whitney, ou du coefficient de Pearson vers Spearman. La médiane, de la même façon, résiste là où la moyenne cède.

    3. Transformer la variable. Une transformation logarithmique ou racine carrée comprime la queue haute d’une distribution asymétrique et ramène les valeurs extrêmes vers le corps de la distribution. Le prix à payer est l’interprétation : vos coefficients ne s’expriment plus dans l’unité d’origine, et il faut le gérer dans la rédaction.

    4. Winsoriser. Plutôt que de retirer l’observation, on ramène sa valeur à un seuil — par exemple au 95e centile. L’individu reste dans l’échantillon, son influence est plafonnée. C’est un compromis acceptable en gestion et en finance, à condition d’annoncer le seuil retenu avant de regarder les résultats, et non après.

    Deux versions d'une même analyse comparées côte à côte sur une balance
    La question n’est pas « avec ou sans », mais « le résultat tient-il dans les deux cas ».

    L’analyse de sensibilité : la réponse qui satisfait tous les jurys

    Voici la meilleure stratégie disponible, et elle est étonnamment simple : faites tourner l’analyse dans les deux versions et rapportez les deux.

    Cela transforme une décision arbitraire en résultat. Deux cas de figure, et vous êtes gagnant dans les deux :

    • Les conclusions sont les mêmes. Votre résultat est robuste. Une phrase en note de bas de page suffit, et elle renforce considérablement votre crédibilité.
    • Les conclusions diffèrent. C’est une information de premier ordre, pas un échec : votre résultat dépend d’une poignée d’observations. Vous le signalez, vous décrivez qui sont ces individus, et vous en faites une limite argumentée. Un jury préfère de très loin cette honnêteté à un résultat fragile présenté comme solide.

    Le seul mauvais choix est de tester les deux versions en silence et de ne rapporter que celle qui arrange. C’est ce que la littérature appelle le tri sélectif des résultats, et c’est précisément ce que l’analyse de sensibilité rend inutile.

    Ce qu’il faut écrire

    Le traitement des valeurs extrêmes se décrit dans la section de préparation des données, avant les résultats, en trois ou quatre phrases. Le lecteur doit pouvoir reconstituer exactement ce que vous avez fait.

    Modèle de phrase — aucune suppression : « L’examen des boîtes à moustaches a identifié quatre observations atypiques sur la variable d’ancienneté. Le retour aux questionnaires a confirmé qu’il s’agissait de valeurs plausibles ; aucune n’a donc été supprimée. Les distances de Cook restant toutes inférieures à 1, ces observations n’exercent pas d’influence déterminante sur les estimations. »

    Modèle de phrase — suppression justifiée : « Deux observations présentaient un âge incompatible avec les critères d’inclusion (respectivement 4 et 220 ans) et ont été identifiées comme des erreurs de saisie ; la valeur a été recodée en donnée manquante. Aucune autre observation n’a été retirée. »

    Modèle de phrase — analyse de sensibilité : « L’analyse a été conduite avec puis sans les trois observations les plus influentes. Les coefficients varient marginalement et les conclusions restent inchangées ; les résultats présentés portent sur l’échantillon complet. »

    Une règle de forme, enfin : ne parlez jamais de « nettoyage » des données sans dire ce que vous avez nettoyé et combien de lignes en sont sorties. Un effectif final qui ne correspond pas à l’effectif annoncé au chapitre méthodologie est l’une des incohérences que les jurys relèvent le plus souvent. L’annuaire des conditions statistiques et de leurs plans de secours reprend cette vérification parmi les contrôles à faire avant de rédiger les résultats.

    Rédiger la partie qui explique vos choix

    Décider quoi faire d’une valeur extrême prend dix minutes. Écrire le paragraphe qui justifie ce choix, l’articuler avec vos critères d’inclusion et le rappeler correctement en limites prend beaucoup plus longtemps — et c’est ce paragraphe que le jury lira.

    Tesify vous accompagne sur cette rédaction : structurer la section de préparation des données, maintenir la cohérence des effectifs d’un chapitre à l’autre, et transformer vos décisions techniques en justifications défendables. Vos données et vos analyses restent les vôtres.

    Rédiger votre chapitre méthodologie avec Tesify

    Questions fréquentes

    Combien de valeurs aberrantes est-il normal d’avoir ?

    Il n’y a pas de norme, et c’est important à comprendre : le critère de la boîte à moustaches signale mécaniquement des points même dans une distribution parfaitement normale, d’autant plus que l’échantillon est grand. En voir quelques-uns n’indique rien d’anormal. Ce qui doit alerter, c’est une proportion élevée sur une même variable — signe possible d’un problème de saisie, d’une échelle mal comprise par les répondants, ou d’une population plus hétérogène que prévu.

    Puis-je supprimer une observation parce qu’elle rend mon test non significatif ?

    Non, jamais. C’est la seule règle absolue de cet article. Une décision de suppression doit être prise sur un critère défini avant de regarder les résultats, et appliquée de la même façon à toutes les observations. Si vous découvrez après coup qu’un point change tout, l’issue correcte n’est pas la suppression mais l’analyse de sensibilité : rapportez les deux versions et discutez la différence.

    Faut-il traiter les valeurs extrêmes avant ou après le test de normalité ?

    Avant, car elles en sont souvent la cause. Une distribution rejetée par un test de normalité l’est fréquemment à cause de deux ou trois valeurs en queue de distribution. Examinez-les d’abord, décidez, puis relancez le diagnostic de normalité sur les données telles que vous avez décidé de les analyser.

    Que faire d’un individu qui a répondu de façon manifestement peu sérieuse ?

    C’est un cas de qualité de réponse, pas de valeur extrême, et il se traite avec ses propres critères : temps de passation anormalement court, réponse identique à tous les items, incohérence entre deux questions de contrôle. Ces critères doivent être fixés à l’avance et énoncés dans le mémoire. Un individu ainsi écarté est une exclusion documentée, pas une valeur aberrante supprimée.

    La winsorisation est-elle acceptée dans un mémoire de master ?

    Oui, à condition d’être annoncée et justifiée. Elle est courante en finance et en gestion, où les distributions de variables monétaires sont très asymétriques. Précisez le seuil retenu, le nombre de valeurs affectées, et présentez de préférence les résultats non winsorisés en annexe. Dans un mémoire, la transparence sur le traitement compte davantage que le choix du traitement lui-même.

  • Mémoire d’économie sur données de panel : effets fixes, effets aléatoires et Stata (2026)

    Mémoire d’économie sur données de panel : effets fixes, effets aléatoires et Stata (2026)

    Votre base de données ressemble à ceci : 27 pays, observés chacun de 2010 à 2024. Ou 180 entreprises sur 8 exercices. Ou 96 départements sur 12 années.

    Vous avez donc 2 700 lignes — et la tentation, parfaitement naturelle, est de lancer une régression linéaire ordinaire dessus. C’est l’erreur qui fait rater le plus de mémoires d’économie quantitatifs, parce que vous n’avez pas 2 700 observations indépendantes : vous avez 27 unités observées 15 fois chacune.

    Cet article explique pourquoi cette distinction change tout, comment choisir entre les deux grands modèles de panel, et donne les commandes correspondantes.

    Ce qu’est un panel, et pourquoi le MCO ordinaire échoue

    Un panel — ou données longitudinales — croise deux dimensions : un identifiant individuel (le pays, l’entreprise, la région) et une dimension temporelle (l’année, le trimestre). Chaque ligne est un couple individu-période.

    Deux vocabulaires à connaître : un panel est cylindré (ou équilibré) si toutes les unités sont observées sur toutes les périodes, et non cylindré sinon. On distingue aussi les panels « courts » — beaucoup d’individus, peu de périodes, le cas le plus fréquent en mémoire — des panels « longs ».

    Le problème du MCO ordinaire est double.

    L’inflation de la significativité. Les observations d’une même entreprise se ressemblent d’une année sur l’autre. Le logiciel, lui, les traite comme 2 700 informations indépendantes. Les erreurs standard sont donc sous-estimées, les t surestimés, et vous obtenez des résultats significatifs qui ne le sont pas. C’est exactement la violation d’indépendance des résidus que signale la statistique de Durbin-Watson dans une régression linéaire multiple classique — sauf qu’ici elle est structurelle, pas accidentelle.

    Le biais de variable omise. C’est le plus grave, et c’est ce qui fait tout l’intérêt du panel. Chaque pays a des caractéristiques propres, stables et non mesurées : sa culture juridique, la qualité de ses institutions, son histoire industrielle. Si ces caractéristiques influencent à la fois votre variable dépendante et vos régresseurs, un MCO les confond avec vos effets. Le panel offre une solution élégante : puisque vous observez chaque unité plusieurs fois, vous pouvez éliminer entièrement tout ce qui est constant dans le temps chez elle, y compris ce que vous n’avez pas mesuré.

    Structure d'un panel : plusieurs individus observés sur plusieurs périodes
    Un panel n’est pas un grand échantillon : c’est un petit nombre d’unités observées de façon répétée.

    Effets fixes ou effets aléatoires

    Toute la littérature se ramène à une question : l’hétérogénéité individuelle non observée est-elle corrélée à vos variables explicatives ?

    Le modèle à effets fixes (within)

    Il attribue à chaque unité sa propre constante et n’exploite plus que la variation à l’intérieur de chaque unité au fil du temps. La question devient : « quand le taux d’investissement d’un pays donné augmente, que devient sa croissance dans ce pays-là ? »

    Avantage décisif : toute caractéristique stable de l’unité — mesurée ou non — disparaît de l’équation. Vous êtes protégé contre une classe entière de biais de variable omise sans avoir eu à mesurer quoi que ce soit.

    Coût : vous ne pouvez plus estimer l’effet d’une variable qui ne varie pas dans le temps. Le régime juridique d’un pays, le secteur d’activité d’une entreprise, le sexe d’un individu : leurs coefficients ne sont tout simplement pas identifiables. Le logiciel les supprimera de la sortie, ce qui surprend beaucoup d’étudiants la première fois.

    Le modèle à effets aléatoires

    Il traite l’hétérogénéité individuelle comme une composante aléatoire du terme d’erreur, sous l’hypothèse forte qu’elle n’est pas corrélée aux régresseurs.

    Avantage : il exploite à la fois la variation intra et inter-individuelle, il est donc plus efficient, et il permet d’estimer les coefficients des variables invariantes dans le temps.

    Coût : si l’hypothèse d’absence de corrélation est fausse — et en économie appliquée elle l’est souvent —, les estimations sont biaisées.

    Le test de Hausman

    C’est l’arbitre conventionnel. Il compare les deux jeux de coefficients : sous l’hypothèse nulle, les deux estimateurs sont convergents et l’écart entre eux n’est dû qu’au hasard.

    • p < 0,05 → l’hypothèse est rejetée : les effets individuels sont corrélés aux régresseurs. Retenez les effets fixes.
    • p > 0,05 → rien ne contredit l’hypothèse : les effets aléatoires sont admissibles, et plus efficients.

    Dans la pratique de la recherche économique appliquée, le rejet est le résultat le plus fréquent, et les effets fixes constituent le choix par défaut prudent. Une réserve à connaître, parce qu’un jury exigeant peut la soulever : le test de Hausman dans sa forme classique suppose lui-même des erreurs sphériques, ce qui cadre mal avec l’usage d’erreurs standard robustes. Des versions robustes existent, et il est parfaitement acceptable en mémoire de rapporter Hausman et de justifier le choix des effets fixes par un argument théorique — c’est même la posture la plus solide.

    Arbitrage entre modèle à effets fixes et modèle à effets aléatoires
    Le test de Hausman tranche, mais l’argument théorique reste le plus convaincant devant un jury.

    La séquence, en pratique

    Sous Stata, la manipulation tient en quelques commandes. Tout commence par déclarer la structure de panel, sans quoi aucune commande xt ne fonctionnera :

    1. xtset id annee — déclare l’identifiant individuel et la variable temporelle.
    2. xtdescribe — décrit le panel : nombre d’unités, nombre de périodes, degré de déséquilibre. À faire systématiquement, et à rapporter dans le mémoire.
    3. xtsum — décompose la variance de chaque variable en composantes between et within. Lecture essentielle : une variable dont la variation within est quasi nulle ne pourra pas être estimée en effets fixes.
    4. xtreg y x1 x2 x3, fe — le modèle à effets fixes.
    5. estimates store fixe, puis xtreg y x1 x2 x3, re et estimates store aleatoire.
    6. hausman fixe aleatoire — le test d’arbitrage.
    7. xtreg y x1 x2 x3, fe vce(cluster id) — l’estimation finale, avec erreurs standard groupées.

    Cette dernière étape n’est pas optionnelle. Les erreurs standard groupées au niveau de l’individu corrigent l’autocorrélation résiduelle et l’hétéroscédasticité à l’intérieur de chaque unité. Sans elles, vous retombez sur le problème de significativité gonflée que le passage au panel était censé résoudre. La convention est de grouper au niveau où le traitement varie, c’est-à-dire l’unité individuelle dans la plupart des mémoires.

    Une remarque sur le nombre de clusters : la correction fonctionne bien avec un nombre confortable de groupes. Avec une quinzaine d’unités seulement, elle devient peu fiable, et il faut le signaler en limite plutôt que de faire comme si de rien n’était.

    Ajouter les effets temporels

    Un ajout presque toujours justifié : xtreg y x1 x2 x3 i.annee, fe vce(cluster id). Les indicatrices annuelles absorbent tous les chocs communs à l’ensemble des unités une année donnée — une crise financière, une réforme nationale, une pandémie. On parle alors de modèle à doubles effets fixes, individus et périodes, et c’est la spécification standard en économie appliquée contemporaine. Sans elle, une tendance commune peut être attribuée à tort à votre variable d’intérêt.

    Faut-il vraiment Stata ?

    Non, et il faut le dire clairement parce que la question bloque beaucoup d’étudiants. Stata domine dans les départements d’économie français pour une raison pratique : sa syntaxe xt est extrêmement concise et sa documentation panel est excellente. Mais les alternatives font exactement la même chose.

    Logiciel Panel Accès
    Stata Suite xt native Payant, souvent en salle informatique
    R Package plm, fixest Gratuit
    Python linearmodels Gratuit
    SPSS Possible mais peu adapté Licence universitaire

    Le choix n’a aucune incidence sur la validité de vos résultats — seulement sur votre temps d’apprentissage. Notre comparatif entre R, Python et SPSS détaille l’arbitrage. La règle pragmatique : utilisez ce que votre département enseigne et ce sur quoi votre directeur pourra vous dépanner. Indiquez toujours le logiciel et sa version dans votre méthodologie.

    Ce qu’il faut rapporter

    Un tableau de résultats de panel bien construit contient : les coefficients avec leurs erreurs standard groupées entre parenthèses, le nombre d’observations et le nombre d’unités (les deux, toujours), le R² within, la mention explicite des effets fixes individus et années, et le niveau de clustering.

    Modèle de phrase : « Le panel est constitué de 27 pays observés annuellement de 2010 à 2024, soit 405 observations pour un panel cylindré. Le test de Hausman rejette l’hypothèse d’absence de corrélation entre les effets individuels et les régresseurs (χ² = 24,18 ; p < 0,001), conduisant à retenir le modèle à effets fixes. Des indicatrices annuelles ont été introduites afin de contrôler les chocs communs, et les erreurs standard sont groupées au niveau du pays. »

    Un coefficient : « Toutes choses égales par ailleurs et à effets pays et année contrôlés, une hausse d’un point du taux d’investissement est associée à une hausse de 0,21 point du taux de croissance (erreur standard groupée = 0,08 ; p = 0,012). »

    Comme toujours, est associé à plutôt que cause. Les effets fixes éliminent les biais liés aux caractéristiques stables non observées ; ils ne règlent ni la causalité inverse, ni les variables omises qui varient dans le temps.

    Où trouver les données

    La contrainte pratique du mémoire d’économie est moins statistique que documentaire : il faut un panel réellement exploitable. Les sources ouvertes qui produisent des panels immédiatement utilisables sont les grands producteurs institutionnels — bases macroéconomiques internationales, statistique publique française, données d’entreprises issues des registres légaux. Le guide méthodologique du mémoire de finance et comptabilité aborde la constitution d’échantillons d’entreprises, et notre article sur les sujets de mémoire en économie peut aider à cadrer une question compatible avec les données disponibles.

    Un conseil qui fait gagner des semaines : vérifiez la disponibilité des données avant d’arrêter votre sujet, pas après. Un panel séduisant sur le papier devient inexploitable si la variable centrale n’est renseignée que pour la moitié des pays et seulement depuis 2018. Contrôlez la couverture, la profondeur temporelle et la complétude avant de vous engager — un problème de la même famille que celui des données manquantes, mais qui se règle au stade du sujet.

    Rédiger le chapitre méthodologie

    Un mémoire d’économétrie se joue autant sur la rédaction que sur l’estimation. Il faut justifier la structure de panel, motiver le choix de spécification, expliquer les corrections apportées, et discuter honnêtement ce que votre identification permet ou non de conclure.

    Tesify vous accompagne sur cette rédaction : structurer les chapitres données, méthodologie et résultats, garder une terminologie cohérente d’un bout à l’autre, et transformer vos décisions d’estimation en argumentation écrite. Vos données et vos modèles restent les vôtres, et le texte est écrit à 100 % par vous.

    Rédiger votre mémoire d’économie avec Tesify

    Questions fréquentes

    Faut-il absolument Stata pour un mémoire sur données de panel ?

    Non. R avec plm ou fixest fait la même chose gratuitement, et Python avec linearmodels également. Stata reste la référence dans beaucoup de départements d’économie parce que sa syntaxe panel est très concise et son manuel excellent, mais le choix du logiciel n’a aucun effet sur la validité des résultats. Prenez celui que votre département enseigne.

    Mon panel n’est pas cylindré : est-ce un problème ?

    Pas en soi — les estimateurs de panel gèrent parfaitement les panels non cylindrés. Ce qui compte, c’est la cause du déséquilibre. Si des entreprises disparaissent de l’échantillon parce qu’elles ont fait faillite et que la faillite est liée à votre variable dépendante, vous avez une attrition sélective : un biais de sélection qu’il faut discuter, et non un simple déséquilibre technique.

    Le test de Hausman rejette : que faire ?

    Retenez le modèle à effets fixes. C’est le résultat le plus fréquent en économie appliquée et c’est aussi le choix le plus prudent, puisque les effets fixes restent convergents même quand l’hypothèse des effets aléatoires tient. Le prix à payer est l’impossibilité d’estimer les variables invariantes dans le temps.

    Puis-je estimer l’effet d’une variable qui ne change pas dans le temps ?

    Pas en effets fixes : l’estimateur within élimine tout ce qui est constant par unité, donc ces coefficients ne sont pas identifiables et le logiciel les retirera. Si ces variables sont précisément votre objet d’étude, c’est l’argument le plus sérieux en faveur des effets aléatoires — à condition d’assumer et de discuter l’hypothèse de non-corrélation. Des approches intermédiaires existent, mais elles dépassent le cadre habituel d’un mémoire de master.

    Combien d’unités et de périodes faut-il au minimum ?

    Il n’existe pas de seuil réglementaire, mais deux contraintes pratiques se croisent. Il faut au moins deux périodes pour que les effets fixes aient un sens, et en réalité plutôt cinq ou plus pour disposer de variation within exploitable. Et il faut assez d’unités pour que les erreurs standard groupées soient fiables — en dessous d’une vingtaine, signalez-le en limite. Un panel de 30 unités sur 10 périodes est une base très confortable pour un mémoire de master.

    Quelle différence entre effets fixes et simplement ajouter des indicatrices individuelles ?

    Aucune sur le fond : c’est mathématiquement équivalent, et c’est d’ailleurs pour cela qu’on parle parfois de modèle LSDV (least squares dummy variable). La commande dédiée est simplement plus efficace en calcul et évite d’encombrer votre sortie de centaines de coefficients d’indicatrices dont vous n’avez que faire. Sur un panel de 180 entreprises, la différence de lisibilité est considérable.

  • Analyse de modération sous SPSS : effet d’interaction, PROCESS et pentes simples (2026)

    Analyse de modération sous SPSS : effet d’interaction, PROCESS et pentes simples (2026)

    Votre hypothèse H3 ressemble sans doute à ceci : « l’effet du stress perçu sur l’épuisement professionnel est plus fort lorsque le soutien social est faible ». Ou : « la relation entre l’ancienneté et la performance est plus marquée dans les petites structures ».

    Ces énoncés ont tous la même forme. Vous ne dites pas que X influence Y. Vous dites que l’intensité de cet effet dépend d’une troisième variable. C’est une hypothèse de modération, et elle ne se teste pas en ajoutant simplement cette troisième variable au modèle.

    C’est l’erreur la plus fréquente sur cette famille d’hypothèses, et elle est invisible : le modèle tourne, sort des coefficients lisibles, et ne teste pas ce que l’étudiant croit qu’il teste. Voici la procédure correcte, la lecture de la sortie et les deux pièges classiques.

    Modération et médiation ne répondent pas à la même question

    Ces deux notions sont systématiquement confondues, alors que la distinction tient en une phrase.

    • La médiation répond à pourquoi et par quel chemin X influence Y. La variable intermédiaire M transmet l’effet : X agit sur M, qui agit sur Y.
    • La modération répond à pour qui, quand et dans quelles conditions. La variable W ne transmet rien : elle règle l’intensité, voire le signe, de la relation entre X et Y.

    Le test diagnostique est simple. Si votre variable supplémentaire est une conséquence de X, vous êtes en médiation. Si elle préexiste à X et n’en dépend pas — le sexe, la taille de l’entreprise, un trait de personnalité, l’ancienneté —, vous êtes en modération. Notre guide de l’analyse de médiation avec la macro PROCESS traite le cas symétrique en détail.

    Un point de vocabulaire, parce qu’il rassure : modération, effet d’interaction et effet modérateur désignent la même chose. La psychologie dit « modération », l’économétrie dit « interaction ».

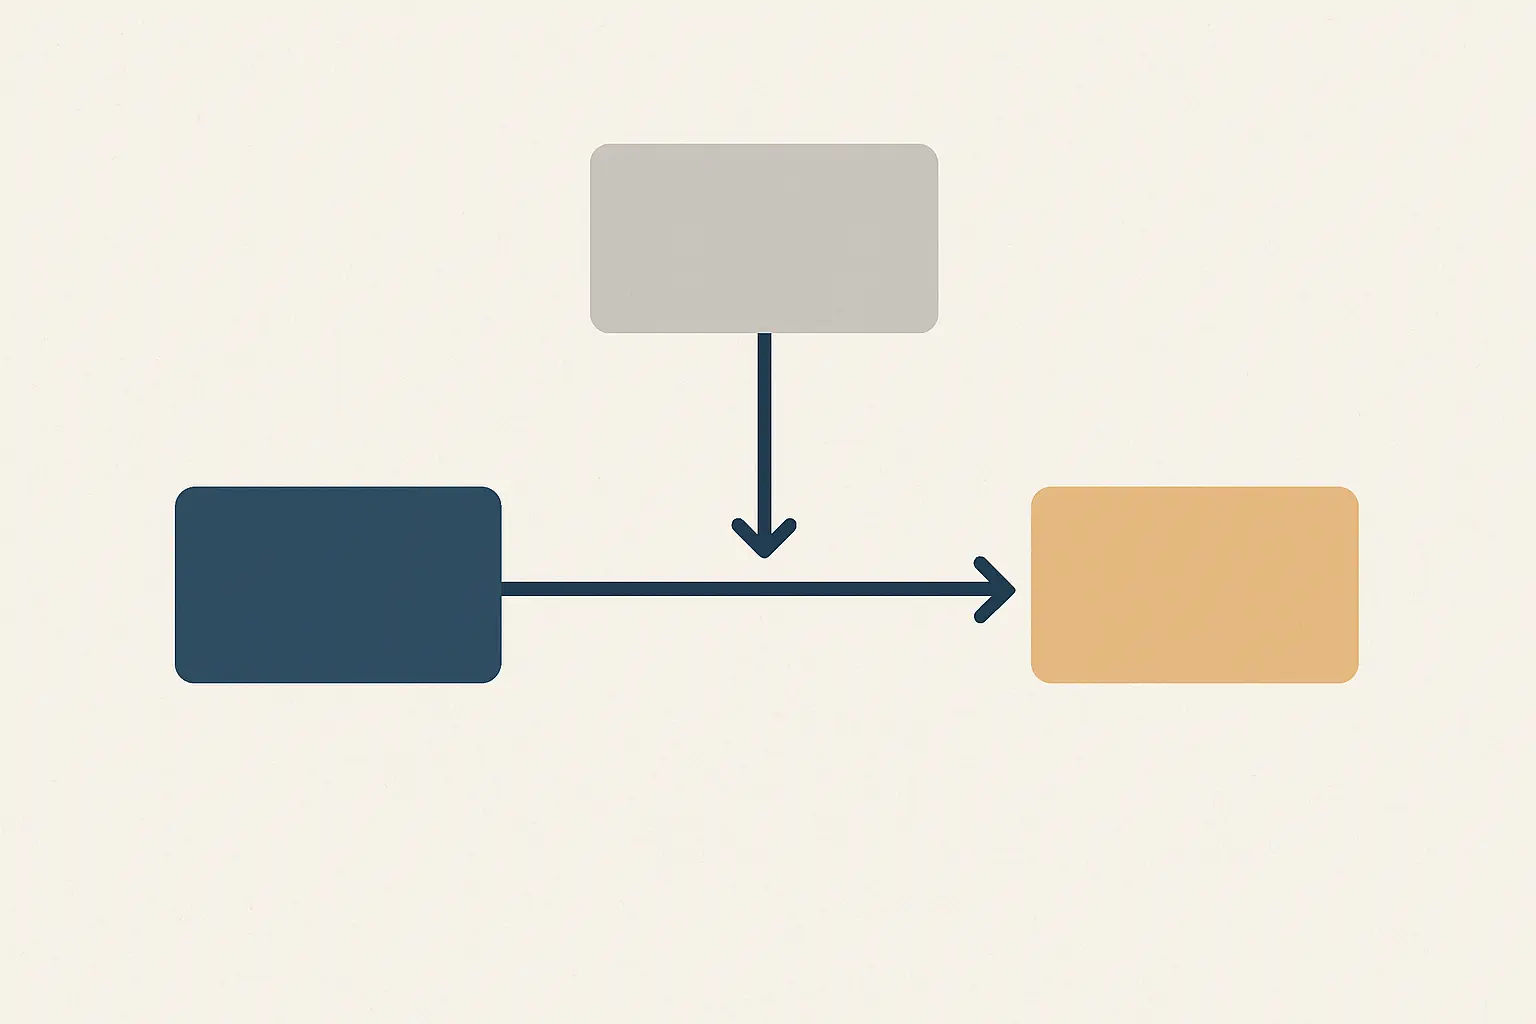
    Schéma d'un modèle de modération : une variable agit sur la relation entre deux autres
    Le modérateur ne pointe pas vers Y : il pointe vers la flèche qui relie X à Y.

    Le principe : un terme produit

    Une modération se teste en ajoutant à votre régression une variable supplémentaire : le produit de la variable indépendante par le modérateur. Le modèle complet comporte donc trois prédicteurs : X, le modérateur W, et le terme d’interaction X × W.

    Les deux premiers doivent impérativement figurer dans le modèle en même temps que le troisième. Un terme d’interaction sans ses composantes n’est pas interprétable — c’est une contrainte, pas une convention.

    L’intuition derrière le produit est la suivante : le coefficient de X × W indique de combien la pente de X sur Y change quand W augmente d’une unité. S’il est nul, la pente de X est la même partout, et il n’y a pas de modération. S’il est non nul, la pente varie selon le niveau de W — ce qui est précisément votre hypothèse.

    Faut-il centrer les variables ? Oui, mais pas pour la raison qu’on vous a donnée

    Le conseil universel est de centrer X et W sur leur moyenne avant de calculer le produit. Il est bon, mais la justification qui l’accompagne est presque toujours fausse.

    Ce qu’on vous dira : « il faut centrer pour éliminer la multicolinéarité entre le produit et ses composantes ». Il est vrai que X × W est mécaniquement très corrélé à X et à W, et que le centrage fait chuter les facteurs d’inflation de la variance (VIF) de façon spectaculaire.

    Ce qu’on ne vous dira pas : cela ne change absolument rien au test. Le coefficient du terme d’interaction, son erreur standard, son t, sa p-valeur et le R² du modèle sont rigoureusement identiques avec ou sans centrage. Ce sont les mêmes chiffres. La colinéarité introduite par un terme produit est dite « non essentielle » : elle vient du choix de l’origine de l’échelle, pas d’une redondance réelle entre les variables, et le centrage ne fait que déplacer cette origine.

    Le centrage a néanmoins un vrai bénéfice, et c’est lui qu’il faut invoquer devant un jury : l’interprétabilité. Sur variables centrées, le coefficient de X se lit comme l’effet de X lorsque W est à sa moyenne — une valeur qui existe dans votre échantillon. Sur variables brutes, il se lit comme l’effet de X lorsque W vaut zéro, ce qui peut désigner un âge de zéro an ou un score de satisfaction impossible.

    Conséquence pratique : ne rapportez jamais un VIF élevé sur un terme d’interaction comme un problème, et ne supprimez surtout pas une variable pour cette raison — c’est un artefact d’échelle.

    La procédure sous SPSS

    SPSS n’a pas de boîte de dialogue « modération ». Deux chemins sont possibles, et ils donnent le même test.

    Voie 1 — la régression hiérarchique manuelle

    Elle a l’avantage d’être transparente : vous voyez exactement ce que vous faites, ce qui est appréciable si votre jury vous interroge sur la construction du modèle.

    1. Centrer. Transformer > Calculer la variable : créez X_c = X - moyenne(X) et W_c = W - moyenne(W). Relevez les moyennes au préalable avec Analyse > Statistiques descriptives.
    2. Créer le produit. Transformer > Calculer la variable : XW = X_c * W_c.
    3. Bloc 1. Analyse > Régression > Linéaire. Variable dépendante : Y. Indépendantes : X_c et W_c, plus vos éventuelles variables de contrôle.
    4. Bloc 2. Cliquez sur Suivant et ajoutez XW seul dans ce second bloc.
    5. Options. Dans Statistiques, cochez Variation de R-deux. C’est cette case qui produit le chiffre que vous allez rapporter.

    Toutes les conditions d’application de la régression linéaire multiple s’appliquent ici sans changement : linéarité, indépendance et normalité des résidus, homoscédasticité.

    Voie 2 — la macro PROCESS, modèle 1

    PROCESS, développée par Andrew F. Hayes, est téléchargeable gratuitement et s’installe comme une extension SPSS. Le modèle 1 est celui de la modération simple.

    Son intérêt est de produire automatiquement tout ce qui vient après la régression : le centrage, le terme produit, les effets conditionnels aux différents niveaux du modérateur, la région de significativité et les données du graphique. C’est plusieurs heures de manipulation en moins, et beaucoup moins d’occasions de se tromper.

    Sortie logicielle stylisée avec la ligne du terme d'interaction mise en évidence
    Une seule ligne de la sortie décide du sort de votre hypothèse : celle du terme produit.

    Lire la sortie sans se tromper

    Une seule ligne décide

    Toute votre hypothèse tient sur la ligne du terme d’interaction. Si sa p-valeur est inférieure à 0,05, la modération est établie ; sinon, elle ne l’est pas. En régression hiérarchique, le ΔR² du bloc 2 donne la même information sous une forme plus parlante : la part de variance de Y expliquée en plus par le fait de tenir compte de l’interaction. Les deux tests sont équivalents dans le cas d’un modérateur unique.

    Le piège des « effets principaux »

    Voici l’erreur qui coûte le plus de points en soutenance. Dans un modèle avec terme d’interaction, le coefficient de X n’est pas l’effet moyen de X. C’est l’effet de X lorsque W vaut zéro — c’est-à-dire, sur variables centrées, lorsque W est à sa moyenne. On parle d’effet conditionnel, et non d’effet principal.

    Deux conséquences que les jurys aiment vérifier :

    • Un coefficient de X non significatif dans le modèle avec interaction ne signifie pas que X n’a pas d’effet. Il peut avoir un effet fort chez les uns, un effet inverse chez les autres, et une moyenne proche de zéro.
    • Inversement, si l’interaction est significative, commenter longuement les coefficients de X et de W comme s’il s’agissait d’effets généraux est une faute d’interprétation.

    C’est la même logique que celle de l’ANOVA factorielle, où une interaction significative impose de ne plus interpréter les effets principaux tels quels, mais d’aller décomposer les effets simples.

    Décomposer : les pentes simples

    Savoir que l’effet varie ne dit pas encore comment. La décomposition consiste à estimer la pente de X sur Y à plusieurs niveaux choisis de W — conventionnellement à la moyenne, à un écart-type en dessous et à un écart-type au-dessus. PROCESS fournit ces trois pentes avec leur test de significativité.

    C’est là que le résultat devient racontable : « chez les répondants à faible soutien social, l’effet du stress est fort ; chez ceux à soutien élevé, il n’est plus distinguable de zéro ».

    Quand le modérateur est continu, découper à ±1 écart-type reste arbitraire. La technique de Johnson-Neyman répond autrement : au lieu de tester trois points choisis d’avance, elle identifie la plage de valeurs de W sur laquelle l’effet de X est significatif. PROCESS la propose en option, et c’est un vrai plus dans un mémoire quantitatif.

    Le graphique n’est pas décoratif

    Une modération se comprend visuellement en deux secondes et se lit péniblement dans un tableau ; attendez-vous à ce qu’un jury regarde la figure avant les chiffres. La convention : X en abscisse, Y en ordonnée, une droite par niveau du modérateur. Des droites qui se croisent signalent une interaction disordinale, où l’effet change de signe selon le niveau du modérateur — le résultat le plus intéressant qu’on puisse obtenir sur ce type d’hypothèse.

    La vraie difficulté : la puissance

    Il faut le dire franchement, parce que beaucoup d’étudiants concluent trop vite à l’absence de modération. Les effets d’interaction sont notoirement difficiles à détecter dans les études de terrain. Le ΔR² attribuable à une interaction dépasse rarement quelques centièmes, même quand l’effet est réel et théoriquement solide. Le terme produit hérite en effet de l’erreur de mesure de ses deux composantes, et la variance restant à expliquer après X et W est faible par construction.

    Conséquence directe : une modération non significative sur un échantillon de 80 personnes n’est pas une réfutation, c’est le plus souvent un manque de puissance. Deux réflexes en découlent — dimensionner l’échantillon en amont avec un calcul de puissance sous G*Power, en visant le ΔR² et non l’effet global du modèle ; et, en aval, formuler la conclusion comme une non-détection plutôt que comme une absence d’effet.

    Une précaution de mesure, enfin : plus vos échelles sont fiables, plus vous avez de chances de détecter l’interaction. Soigner la fidélité d’une échelle de Likert n’est pas un détail de forme ici.

    Ce qu’il faut rapporter

    Un tableau de régression hiérarchique à deux blocs, avec pour chacun les coefficients standardisés et le R², et pour le bloc 2 le ΔR² et son test. Puis un tableau ou un paragraphe des pentes simples, et la figure.

    Modèle de phrase — le test : « Les variables ont été centrées avant construction du terme produit. L’introduction de l’interaction stress × soutien social au bloc 2 améliore significativement le modèle (ΔR² = 0,04 ; F(1, 212) = 9,87 ; p = 0,002), le coefficient du terme produit étant négatif (β = −0,21 ; p = 0,002). »

    Modèle de phrase — la décomposition : « L’analyse des pentes simples indique que l’effet du stress perçu sur l’épuisement est significatif lorsque le soutien social est faible (−1 ET : B = 0,48 ; p < 0,001), atténué au niveau moyen (B = 0,27 ; p = 0,004) et non significatif lorsque le soutien est élevé (+1 ET : B = 0,06 ; p = 0,52). »

    Modèle de phrase — un résultat nul : « Le terme d’interaction n’atteint pas le seuil de significativité (ΔR² = 0,01 ; p = 0,18). Compte tenu de la puissance limitée dont disposent les tests d’interaction sur un échantillon de cette taille, ce résultat est interprété comme une non-détection et non comme une preuve d’absence de modération. »

    Sur le choix de l’indicateur, notre guide des tailles d’effet selon le test employé détaille les conventions : pour une modération, c’est le ΔR², éventuellement converti en .

    Rédiger le chapitre qui va autour

    Le test lui-même prend une après-midi. Ce qui prend des semaines, c’est de justifier théoriquement pourquoi ce modérateur-là, d’articuler l’hypothèse H3 avec la revue de littérature, puis d’écrire une discussion qui explique ce que la décomposition des pentes signifie pour votre terrain.

    Tesify vous accompagne sur cette partie rédactionnelle : structurer l’argumentation qui amène l’hypothèse, garder une terminologie constante entre le cadre théorique, les résultats et la discussion, et transformer une sortie logicielle en texte académique défendable. Vos données et vos analyses restent les vôtres.

    Rédiger votre chapitre d’analyse avec Tesify

    Questions fréquentes

    Mon modérateur est une variable catégorielle : la procédure change-t-elle ?

    Le principe est identique, avec une étape en plus. Une variable à deux modalités se code en 0/1 et se multiplie directement à X. Au-delà de deux modalités, il faut créer k−1 indicatrices et autant de termes produits, puis tester leur apport conjoint au bloc 2 — c’est le ΔR² du bloc entier qui fait foi, pas chaque coefficient pris isolément. PROCESS gère ce cas nativement via son option pour modérateur multicatégoriel.

    Le terme d’interaction est significatif mais le coefficient de X ne l’est pas. Est-ce contradictoire ?

    Non, et c’est même une configuration très informative. Le coefficient de X représente son effet au niveau moyen du modérateur ; il peut être proche de zéro parce qu’un effet positif chez les uns compense un effet négatif chez les autres. Décomposez en pentes simples : vous découvrirez probablement une interaction disordinale, où la relation s’inverse selon le niveau de W. C’est un résultat fort, à condition de le présenter comme tel.

    Dois-je vraiment centrer si le logiciel donne les mêmes p-valeurs ?

    Le test est effectivement inchangé, mais centrez quand même. Sans centrage, le coefficient de X s’interprète à W = 0, une valeur souvent impossible dans votre échantillon, ce qui rend le tableau ininterprétable pour votre lecteur. Le centrage ne change pas le résultat : il change ce que vos autres coefficients veulent dire. PROCESS centre automatiquement lorsque l’option correspondante est activée.

    Peut-on tester une modération dans une régression logistique ?

    Oui, la logique du terme produit est identique et PROCESS accepte une variable dépendante binaire. L’interprétation demande plus de soin, parce que les coefficients sont des logarithmes de rapports de cotes et que leur addition ne se lit pas aussi directement que dans le cas linéaire. Sur un mémoire de master, appuyez-vous surtout sur les effets conditionnels et sur une représentation graphique des probabilités prédites.

    Combien de participants faut-il pour tester une modération ?

    Il n’existe pas de nombre magique, et les règles empiriques du type « 10 observations par prédicteur » sont trompeuses ici : elles suffisent pour estimer le modèle, pas pour détecter une interaction. Le calcul de puissance doit porter sur le ΔR² attendu, qui est petit. À titre d’ordre de grandeur, détecter un ΔR² de 0,02 avec une puissance de 80 % demande couramment plus de 350 participants. En dessous de 150, considérez qu’un résultat nul n’est pas concluant et dites-le dans vos limites.

    Puis-je tester plusieurs modérateurs dans le même mémoire ?

    Techniquement oui, mais séparément et avec parcimonie. Empiler les interactions multiplie les tests, épuise la puissance et ouvre la porte au sur-ajustement. Le meilleur usage en mémoire de master est un seul modérateur, choisi et justifié théoriquement avant de regarder les données. Une modération testée après coup parce que le résultat principal était décevant se voit immédiatement, et un jury la sanctionnera.

  • Annuaire 2026 : chaque condition statistique et son plan de secours

    Annuaire 2026 : chaque condition statistique et son plan de secours

    Il est tard, SPSS vient de vous rendre un test de conditions significatif, et vous cherchez une seule information : qu’est-ce que je fais maintenant ?

    Cette page est faite pour ça. Elle réunit les onze conditions d’application qu’un mémoire quantitatif rencontre réellement, et pour chacune : comment on la diagnostique, quel seuil s’applique, ce qu’on fait quand elle échoue, et où lire le détail.

    Un principe la traverse. Une condition violée n’invalide presque jamais un mémoire. Chacune a une correction ou une alternative documentée. Ce qu’un jury sanctionne, ce n’est pas une condition non respectée — c’est une condition non testée, ou testée puis ignorée.

    Le tableau de correspondance

    Condition Diagnostic Seuil Plan de secours
    Normalité (2 groupes) Shapiro-Wilk + Q-Q plot p < 0,05 Mann-Whitney, ou test t si n > 30
    Normalité (3 groupes et +) Shapiro-Wilk par groupe p < 0,05 Kruskal-Wallis
    Normalité des résidus (régression) Q-Q plot des résidus Écart visuel net Bootstrap des IC
    Variances égales (2 groupes) Levene p < 0,05 Ligne « variances inégales » (Welch)
    Variances égales (3 groupes et +) Levene p < 0,05 ANOVA de Welch + Games-Howell
    Sphéricité (mesures répétées) Mauchly + epsilon p < 0,05 Greenhouse-Geisser ou Huynh-Feldt
    Homoscédasticité (régression) Nuage résidus × prédites Forme d’entonnoir Transformation log, ou erreurs standard robustes
    Multicolinéarité VIF et tolérance VIF > 10 (alerte dès 5) Retirer, combiner, ou assumer
    Indépendance des résidus Durbin-Watson Hors 1,5-2,5 Modèle multiniveau ou mesures répétées
    Linéarité Nuage résidus × prédites Courbure visible Terme quadratique, transformation, découpage en classes
    Absence de points influents Distance de Cook > 1 Analyse de sensibilité avec et sans
    Chaque condition d'application reliée à sa solution de repli
    À chaque condition correspond une route de repli identifiée. Aucune ne mène à l’abandon du modèle.

    Les conditions, une par une

    1 et 2. La normalité

    C’est la condition la plus testée et la plus mal comprise. Trois choses à savoir. D’abord, en régression, elle porte sur les résidus, pas sur vos variables brutes — tester la normalité de la variable dépendante ne renseigne pas sur la validité du modèle. Ensuite, au-delà d’une trentaine d’observations par groupe, le théorème central limite rend les tests paramétriques très robustes à un écart modéré. Enfin, le test de Shapiro-Wilk souffre du défaut de tous les tests de conditions : il ne détecte rien sur petit échantillon et devient significatif pour un rien sur grand échantillon.

    Regardez donc toujours le Q-Q plot à côté du test. Détail complet dans notre article sur le test de Shapiro-Wilk et l’interprétation de la normalité.

    Replis : pour deux groupes indépendants, Mann-Whitney ; pour deux mesures appariées, le test de Wilcoxon ; pour plusieurs mesures répétées, le test de Friedman.

    4 et 5. L’homogénéité des variances

    Le test de Levene répond à une question — les groupes sont-ils également dispersés ? — et à une seule. Il ne dit rien de la normalité, et c’est la source de l’erreur la plus répandue : basculer vers un test non paramétrique parce que Levene est significatif.

    La bonne réponse est paramétrique. Pour deux groupes, c’est la ligne « variances inégales » du tableau du test t, c’est-à-dire la correction de Welch. Pour trois groupes ou plus, c’est l’ANOVA de Welch, assortie du post-hoc de Games-Howell — un enchaînement détaillé dans notre article sur les variances inégales entre Welch, Games-Howell et Kruskal-Wallis.

    Nuance utile : l’ANOVA reste raisonnablement robuste à l’hétérogénéité quand les effectifs sont équilibrés. Le scénario dangereux est celui du petit groupe très dispersé face au grand groupe homogène.

    6. La sphéricité

    Elle ne concerne que les plans à mesures répétées comportant au moins trois niveaux — avec deux mesures, elle est vérifiée par construction et SPSS n’affiche aucun test. Le test de Mauchly l’évalue, mais les colonnes epsilon situées à sa droite sont plus informatives, car elles mesurent l’ampleur de l’écart.

    Le repli est intégré : SPSS calcule d’office les lignes Greenhouse-Geisser et Huynh-Feldt. Règle usuelle : epsilon inférieur à 0,75 → Greenhouse-Geisser ; au-dessus → Huynh-Feldt. Procédure complète dans notre guide de l’ANOVA à mesures répétées.

    7, 8, 9, 10 et 11. Les conditions de la régression

    La régression en concentre cinq à elle seule, plus le diagnostic des points influents. Deux d’entre elles se lisent sur le même graphique — le nuage des résidus standardisés en fonction des valeurs prédites : une courbure signale un problème de linéarité, une forme d’entonnoir un problème d’homoscédasticité. Les autres se lisent dans les tableaux : Durbin-Watson pour l’indépendance, VIF et tolérance pour la multicolinéarité.

    Le détail de la procédure et des cinq replis se trouve dans notre guide de la régression linéaire multiple sous SPSS, et la multicolinéarité — celle qui produit les contresens les plus coûteux — a son article dédié : multicolinéarité et VIF. Pour un modèle à variable dépendante binaire, les conditions changent : voyez la régression logistique binaire.

    Les conditions qui ne se testent pas

    Trois conditions décisives ne produisent aucune p-value, et ce sont souvent celles qui coûtent le plus cher.

    La nature de vos variables. Continue, ordinale, nominale ? Aucun logiciel ne vous arrêtera si vous calculez une moyenne sur une variable nominale codée 1, 2, 3. Le cas limite le plus fréquent concerne les échelles de Likert : un item unique est ordinal, un score composite d’échelle est traité comme continu.

    L’indépendance des observations. Elle relève du design, pas du calcul. Si vous avez interrogé trente élèves dans chacune de cinq classes, vos observations ne sont pas indépendantes, quelle que soit la valeur de Durbin-Watson.

    La puissance. Une condition respectée sur vingt participants ne rachète pas un échantillon trop petit pour détecter l’effet attendu. Le calcul de taille d’échantillon avec G*Power se fait avant la collecte, jamais après.

    À cela s’ajoute une condition invisible : la complétude. La suppression listwise par défaut peut réduire silencieusement votre N d’un tiers — voyez notre article sur les données manquantes.

    Le paragraphe de contrôle des conditions à écrire dans le mémoire
    Dix lignes en début de section résultats suffisent — et elles manquent dans la majorité des mémoires.

    Le paragraphe à écrire

    Toutes ces vérifications tiennent en un paragraphe placé en tête de votre section résultats, avant le premier test commenté. Sa structure :

    1. Les conditions testées et l’instrument utilisé pour chacune.
    2. Les valeurs obtenues, avec les statistiques et les seuils.
    3. Pour chaque condition violée : la correction retenue et sa justification.
    4. Le cas échéant, l’analyse de sensibilité qui montre que les conclusions tiennent.

    Modèle : « Les conditions d’application ont été vérifiées avant analyse. La normalité des distributions, examinée par le test de Shapiro-Wilk et les diagrammes Q-Q, est satisfaite dans les trois groupes (p > 0,05). Le test de Levene indique en revanche une hétérogénéité des variances, F(2, 117) = 5,08, p = 0,008 ; l’ANOVA de Welch et le post-hoc de Games-Howell ont donc été retenus, conformément à la règle annoncée en méthodologie. Deux observations présentant une distance de Cook supérieure à 1, les analyses ont été réétablies sans elles : les conclusions demeurent inchangées. »

    Cinq phrases. Elles répondent par avance à la première question du jury, et elles montrent que vous savez ce que vous faites.

    La règle d’or : annoncer avant, exécuter après

    Un principe rend tout le reste défendable : vos règles de décision s’écrivent dans la méthodologie, avant d’avoir vu les résultats. Le seuil de VIF que vous retenez, la correction de sphéricité que vous appliquerez, le pourcentage de données manquantes au-delà duquel vous imputez — tout cela s’annonce en amont.

    Choisir la correction après coup en fonction de celle qui rend l’effet significatif porte un nom, et un jury le reconnaît immédiatement. Annoncer d’abord coûte trois phrases et vous protège entièrement, y compris — et surtout — quand les résultats ne vont pas dans le sens espéré. Sur la lecture du seuil lui-même, voyez notre article sur la p-value et le seuil de significativité, et n’oubliez pas de rapporter la taille d’effet adaptée à chaque test.

    Pour aller plus loin dans chaque famille de tests

    Écrire la méthodologie qui tient ces promesses

    Le travail réel n’est pas de cocher onze cases : c’est de tenir, sur cent pages, une cohérence entre la règle annoncée au chapitre 3 et le résultat commenté au chapitre 4, avec le même vocabulaire et les mêmes seuils.

    Tesify vous aide précisément là : structurer votre méthodologie, y inscrire vos règles de décision, et rédiger les justifications à partir de vos propres choix d’analyse — sans dérive de terminologie d’un chapitre à l’autre. Vos données et vos arbitrages restent les vôtres, et le texte est écrit à 100 % par vous.

    Structurer votre mémoire avec Tesify

    Questions fréquentes

    Faut-il tester toutes les conditions d’application ?

    Vous devez tester celles du test que vous employez, et les rapporter — pas les onze systématiquement. Un test t n’exige pas de vérifier la sphéricité. En revanche, ne rapporter aucune vérification est un signal négatif fort : un jury sanctionne beaucoup plus une condition non testée qu’une condition violée et assumée, parce que la première laisse penser que le résultat n’a jamais été contrôlé.

    Une condition violée invalide-t-elle mon mémoire ?

    Presque jamais. Chacune des conditions de ce tableau dispose d’une correction ou d’une alternative documentée, et la plupart tiennent en une case à cocher. Une condition violée est une bifurcation méthodologique que vous documentez, pas un échec. Ce qui pose problème, c’est de constater la violation et de rapporter quand même le test non corrigé.

    Dans quel ordre vérifier les conditions ?

    Avant de commenter le moindre résultat — c’est le point essentiel. L’ordre pratique : nature des variables, indépendance des observations, normalité, homogénéité des variances, puis les conditions propres au modèle (sphéricité, multicolinéarité, linéarité). Lire un tableau dans le mauvais ordre conduit à s’étonner d’un résultat dont l’explication figurait deux colonnes plus loin.

    Les tests de conditions sont-ils fiables ?

    Ils partagent tous la même faiblesse : ils manquent de puissance sur les petits échantillons — où la violation ne sera pas détectée — et deviennent significatifs pour des écarts triviaux sur les grands. Complétez-les donc systématiquement par un examen graphique et par l’ampleur de l’écart observé. Un Levene significatif accompagné d’un rapport de variances de 1,3 ne dit pas la même chose qu’un rapport de 9.

    Mon logiciel n’a pas l’option dont j’ai besoin : que faire ?

    C’est fréquent, en particulier pour les modules SPSS complémentaires absents de certaines licences universitaires. Trois voies : vérifier si l’option existe ailleurs dans le logiciel (l’ANOVA de Welch n’est pas dans le Modèle linéaire général mais bien dans l’ANOVA à un facteur), passer par un logiciel gratuit qui la propose, ou choisir une alternative disponible en le justifiant. Dans tous les cas, indiquez la version et le logiciel utilisés dans votre méthodologie.

  • Variances inégales sur trois groupes : Welch, Games-Howell ou Kruskal-Wallis ? (2026)

    Variances inégales sur trois groupes : Welch, Games-Howell ou Kruskal-Wallis ? (2026)

    Vous comparez trois groupes ou plus. Vous lancez l’ANOVA, et SPSS vous rend d’abord le test de Levene : p = 0,008. Les variances ne sont pas homogènes.

    Le réflexe quasi universel, à ce moment-là, est de fermer l’ANOVA et de basculer vers Kruskal-Wallis, « le test non paramétrique ». C’est presque toujours le mauvais choix, et il vous coûte de la puissance statistique pour rien.

    Cet article compare les trois routes réellement disponibles, et donne la règle qui permet de trancher.

    La confusion de départ : deux conditions différentes

    L’ANOVA repose sur plusieurs conditions, dont deux qu’on mélange constamment :

    • La normalité — la distribution de la variable dans chaque groupe.
    • L’homogénéité des variances (homoscédasticité) — le fait que les groupes soient également dispersés.

    Le test de Levene ne teste que la seconde. Un Levene significatif ne vous dit rien sur la normalité de vos données.

    Or Kruskal-Wallis est la réponse à un problème de distribution : il abandonne les moyennes pour travailler sur les rangs. Il ne corrige pas l’hétérogénéité des variances — il change de question. L’utiliser pour répondre à un Levene significatif, c’est prendre un médicament pour une maladie qu’on n’a pas, tout en subissant ses effets secondaires : une perte de puissance, l’impossibilité de rapporter des moyennes, et une interprétation moins directe.

    La correction faite pour l’hétérogénéité des variances existe, elle est paramétrique, et elle s’appelle Welch. C’est exactement la même logique que pour deux groupes, où un Levene significatif conduit à la ligne « variances inégales » du test t plutôt qu’à Mann-Whitney — un mécanisme détaillé dans notre guide du test t et de Mann-Whitney. Avec trois groupes, la logique ne change pas ; seul le nom du test change.

    Trois boîtes à moustaches de dispersions très différentes
    Des variances inégales, ce sont des boîtes de tailles différentes. Cela ne dit rien de la forme des distributions.

    Route 1 — L’ANOVA de Welch

    Quand : variances inégales, distributions à peu près normales dans chaque groupe. C’est le cas le plus fréquent, et la bonne réponse par défaut.

    Ce qu’elle fait : exactement ce que fait la correction de Welch pour deux groupes. Elle ne suppose plus l’égalité des variances et ajuste les degrés de liberté en conséquence, ce qui produit des degrés de liberté décimaux et un test valide.

    Sous SPSS : Analyse → Comparer les moyennes → ANOVA à un facteur, bouton Options, cochez Welch ainsi que Test d’homogénéité de la variance et Descriptives.

    Attention à un piège de navigation qui explique beaucoup de confusions : cette option n’existe pas dans Modèle linéaire général → Univarié, la procédure que beaucoup d’étudiants utilisent par habitude. Il faut passer par ANOVA à un facteur. SPSS affiche alors un tableau Tests robustes d’égalité des moyennes contenant Welch et Brown-Forsythe.

    Brown-Forsythe, présenté dans le même tableau, est une alternative de même famille. Welch est généralement préféré, sa puissance étant meilleure dans la plupart des configurations ; Brown-Forsythe garde un avantage lorsque les distributions sont fortement asymétriques. Les deux sont défendables ; rapportez celui que vous avez annoncé.

    Route 2 — Le post-hoc de Games-Howell

    Welch vous dit que les groupes ne sont pas tous égaux. Il ne vous dit pas lesquels diffèrent. Il faut un test post-hoc — et là encore, le choix par défaut est piégeux.

    Tukey, le post-hoc le plus utilisé, suppose l’égalité des variances et des effectifs comparables. Si vous avez lancé Welch, c’est précisément parce que cette condition est violée : enchaîner sur Tukey annule l’intérêt de la correction et produit des seuils faux.

    Games-Howell est conçu pour ce cas exact. Il ne suppose ni variances égales ni effectifs égaux, et applique à chaque comparaison par paire la même logique de correction que Welch applique au test global.

    Sous SPSS : dans ANOVA à un facteur, bouton Post hoc, la fenêtre est divisée en deux zones. Games-Howell se trouve dans le bloc du bas, Variances non homogènes — que la plupart des étudiants ne remarquent jamais, parce que Tukey occupe le bloc du haut.

    Retenez donc l’appariement : Welch va avec Games-Howell, comme l’ANOVA classique va avec Tukey. Utiliser l’un sans l’autre est incohérent, et c’est visible.

    Arbre de décision entre ANOVA de Welch, Games-Howell et Kruskal-Wallis
    Deux questions suffisent : les distributions sont-elles à peu près normales, et les variances sont-elles homogènes ?

    Route 3 — Kruskal-Wallis, et quand il est réellement justifié

    Kruskal-Wallis reste le bon choix, mais pour d’autres raisons que l’hétérogénéité des variances :

    • Votre variable dépendante est ordinale — un rang, un stade, un item unique de Likert.
    • Les distributions sont franchement non normales dans plusieurs groupes, et vos effectifs sont trop petits pour compter sur la robustesse de l’ANOVA.
    • Vos groupes sont très petits, moins d’une quinzaine d’observations chacun, ce qui rend le diagnostic de normalité peu fiable.

    Deux limites à connaître avant de le choisir. D’abord, on lit souvent que Kruskal-Wallis « compare les médianes » : ce n’est vrai que si les distributions des groupes ont la même forme. Quand les variances diffèrent fortement — votre situation de départ — cette condition est justement mise en défaut, et le test compare alors des rangs moyens sans que l’interprétation médiane tienne. Ensuite, son post-hoc naturel sous SPSS est la comparaison par paires ajustée selon Dunn-Bonferroni, disponible en double-cliquant sur le résultat pour ouvrir la vue détaillée.

    Le test de Friedman en est l’équivalent lorsque vos groupes ne sont pas indépendants mais correspondent à des mesures répétées sur les mêmes participants.

    Le tableau de décision

    Situation Test global Post-hoc
    Normalité OK, variances homogènes ANOVA classique Tukey
    Normalité OK, variances inégales ANOVA de Welch Games-Howell
    Non-normalité franche, ou variable ordinale Kruskal-Wallis Dunn-Bonferroni
    Petits effectifs et distributions douteuses Kruskal-Wallis Dunn-Bonferroni

    Une nuance utile sur la première colonne : l’ANOVA est robuste à une non-normalité modérée dès que les groupes dépassent une trentaine d’observations, grâce au théorème central limite. Elle l’est en revanche beaucoup moins à l’hétérogénéité des variances quand les effectifs sont déséquilibrés. C’est le pire scénario : petit groupe à forte variance, grand groupe à faible variance. Dans cette configuration, Welch n’est pas une option de confort, il est nécessaire. Notre article sur le test de Shapiro-Wilk détaille le diagnostic de normalité qui alimente la première question.

    Rédiger le résultat

    Welch et Games-Howell : « Le test de Levene indique une hétérogénéité des variances, F(2, 117) = 5,08, p = 0,008. L’ANOVA de Welch, robuste à cette violation, a donc été retenue : elle révèle une différence significative entre les trois filières, F(2 ; 71,42) = 8,94, p < 0,001. Les comparaisons post-hoc de Games-Howell montrent que la filière A diffère significativement de la filière C (p = 0,002) et de la filière B (p = 0,031), tandis que B et C ne diffèrent pas (p = 0,214). »

    Kruskal-Wallis : « La variable dépendante étant ordinale, un test de Kruskal-Wallis a été retenu. Il révèle une différence significative entre les trois groupes, H(2) = 12,47, p = 0,002, ε² = 0,10. Les comparaisons par paires ajustées selon Dunn-Bonferroni situent la différence entre les groupes 1 et 3 (p = 0,004). »

    Notez encore les degrés de liberté décimaux de Welch — F(2 ; 71,42) — qui sont la signature de la correction, exactement comme pour les corrections de sphéricité.

    L’erreur qui reste la plus fréquente

    Elle consiste à lancer l’ANOVA classique, constater que Levene est significatif, et rapporter quand même le F de l’ANOVA classique en ajoutant une phrase du type « le test de Levene était significatif, ce qui constitue une limite de cette étude ».

    Ce n’est pas une limite : c’est une correction disponible en une case à cocher, dans le même menu, sans aucun coût. Un jury qui connaît SPSS le sait, et la phrase se retourne contre vous. La bonne conduite tient en trois secondes de clic et une phrase de méthode. Sur la lecture du seuil lui-même, voyez notre article sur la p-value et le seuil de significativité, et sur les plans à plusieurs facteurs, le guide de l’ANOVA factorielle.

    Mettre cette décision par écrit

    Une bifurcation méthodologique n’a de valeur que si elle est annoncée avant et justifiée après. Cela suppose que votre chapitre méthodologie contienne déjà la règle que vous appliquerez, et que votre chapitre résultats l’exécute sans contradiction.

    Tesify vous aide à tenir cette continuité : structurer la méthodologie, y inscrire vos règles de décision, et rédiger les passages de justification en gardant le même vocabulaire d’un bout à l’autre du mémoire. Vos analyses restent les vôtres, et le texte est écrit à 100 % par vous.

    Structurer votre méthodologie avec Tesify

    Questions fréquentes

    Le test de Levene est significatif : dois-je passer au non paramétrique ?

    Non, pas automatiquement. Levene teste l’égalité des variances, pas la normalité. La réponse adaptée est l’ANOVA de Welch, qui reste un test paramétrique sur les moyennes tout en corrigeant l’hétérogénéité. Kruskal-Wallis répond à un problème différent et vous fait perdre de la puissance si vous l’utilisez pour celui-ci.

    Où trouver l’ANOVA de Welch dans SPSS ?

    Dans Analyse → Comparer les moyennes → ANOVA à un facteur, bouton Options, case Welch. Elle n’existe pas dans Modèle linéaire général → Univarié, ce qui fait croire à beaucoup d’étudiants qu’elle est absente du logiciel. Le tableau produit s’intitule Tests robustes d’égalité des moyennes.

    Pourquoi Games-Howell plutôt que Tukey ?

    Tukey suppose des variances égales et des effectifs comparables ; Games-Howell ne suppose ni l’un ni l’autre. Si vous avez retenu Welch pour le test global, enchaîner sur Tukey est incohérent et produit des seuils erronés. Dans SPSS, Games-Howell se trouve dans le bloc Variances non homogènes de la fenêtre post-hoc, sous le bloc où figure Tukey.

    Kruskal-Wallis compare-t-il les médianes ?

    Pas exactement, et la nuance compte pour votre rédaction. Il compare les rangs moyens. Cela n’équivaut à une comparaison de médianes que si les distributions ont la même forme dans tous les groupes — une condition justement mise en défaut lorsque les variances diffèrent fortement. Formulez donc vos conclusions en termes de différence de distribution, pas de médiane, sauf si vous avez vérifié la similarité des formes.

    Que faire si Levene est significatif mais que les effectifs sont parfaitement équilibrés ?

    L’ANOVA classique est nettement plus robuste à l’hétérogénéité des variances quand les groupes ont des effectifs égaux. Beaucoup d’auteurs admettent alors de la conserver, en particulier si le rapport entre la plus grande et la plus petite variance reste inférieur à 4. Le coût de Welch étant nul, la conduite la plus sûre reste néanmoins de rapporter les deux et de constater qu’elles concordent.

    Faut-il tester Levene avant chaque ANOVA ?

    Oui, et cochez la case dès le départ plutôt que de relancer l’analyse. Sachez toutefois que Levene souffre du même défaut que tous les tests de conditions : il manque de puissance sur les petits échantillons et devient significatif pour un écart trivial sur les grands. Regardez donc aussi le rapport des variances et vos boîtes à moustaches, qui disent souvent plus que la p-value.

  • Données manquantes dans un mémoire : MCAR, MAR, MNAR et que faire (2026)

    Données manquantes dans un mémoire : MCAR, MAR, MNAR et que faire (2026)

    Vous avez recruté 180 répondants. Vous lancez votre régression, et sous le tableau SPSS écrit discrètement : N = 121.

    Cinquante-neuf personnes viennent de disparaître de votre analyse sans que rien ne vous ait prévenu. Vous n’avez perdu aucun questionnaire : vous venez de rencontrer la suppression listwise, le comportement par défaut de SPSS face aux données manquantes.

    C’est le point aveugle le plus coûteux des mémoires quantitatifs, parce qu’il est silencieux : aucun message d’erreur, aucun avertissement, juste un N plus petit en bas d’un tableau que personne ne lit.

    Pourquoi la perte est bien plus grande qu’elle n’en a l’air

    La suppression listwise exclut un participant de l’analyse entière dès qu’il lui manque une seule valeur sur une seule des variables du modèle.

    L’arithmétique est brutale. Imaginez cinq variables, chacune manquant chez seulement 8 % des répondants, et des non-réponses réparties indépendamment. La probabilité qu’un participant soit complet sur les cinq est de 0,92⁵, soit environ 0,66 : un tiers de votre échantillon disparaît alors qu’aucune variable ne dépassait 8 % de manquants.

    C’est ce mécanisme multiplicatif qui explique l’écart entre le N que vous annoncez fièrement en méthodologie et le N réel de vos tests. Et il a deux conséquences distinctes :

    • Une perte de puissance. Votre calcul de taille d’échantillon, si vous en avez fait un avec G*Power, portait sur 180 personnes, pas sur 121. Votre étude est devenue sous-dimensionnée en cours de route.
    • Un risque de biais. Bien plus grave. Si les personnes qui n’ont pas répondu diffèrent systématiquement de celles qui ont répondu, votre échantillon analysé n’est plus représentatif de votre échantillon recruté.
    Effet de la suppression listwise sur la taille de l'échantillon analysé
    Cinq variables à 8 % de manquants chacune suffisent à faire perdre un tiers des participants.

    Les trois mécanismes : MCAR, MAR, MNAR

    La typologie classique distingue trois mécanismes. Ce n’est pas du jargon décoratif : c’est ce qui détermine si votre traitement est acceptable ou non.

    MCAR — manquant complètement au hasard

    Missing Completely At Random. L’absence de réponse ne dépend de rien : ni de la variable elle-même, ni d’aucune autre variable mesurée. Un questionnaire papier dont une page s’est détachée, une panne de serveur pendant une heure, une erreur de saisie aléatoire.

    Conséquence : c’est le cas le plus favorable. La suppression listwise reste non biaisée — vous ne perdez que de la puissance, pas de la validité. C’est aussi le cas le plus rare.

    MAR — manquant au hasard conditionnellement

    Missing At Random, une appellation trompeuse : le manque n’est pas aléatoire, il est explicable par d’autres variables que vous avez mesurées. Exemple typique : les hommes de votre échantillon répondent moins souvent que les femmes à la question sur le revenu. Le manque dépend du sexe — que vous connaissez — et non du revenu lui-même une fois le sexe pris en compte.

    Conséquence : la suppression listwise devient biaisée, puisqu’elle surreprésente les femmes dans l’analyse. Mais la situation est récupérable : puisque le sexe est mesuré, une méthode d’imputation peut exploiter cette information. C’est le cas le plus fréquent en pratique, et celui pour lequel l’imputation multiple a été conçue.

    MNAR — manquant de façon non aléatoire

    Missing Not At Random. L’absence dépend de la valeur manquante elle-même. Les personnes aux revenus les plus élevés refusent de déclarer leur revenu ; les étudiants les plus en difficulté ne répondent pas au questionnaire sur le décrochage ; les patients dont l’état s’est aggravé ne reviennent pas au suivi.

    Conséquence : c’est le cas problématique, et aucune méthode statistique ne le résout, parce que l’information nécessaire n’a jamais été recueillie. La seule conduite honnête est de l’identifier, de l’expliquer, et d’en discuter la direction probable du biais dans vos limites.

    Trois configurations de données manquantes dans une matrice
    Le même pourcentage de cases vides peut relever de trois mécanismes très différents. C’est la configuration, pas le taux, qui décide.

    Comment savoir dans quel cas vous êtes

    On ne peut pas prouver le mécanisme, et il faut le dire ainsi dans le mémoire. On peut néanmoins l’étayer sérieusement en trois étapes, dont deux sont à la portée de tout mémoire de master.

    1. Quantifier. Dressez le pourcentage de manquants par variable, pas seulement pour l’ensemble. Une variable à 22 % et neuf variables à 1 % ne posent pas le même problème, et la première est peut-être simplement une question mal formulée.

    2. Comparer les répondants et les non-répondants. C’est l’analyse la plus utile et la plus négligée. Créez une variable indicatrice (1 = donnée manquante sur X, 0 = présente), puis comparez les deux groupes sur toutes vos autres variables avec des tests t et des khi-deux. Si aucune différence n’apparaît, l’hypothèse MCAR est plausible. Si les non-répondants sont significativement plus jeunes, ou concentrés dans une filière, vous êtes en MAR et vous savez sur quelle variable.

    3. Le test MCAR de Little. Disponible dans Analyse → Analyse des valeurs manquantes (module complémentaire Missing Values, absent de certaines licences universitaires). Un résultat non significatif est compatible avec MCAR. Deux réserves : il ne distingue jamais MAR de MNAR, et comme tout test de condition il perd de la puissance sur petit échantillon.

    Les quatre traitements, et lequel défendre

    Méthode Quand Risque
    Suppression listwise MCAR, et moins de 5 % de manquants Perte de puissance ; biais si MAR
    Suppression pairwise Matrices de corrélations N différent d’une cellule à l’autre ; matrice parfois incohérente
    Imputation par la moyenne À éviter Réduit la variance, affaiblit les corrélations
    Imputation multiple MAR, dès 5-10 % de manquants Plus lourde à décrire, mais c’est la référence

    Pourquoi l’imputation par la moyenne est un mauvais réflexe

    Elle paraît raisonnable et se fait en deux clics, ce qui explique sa popularité. Le problème est mécanique : remplacer trente valeurs manquantes par la moyenne place trente points exactement au centre de la distribution. Vous réduisez artificiellement la variance, donc l’écart-type, donc les erreurs standard — et vous affaiblissez toutes les corrélations impliquant cette variable, puisque trente paires ne portent plus aucune variation. Le biais va vers l’absence d’effet, et un jury attentif le repérera immédiatement. Si vous y recourez malgré tout, limitez-la à un pourcentage très faible et déclarez-le explicitement.

    L’imputation multiple, en pratique

    C’est aujourd’hui la méthode de référence sous hypothèse MAR, et elle est plus accessible qu’on ne le croit. Le principe : plutôt qu’une seule valeur de remplacement, on en génère plusieurs jeux plausibles (typiquement 5 à 20) en exploitant les corrélations avec les autres variables, on analyse chaque jeu séparément, puis on combine les résultats selon des règles qui tiennent compte de l’incertitude liée à l’imputation. C’est exactement ce que l’imputation par la moyenne oublie de faire.

    Sous SPSS : Analyse → Imputation multiple → Imputer les valeurs manquantes. Le logiciel produit un fichier empilé, et toutes les analyses ultérieures affichent automatiquement une ligne Résultats combinés. Comme le module Missing Values, cette procédure n’est pas incluse dans toutes les licences.

    Le cas particulier des items d’échelle

    Si un répondant a rempli 9 items sur 10 d’une échelle validée, le supprimer serait absurde. La pratique admise consiste à calculer son score comme la moyenne des items renseignés, à condition qu’il en ait complété une proportion suffisante — un seuil de 80 % est couramment retenu et facile à justifier.

    Deux précautions. Fixez et annoncez ce seuil avant de regarder vos données. Et vérifiez que les items inversés ont bien été recodés avant tout calcul de moyenne, sans quoi vous imputez du bruit — un point détaillé dans notre guide sur l’échelle de Likert et dans celui sur la construction d’un questionnaire. La cohérence interne se vérifie ensuite comme d’habitude, avec l’alpha de Cronbach.

    Ce que vous écrivez

    Cas simple : « Le taux de données manquantes est faible et n’excède pas 3,2 % pour aucune variable. La comparaison des répondants et des non-répondants ne révèle aucune différence significative sur l’âge, le sexe et la filière. L’hypothèse d’un mécanisme complètement aléatoire étant plausible, la suppression listwise a été retenue ; l’effectif analysé est de 168 sur les 180 recrutés. »

    Cas MAR traité : « La variable revenu présente 14,8 % de valeurs manquantes. Les non-répondants à cette question sont significativement plus âgés que les répondants, t(178) = 2,91, p = 0,004, ce qui oriente vers un mécanisme de type MAR. Une imputation multiple à 20 jeux, incluant l’âge, le sexe et le niveau de diplôme comme variables auxiliaires, a donc été réalisée ; les résultats rapportés sont les estimations combinées. Une analyse de sensibilité sur les cas complets conduit aux mêmes conclusions. »

    Cas MNAR assumé : « Les 22 participants perdus au suivi à trois mois présentaient des scores initiaux significativement plus élevés, ce qui suggère un mécanisme non aléatoire lié à la variable mesurée elle-même. Aucune méthode d’imputation ne permettant de corriger ce type de manque, les résultats du suivi doivent être lus comme portant sur une population dont les cas les plus sévères sont sous-représentés, ce qui conduit vraisemblablement à une sous-estimation de l’effet. »

    Cette dernière phrase est un modèle : elle nomme le mécanisme, reconnaît qu’il est irréparable, et indique la direction du biais. C’est ce dernier point qui distingue une limite bien traitée d’un aveu d’impuissance.

    L’analyse de sensibilité, votre meilleur argument

    Quelle que soit la méthode retenue, la démonstration la plus convaincante tient en une phrase : faites tourner votre analyse principale de deux façons — cas complets d’un côté, données imputées de l’autre — et comparez. Si les conclusions concordent, votre résultat ne dépend pas de votre choix de traitement, et vous venez de le prouver plutôt que de l’affirmer. Si elles divergent, c’est une découverte majeure qui appartient à votre discussion.

    C’est la même logique que pour les valeurs influentes en régression, et elle vaut pour toute décision d’analyse discutable. Sur l’organisation générale de cette étape, voyez notre guide complet de l’analyse de données et celui sur l’analyse quantitative sous SPSS et Excel.

    Écrire la section « traitement des données manquantes »

    Cette section fait dix lignes et elle est presque toujours absente. Elle doit contenir : le taux par variable, l’analyse répondants/non-répondants, le mécanisme retenu et son argument, la méthode de traitement, et l’analyse de sensibilité.

    Tesify vous aide à construire ce passage et à le tenir cohérent avec le reste de votre méthodologie : mêmes termes, mêmes seuils annoncés en amont et respectés en aval, et une justification rédigée à partir de vos propres décisions. Vos données restent les vôtres, et le texte est écrit à 100 % par vous.

    Rédiger votre méthodologie avec Tesify

    Questions fréquentes

    Quel pourcentage de données manquantes est acceptable dans un mémoire ?

    Aucun seuil n’est réglementaire. Un repère très répandu situe en dessous de 5 % par variable un niveau où le choix de traitement change rarement les conclusions. Mais le pourcentage compte moins que le mécanisme : 3 % de manquants concentrés sur les répondants les plus vulnérables est plus dommageable que 15 % répartis au hasard. Rapportez toujours le taux par variable, jamais un taux global qui masque la concentration.

    Puis-je remplacer les valeurs manquantes par la moyenne ?

    Vous le pouvez, mais c’est déconseillé et facilement critiquable. La méthode écrase la variance et affaiblit les corrélations, biaisant vos tests vers l’absence d’effet. Si le taux est vraiment marginal, l’impact restera faible — mais dans ce cas la suppression listwise fait aussi bien et se défend mieux.

    Pourquoi mon N analysé est-il plus petit que mon N recruté ?

    À cause de la suppression listwise, appliquée par défaut : un participant est exclu de toute l’analyse dès qu’il lui manque une valeur sur une variable du modèle. Vérifiez systématiquement le N indiqué sous chaque tableau SPSS, et signalez-le en résultats. Un mémoire qui annonce 180 participants et analyse 121 personnes sans le dire présente une incohérence que le jury relèvera.

    Qu’est-ce que le test de Little ?

    Le test MCAR de Little évalue l’hypothèse d’un mécanisme complètement aléatoire sur l’ensemble des variables simultanément. Un résultat non significatif est compatible avec MCAR — sans le prouver. Il ne distingue jamais MAR de MNAR, et il figure dans le module Missing Values, absent de certaines licences universitaires. En son absence, la comparaison répondants/non-répondants est un substitut parfaitement acceptable en mémoire.

    Faut-il exclure un participant qui a répondu à moins de la moitié du questionnaire ?

    C’est une pratique courante et défendable, à condition de fixer la règle à l’avance et de la documenter. Beaucoup d’études excluent les questionnaires remplis à moins de 50 %, en le mentionnant dans le diagramme de flux des participants. L’essentiel est que le critère soit annoncé en méthodologie et appliqué uniformément, et non décidé après avoir vu quels résultats en découlent.

  • ANOVA à mesures répétées sous SPSS : Mauchly, sphéricité et corrections (2026)

    ANOVA à mesures répétées sous SPSS : Mauchly, sphéricité et corrections (2026)

    Votre design est le plus courant des mémoires expérimentaux : vous mesurez le même groupe à plusieurs reprises. Avant l’intervention, juste après, trois mois plus tard. Ou sur trois conditions que chaque participant a traversées.

    Vous lancez l’ANOVA à mesures répétées sous SPSS, et le logiciel vous rend un tableau que vous n’attendiez pas : Test de sphéricité de Mauchly, avec un p à 0,003. Puis, juste en dessous, un tableau des effets intra-sujets qui vous propose quatre lignes différentes pour le même effet — et quatre valeurs de p.

    La question devient : laquelle est la vôtre ? C’est exactement ce que cet article résout.

    Pourquoi ce test existe, et ce que « sphéricité » veut dire

    Quand vous comparez des groupes indépendants, l’hypothèse à vérifier est l’égalité des variances entre groupes. Quand vous comparez des mesures répétées sur les mêmes individus, la question change de nature : vos mesures ne sont plus indépendantes, puisqu’un participant qui score haut au temps 1 scorera probablement haut au temps 2.

    La sphéricité est la condition qui remplace l’homogénéité des variances dans ce contexte. Elle exige que les variances des différences entre chaque paire de mesures soient égales.

    Prenez trois temps de mesure. Il existe trois différences possibles : T1−T2, T1−T3 et T2−T3. La sphéricité demande que ces trois différences soient aussi dispersées les unes que les autres. Or c’est souvent faux dans un design longitudinal, et pour une raison très intuitive : deux mesures rapprochées dans le temps se ressemblent beaucoup plus que deux mesures éloignées. La variance de T1−T2 est alors petite, celle de T1−T3 nettement plus grande, et la sphéricité tombe.

    Ce que ça change concrètement : si la sphéricité est violée et que vous lisez quand même la ligne non corrigée, votre test F est trop libéral. Il produit des p-values artificiellement basses, et vous risquez de conclure à un effet qui n’existe pas.

    Trajectoires individuelles sur trois temps de mesure
    Chaque participant est sa propre référence. C’est la force du design — et la raison pour laquelle il a sa condition d’application à lui.

    La procédure sous SPSS, étape par étape

    Premier obstacle : le format des données. En mesures répétées, chaque temps de mesure est une colonne séparée, et chaque participant occupe une seule ligne. C’est le format « large ». Si vos données sont empilées en format long — une ligne par mesure — vous devez les restructurer avant toute chose (Données → Restructurer).

    1. Analyse → Modèle linéaire général → Mesures répétées.
    2. Dans la première boîte, nommez votre facteur intra-sujets (par exemple temps) et indiquez son nombre de niveaux (3). Cliquez Ajouter, puis Définir.
    3. Faites correspondre vos colonnes aux niveaux, dans le bon ordre : la variable du temps 1 sur le niveau 1, et ainsi de suite. C’est l’erreur de manipulation la plus fréquente, et elle produit silencieusement des résultats faux.
    4. Bouton Options (ou Moyennes marginales estimées selon votre version) : déplacez votre facteur dans la zone d’affichage des moyennes, cochez Comparer les effets principaux et choisissez l’ajustement Bonferroni. Cochez aussi Statistiques descriptives et Estimations de la taille d’effet.
    5. Bouton Graphiques : placez le facteur en abscisse pour obtenir le profil des moyennes. C’est la figure que vous mettrez dans le mémoire.

    Avant de lancer, un mot sur l’effectif. Un design à mesures répétées est plus puissant qu’un design à groupes indépendants, parce que chaque participant sert de témoin à lui-même et que la variabilité interindividuelle est neutralisée. Vous avez donc besoin de moins de participants — mais « moins » n’est pas « peu ». La procédure G*Power couvre ce cas précis via la famille Repeated measures, within factors, où la corrélation entre mesures est un paramètre d’entrée décisif.

    Lire le tableau de Mauchly

    SPSS produit un tableau Test de sphéricité de Mauchly qui contient deux informations utiles.

    La colonne Sig. C’est le test lui-même. Ici, contrairement à la logique habituelle, un résultat non significatif est la bonne nouvelle : p > 0,05 signifie que la sphéricité est respectée et que vous pouvez lire la ligne non corrigée.

    Les colonnes epsilon. À droite, SPSS affiche Greenhouse-Geisser et Huynh-Feldt. Ce sont des estimations du paramètre epsilon (ε), qui mesure l’ampleur de l’écart à la sphéricité. Un ε de 1 correspond à une sphéricité parfaite ; plus il descend, plus la violation est sévère. Ces valeurs sont plus informatives que le test lui-même, et voici pourquoi.

    Le test de Mauchly a une faiblesse bien documentée : il dépend fortement de l’effectif. Sur un petit échantillon, il manque de puissance et ne détecte pas une violation réelle ; sur un grand échantillon, il devient significatif pour un écart trivial. Ne lui faites donc pas aveuglément confiance. Beaucoup de méthodologues recommandent aujourd’hui d’appliquer systématiquement une correction dès que le facteur compte plus de deux niveaux, sans même consulter Mauchly. C’est une position défendable et facile à justifier devant un jury : la correction n’est pénalisante que si la sphéricité était respectée, auquel cas ε vaut environ 1 et la correction ne change presque rien.

    Correction appliquée aux degrés de liberté lorsque la sphéricité est violée
    La correction ne touche pas au F. Elle resserre les degrés de liberté, ce qui rend le test plus exigeant.

    Greenhouse-Geisser ou Huynh-Feldt : la règle de décision

    Le tableau Tests des effets intra-sujets vous propose quatre lignes : Sphéricité supposée, Greenhouse-Geisser, Huynh-Feldt et Borne inférieure. Le F est identique sur les quatre. Ce qui change, ce sont les degrés de liberté : chaque correction les multiplie par son epsilon, ce qui les réduit et rend le test plus conservateur.

    La règle de décision généralement enseignée s’appuie sur l’epsilon de Greenhouse-Geisser :

    • Mauchly non significatif (p > 0,05) → lisez Sphéricité supposée.
    • Mauchly significatif et ε < 0,75 → la violation est marquée : retenez Greenhouse-Geisser, la correction la plus prudente.
    • Mauchly significatif et ε > 0,75 → la violation est modérée : Huynh-Feldt est moins conservateur et préserve mieux votre puissance statistique.

    La ligne Borne inférieure correspond au scénario le plus défavorable possible ; elle est trop pénalisante pour un usage courant et ne se rapporte pas dans un mémoire.

    Comme pour tout seuil conventionnel, annoncez la règle que vous appliquez dans votre section méthodologie, avant d’avoir vu vos résultats. Choisir la correction après coup en fonction de celle qui rend l’effet significatif est une pratique qui se voit immédiatement.

    Si l’effet est significatif : les comparaisons par paires

    L’ANOVA vous dit qu’au moins deux temps de mesure diffèrent, pas lesquels. C’est le tableau des Comparaisons par paires, produit par l’option Bonferroni cochée plus haut, qui répond. L’ajustement de Bonferroni est indispensable : avec trois temps, vous faites trois comparaisons, et sans correction votre risque d’erreur de première espèce grimpe bien au-delà de 5 %.

    Rapportez aussi l’eta carré partiel (η²p), que l’option de taille d’effet a fait apparaître. Les repères conventionnels pour cet indice sont 0,01 (petit), 0,06 (moyen) et 0,14 (grand).

    Et si la normalité pose aussi problème ?

    La sphéricité n’est pas la seule condition. L’ANOVA à mesures répétées suppose également une distribution normale des variables à chaque niveau du facteur — même si, comme pour toute ANOVA, elle est raisonnablement robuste à des écarts modérés dès que l’effectif dépasse la trentaine. Notre article sur le test de Shapiro-Wilk et l’interprétation de la normalité détaille ce diagnostic.

    Si la non-normalité est franche, ou si votre variable est ordinale, ou si votre effectif est vraiment petit, le repli existe et il est propre : le test de Friedman, équivalent non paramétrique de l’ANOVA à mesures répétées. Vous perdez un peu de puissance et vous ne pouvez plus tester d’interaction, mais le test ne suppose plus ni normalité ni sphéricité. Pour deux mesures seulement, l’équivalent est le test de Wilcoxon pour échantillons appariés.

    Rédiger le résultat dans le mémoire

    Sphéricité respectée : « Le test de sphéricité de Mauchly n’est pas significatif, χ²(2) = 2,41, p = 0,300 ; l’hypothèse de sphéricité est donc retenue. L’ANOVA à mesures répétées révèle un effet significatif du temps sur le score d’anxiété, F(2, 88) = 14,62, p < 0,001, η²p = 0,25. »

    Sphéricité violée, correction appliquée : « Le test de Mauchly indique une violation de l’hypothèse de sphéricité, χ²(2) = 11,84, p = 0,003 ; l’epsilon de Greenhouse-Geisser étant de 0,81, la correction de Huynh-Feldt a été appliquée conformément à la règle annoncée. L’effet du temps demeure significatif, F(1,74 ; 76,56) = 9,31, p < 0,001, η²p = 0,17. »

    Comparaisons par paires : « Les comparaisons par paires ajustées selon Bonferroni montrent une baisse significative entre T1 et T2 (différence moyenne = 4,12 ; p < 0,001) et entre T1 et T3 (différence moyenne = 5,08 ; p < 0,001), tandis que l’écart entre T2 et T3 n’atteint pas le seuil (p = 0,214). L’effet apparaît donc immédiatement après l’intervention et se maintient à trois mois sans progression supplémentaire. »

    Remarquez les degrés de liberté décimaux dans le deuxième exemple : F(1,74 ; 76,56). Ce ne sont pas des coquilles. Ce sont les degrés de liberté d’origine (2 et 88) multipliés par epsilon, et leur présence est précisément ce qui prouve à votre lecteur que la correction a bien été appliquée.

    Les erreurs qui coûtent cher

    • Lire la ligne « Sphéricité supposée » sans regarder Mauchly. L’erreur la plus fréquente, et elle gonfle votre taux de faux positifs.
    • Assigner les colonnes dans le désordre lors de la définition des niveaux. SPSS ne proteste pas ; les résultats sont simplement faux.
    • Traiter un design à mesures répétées comme des groupes indépendants. Comparer T1 et T2 avec un test t pour échantillons indépendants jette l’appariement à la poubelle et ruine la puissance du design. Sur le choix du plan lui-même, voyez notre guide du design expérimental.
    • Oublier l’ajustement des comparaisons multiples. Trois tests t successifs sans correction, ce n’est plus un test à 5 %.
    • Ignorer l’attrition. SPSS exclut par défaut tout participant ayant une donnée manquante à un seul temps de mesure. Un participant absent au suivi disparaît entièrement de l’analyse — vérifiez votre N effectif dans le tableau des descriptives, il est souvent plus bas que vous ne le croyez.

    Transformer ces sorties en chapitre résultats

    L’analyse prend dix minutes. Ce qui prend des jours, c’est d’en faire un texte : annoncer la règle de décision en méthodologie, la respecter en résultats, articuler l’effet principal avec les comparaisons par paires, et discuter ce que le maintien à trois mois signifie pour votre question de recherche.

    Tesify travaille avec vous sur cette partie-là : organiser le chapitre, tenir une terminologie constante d’un bout à l’autre du mémoire, et rédiger les passages de justification à partir de vos propres choix d’analyse. Vos données restent les vôtres, et le texte est écrit à 100 % par vous.

    Rédiger votre chapitre résultats avec Tesify

    Questions fréquentes

    Mon test de Mauchly est significatif : mon analyse est-elle invalide ?

    Non, pas du tout. Une sphéricité violée ne remet pas en cause votre design ni votre analyse : elle vous impose seulement de lire une ligne corrigée plutôt que la ligne Sphéricité supposée. SPSS a déjà calculé ces corrections dans le même tableau. C’est une bifurcation de lecture, pas un échec.

    Greenhouse-Geisser ou Huynh-Feldt : lequel choisir ?

    La règle usuelle s’appuie sur l’epsilon de Greenhouse-Geisser : en dessous de 0,75, retenez Greenhouse-Geisser, plus conservateur ; au-dessus, Huynh-Feldt préserve mieux votre puissance. Si vous préférez une position simple et défendable, appliquez systématiquement Greenhouse-Geisser dès que le facteur a plus de deux niveaux : vous ne serez jamais critiqué pour excès de prudence.

    Pourquoi SPSS n’affiche-t-il aucun test de Mauchly ?

    Parce que votre facteur intra-sujets n’a que deux niveaux. Avec deux mesures, il n’existe qu’une seule différence possible, donc une seule variance de différence, et la sphéricité est vérifiée par construction. Aucune correction n’a de sens, et SPSS le signale d’ailleurs par une note sous le tableau.

    Puis-je écrire des degrés de liberté décimaux ?

    Oui, et c’est même le signe d’un résultat correctement corrigé. La correction multiplie les degrés de liberté par epsilon, ce qui donne des valeurs non entières comme F(1,62 ; 71,28). Rapportez-les telles quelles, arrondies à deux décimales, avec la virgule décimale française et un point-virgule pour séparer les deux degrés de liberté.

    Quelle différence avec une ANOVA factorielle classique ?

    La différence tient à l’indépendance des observations. L’ANOVA factorielle compare des groupes distincts de participants ; l’ANOVA à mesures répétées compare des mesures prises sur les mêmes participants. Les deux se combinent d’ailleurs très bien dans un plan mixte — un facteur inter-sujets (groupe témoin contre groupe expérimental) croisé avec un facteur intra-sujets (avant contre après) —, qui est le plan d’évaluation d’intervention le plus courant en mémoire.

  • Quelle taille d’effet rapporter selon votre test statistique ? (2026)

    Quelle taille d’effet rapporter selon votre test statistique ? (2026)

    « Il faudra ajouter la taille d’effet. » C’est l’une des remarques les plus fréquentes en pré-soutenance, et l’une des plus déroutantes — parce que SPSS n’affiche pas d’indice de taille d’effet pour la moitié des tests, et parce que chaque test a le sien.

    Cet article est un tableau d’orientation : pour chaque test que vous êtes susceptible d’avoir utilisé, quel indice rapporter, où le trouver, comment le calculer quand le logiciel ne le donne pas, et comment l’interpréter.

    Pourquoi la p-value ne suffit pas

    La p-value répond à une seule question : l’effet observé est-il compatible avec le hasard ? Elle ne dit rien de son ampleur. Et elle a une propriété qui la disqualifie comme mesure d’importance : elle dépend directement de la taille de votre échantillon.

    Un écart minuscule et sans intérêt pratique devient significatif si vous interrogez 5 000 personnes. Le même écart, sur 40 personnes, ne le sera pas. La p-value mélange donc deux informations — l’ampleur de l’effet et la taille de l’échantillon — sans permettre de les séparer.

    La taille d’effet isole la première. C’est une mesure standardisée de l’ampleur, indépendante de l’effectif. Elle répond à la question que votre lecteur se pose vraiment : non pas « y a-t-il un effet ? » mais « à quel point ? ». Sur la lecture du seuil de significativité lui-même, voyez notre article sur le seuil de significativité et la p-value dans un mémoire.

    C’est aussi ce qui rend votre travail cumulable : une taille d’effet peut être comparée à celles de la littérature de votre domaine, et c’est la matière première de toute méta-analyse.

    Deux distributions peu recouvrantes et deux distributions très recouvrantes
    La taille d’effet, intuitivement : à quel point les deux groupes se recouvrent-ils ? Le d de Cohen est une mesure directe de cet écart.

    Le tableau d’orientation

    Deux grandes familles. Les indices de différence standardisée (le d de Cohen et ses variantes) expriment un écart en nombre d’écarts-types. Les indices de variance expliquée (η², R²) expriment une proportion de la variation totale. Un même résultat peut souvent se dire dans les deux langues ; choisissez celle qui a cours dans votre discipline.

    Votre test Indice à rapporter Dans SPSS ?
    Test t (deux groupes indépendants) d de Cohen Oui, versions récentes
    Test t apparié d de Cohen (pour échantillons appariés) Oui, versions récentes
    Mann-Whitney r = Z / √N Non — à calculer
    Wilcoxon apparié r = Z / √N Non — à calculer
    ANOVA (tous plans) η² partiel (eta carré partiel) Oui, via Options
    Kruskal-Wallis epsilon carré ou eta carré des rangs Non — à calculer
    Khi-deux d’indépendance V de Cramér (ou phi en tableau 2×2) Oui, via Statistiques
    Corrélation r lui-même est la taille d’effet Oui, c’est le résultat
    Régression linéaire R² ajusté, et β par prédicteur Oui
    Régression logistique Odds ratio (Exp(B)) Oui

    Les seuils d’interprétation, et leur mode d’emploi

    Les repères conventionnels, tous issus des travaux de Cohen :

    Indice Petit Moyen Grand
    d de Cohen 0,20 0,50 0,80
    r (corrélation ou non paramétrique) 0,10 0,30 0,50
    η² partiel 0,01 0,06 0,14
    V de Cramér (ddl = 1) 0,10 0,30 0,50

    Un avertissement qui vaut mieux qu’un tableau. Cohen lui-même présentait ces valeurs comme des repères pour un chercheur dépourvu de tout point de comparaison, et non comme des catégories absolues. Leur usage mécanique est aujourd’hui largement critiqué, pour une raison simple : ce qui compte comme un « grand » effet dépend entièrement du domaine. En psychologie sociale, un d de 0,4 est substantiel ; en pharmacologie, il serait décevant. Un effet de 0,15 sur la réussite scolaire d’une cohorte entière peut avoir plus de portée qu’un effet de 0,8 en laboratoire.

    La bonne pratique en mémoire : citez le repère conventionnel, puis situez votre résultat par rapport à ce que rapporte la littérature de votre domaine. C’est cette deuxième phrase qui vaut des points.

    Notez aussi que le V de Cramér a des seuils qui varient avec le nombre de degrés de liberté du tableau : ceux du tableau ci-dessus valent pour ddl = 1. Pour ddl = 2, les repères descendent à environ 0,07 / 0,21 / 0,35.

    Tableau d'orientation associant chaque test statistique à sa mesure de taille d'effet
    Un test, un indice. La règle est mécanique une fois qu’on la connaît.

    Quand SPSS ne calcule rien : les formules de secours

    Après un Mann-Whitney ou un Wilcoxon

    C’est le cas le plus fréquent, et la remarque de jury la plus fréquente aussi. SPSS ne fournit aucune taille d’effet pour les tests non paramétriques, mais la formule est immédiate :

    r = Z / √N

    Le Z se trouve dans le tableau des statistiques du test (colonne Z). Le N est l’effectif total des deux groupes réunis — pas la taille d’un groupe, c’est l’erreur classique. Pour un Wilcoxon apparié, N est le nombre total d’observations, soit deux fois le nombre de paires.

    Exemple : Z = −2,84 avec 60 participants au total donne r = 2,84 / √60 = 2,84 / 7,75 = 0,37, soit un effet moyen. Le signe de Z ne se reporte pas ; on utilise la valeur absolue.

    À partir d’un test t

    Si votre version de SPSS n’affiche pas le d : d = 2t / √ddl pour deux groupes indépendants d’effectifs proches. Vous pouvez aussi le calculer directement comme la différence des moyennes divisée par l’écart-type combiné, que les statistiques descriptives vous donnent.

    Après un khi-deux

    Le V de Cramér s’obtient sans formule : dans Analyse → Statistiques descriptives → Tableaux croisés, bouton Statistiques, cochez Phi et V de Cramér. Il apparaît dans un tableau Mesures symétriques.

    Après un Kruskal-Wallis

    ε² = H / ((N² − 1) / (N + 1)), où H est la statistique du test et N l’effectif total. Une approximation très répandue et acceptable en mémoire consiste à rapporter η² = (H − k + 1) / (N − k), k étant le nombre de groupes.

    Où l’écrire, et comment

    La taille d’effet se rapporte immédiatement après le test, dans la même parenthèse, jamais dans une section séparée.

    • Test t : « Les étudiants du groupe accompagné obtiennent des scores supérieurs à ceux du groupe témoin, t(78) = 3,42, p < 0,001, d = 0,77 — un effet de taille proche du seuil conventionnel du grand effet. »
    • Mann-Whitney : « La différence est significative, U = 312,5, Z = −2,84, p = 0,004, r = 0,37, ce qui correspond à un effet de taille moyenne. »
    • ANOVA : « L’effet du temps est significatif, F(2, 88) = 14,62, p < 0,001, η²p = 0,25 : le facteur temps rend compte de 25 % de la variance intra-sujets. »
    • Khi-deux : « L’association entre la filière et le recours au tutorat est significative, χ²(3) = 18,74, p < 0,001, V de Cramér = 0,24, soit une association faible à modérée. »
    • Corrélation : « Les deux variables sont modérément corrélées, r(118) = 0,34, p < 0,001 ; le coefficient de détermination indique une variance partagée de 12 %. »

    Trois conventions de forme à respecter en français : la virgule décimale (d = 0,77 et non 0.77), l’italique pour les symboles statistiques latins (t, d, r, p, F) mais pas pour les lettres grecques (η, χ), et l’usage de deux décimales sauf pour les p très petits, qu’on écrit p < 0,001.

    L’erreur à ne pas commettre

    Elle consiste à traiter la taille d’effet comme une décoration : la calculer, la coller entre parenthèses, et ne plus jamais en parler. Or c’est elle qui doit structurer votre discussion.

    Un d de 0,15 significatif sur 800 participants et un d de 0,72 non significatif sur 22 participants sont deux résultats radicalement différents, et aucun des deux ne se résume par « significatif » ou « non significatif ». Le premier est un effet réel mais probablement sans portée pratique. Le second est un effet possiblement important que votre étude n’avait pas la puissance de détecter — un cas où la taille d’effet ne vous sauve pas seulement, elle vous fournit l’argument central de votre section limites, et le paramètre d’entrée d’un calcul de puissance pour une recherche future. Notre article sur le calcul de taille d’échantillon avec G*Power montre comment cette boucle se referme : la taille d’effet attendue est justement ce qu’on entre au départ.

    Et pensez à l’intervalle de confiance : rapporté autour de la taille d’effet, il indique la précision de votre estimation et permet de voir immédiatement si un effet nul reste plausible.

    Rédiger vos résultats sans laisser passer ces oublis

    Le vrai risque, en fin de mémoire, n’est pas de mal calculer un indice : c’est d’en oublier un sur cinq tests, d’écrire un point décimal ici et une virgule là, et de ne pas relier la taille d’effet à la discussion.

    Tesify vous aide à tenir cette cohérence : structurer le chapitre résultats, uniformiser la présentation de chaque test, et articuler ampleur des effets et interprétation d’un chapitre à l’autre. Vos analyses restent les vôtres, et le texte est écrit à 100 % par vous.

    Rédiger votre chapitre résultats avec Tesify

    Questions fréquentes

    La taille d’effet est-elle obligatoire dans un mémoire ?

    Aucun règlement d’université ne l’impose, mais les normes de rédaction scientifique dominantes — l’APA en tête — la considèrent comme attendue, et la quasi-totalité des revues l’exigent. Un jury qui maîtrise la méthode la demandera. Le coût est faible, l’omission se remarque : rapportez-la pour chaque test inférentiel que vous commentez.

    Mon effet est significatif mais la taille d’effet est petite : que dire ?

    Dites-le exactement ainsi : l’effet existe, son ampleur est modeste. C’est la situation typique d’un grand échantillon. Loin d’affaiblir votre mémoire, cette lucidité le renforce — à condition que votre discussion porte alors sur la portée pratique du résultat plutôt que sur sa seule existence statistique.

    Peut-on rapporter une taille d’effet quand le test n’est pas significatif ?

    Oui, et c’est vivement recommandé. Une taille d’effet moyenne assortie d’un test non significatif suggère un manque de puissance plutôt qu’une absence d’effet. C’est une information précieuse pour votre section limites et pour toute recherche ultérieure, et elle transforme un « résultat négatif » en contribution utile.

    Faut-il utiliser eta carré ou eta carré partiel ?

    SPSS affiche l’eta carré partiel : nommez-le explicitement comme tel (η²p), car les deux indices ne coïncident qu’en présence d’un seul facteur. Attention à un piège fréquent dans les plans à plusieurs facteurs : les eta carrés partiels ne s’additionnent pas à 100 %, chacun étant calculé en écartant la variance attribuée aux autres facteurs. Notre guide de l’ANOVA factorielle revient sur cette lecture.

    Le d de Cohen peut-il dépasser 1 ?

    Oui, sans aucun problème. Le d n’est pas borné : il exprime un écart en nombre d’écarts-types, et un d de 1,4 signifie simplement que les moyennes des deux groupes sont distantes de 1,4 écart-type. Les valeurs très élevées doivent néanmoins vous faire vérifier deux choses : la présence de valeurs extrêmes, et le fait que vous n’avez pas comparé deux groupes constitués justement sur la base de la variable mesurée.

    Quelle taille d’effet pour un test t apparié ?

    Le d de Cohen reste l’indice, mais son calcul diffère : il repose sur la moyenne et l’écart-type des différences, pas sur l’écart-type combiné des deux mesures. Précisez toujours dans le mémoire quelle version vous rapportez, car les deux peuvent différer sensiblement selon la corrélation entre vos mesures. Le guide du test t et de Mann-Whitney détaille le cas des groupes indépendants.