Catégorie : Analyse de données

  • L’analyse textuelle avec IRaMuTeQ dans un mémoire : méthode et interprétation (2026)

    L’analyse textuelle avec IRaMuTeQ dans un mémoire : méthode et interprétation (2026)

    L’analyse textuelle avec IRaMuTeQ dans un mémoire : méthode et interprétation (2026)

    L’analyse textuelle IRaMuTeQ désigne l’utilisation du logiciel libre IRaMuTeQ (Interface de R pour les Analyses Multidimensionnelles de Textes et de Questionnaires) pour traiter statistiquement un corpus textuel — entretiens, réponses ouvertes, discours — dans le cadre d’un mémoire en sciences humaines et sociales. Développé par Pierre Ratinaud au LERASS et adossé au langage R, il automatise des analyses lexicométriques longtemps réservées aux spécialistes de la textométrie.

    Beaucoup d’étudiants découvrent IRaMuTeQ après avoir buté sur les limites du codage manuel : des dizaines d’entretiens à coder à la main, un risque de subjectivité difficile à justifier devant un jury, et le sentiment de ne pas voir la structure d’ensemble du corpus. IRaMuTeQ répond à une partie de ces difficultés en produisant des classes lexicales, une carte des proximités entre mots, ou une hiérarchie de co-occurrences — mais il pose aussi ses propres exigences méthodologiques, souvent sous-estimées en première lecture.

    Ce guide détaille comment préparer un corpus pour IRaMuTeQ, comment interpréter ses principales sorties (classification hiérarchique descendante, analyse factorielle des correspondances, nuage de mots, analyse de similitude), et dans quels cas il complète — ou remplace mal — une analyse thématique manuelle.

    Réponse rapide : IRaMuTeQ est un logiciel libre d’analyse textuelle adossé à R. Après un nettoyage du corpus et un codage en variables étoilées, il produit surtout une classification hiérarchique descendante (méthode Reinert) qui regroupe le vocabulaire en classes ou « mondes lexicaux », complétée par une analyse factorielle des correspondances, un nuage de mots et une analyse de similitude. Ces sorties statistiques nécessitent une interprétation qualitative du chercheur pour prendre sens dans un mémoire.

    Qu’est-ce qu’IRaMuTeQ et pourquoi l’utiliser dans un mémoire ?

    IRaMuTeQ est un logiciel libre et gratuit, distribué sous licence GNU GPL, qui s’installe en interface avec R et propose une série d’outils de statistique textuelle : calcul de spécificités lexicales, distances de Labbé, classification hiérarchique descendante de type Reinert, analyse factorielle des correspondances et analyse de similitude. Il a été conçu pour traiter aussi bien des corpus d’entretiens que des réponses ouvertes de questionnaires.

    Dans un mémoire, l’intérêt principal d’IRaMuTeQ tient à sa capacité à traiter des corpus volumineux de façon systématique et reproductible : les résultats obtenus dépendent d’un algorithme documenté plutôt que d’un codage manuel sujet à variation entre relectures. Cela ne dispense pas d’une interprétation qualitative, mais cela permet d’objectiver une première structuration du corpus avant d’y revenir avec une lecture fine.

    Comment préparer son corpus pour IRaMuTeQ ?

    La qualité des résultats dépend directement de la préparation du corpus. Trois étapes structurent ce travail en amont du traitement.

    Corpus de texte imprimé annoté avec surlignage
    Un corpus bien préparé et annoté facilite l’interprétation des classes lexicales produites par IRaMuTeQ.

    Constituer un corpus homogène

    IRaMuTeQ segmente le texte en « segments de texte » (unités de contexte élémentaires, UCE) sur lesquels s’appuie la classification. Un corpus trop hétérogène en style ou en longueur de texte par entretien produit souvent des classes déséquilibrées, dominées par les textes les plus longs.

    Coder les variables étoilées

    Les variables étoilées sont des métadonnées associées à chaque texte, insérées en tête de chaque document sous la forme d’un astérisque suivi d’un descripteur, par exemple *genre_f ou *groupe_experimental. Elles ne modifient pas le contenu lexical mais permettront ensuite de croiser les classes obtenues avec ces caractéristiques — un point souvent décisif pour répondre à une question de recherche portant sur des différences entre sous-groupes.

    Nettoyer le texte

    Le nettoyage consiste à uniformiser la ponctuation, supprimer les artefacts de transcription (hésitations non pertinentes, codes de retranscription), et vérifier l’encodage du fichier (UTF-8 recommandé) pour éviter les problèmes d’accents. Un corpus mal nettoyé génère des formes lexicales dupliquées ou tronquées qui faussent le décompte des occurrences.

    Quelles analyses IRaMuTeQ propose-t-il ?

    Le tableau suivant résume les principales analyses disponibles dans IRaMuTeQ et leur usage typique dans un mémoire.

    Analyse Ce qu’elle produit Usage dans le mémoire
    Statistiques textuelles Nombre d’occurrences, de formes, d’hapax, richesse du vocabulaire Décrire le corpus dans la partie méthodologie
    Classification hiérarchique descendante (méthode Reinert) Classes de segments de texte partageant un vocabulaire proche Identifier des « mondes lexicaux » ou thématiques latentes
    Analyse factorielle des correspondances (AFC) Projection graphique des classes et des variables étoilées Visualiser les proximités et oppositions entre classes
    Nuage de mots Représentation visuelle des formes les plus fréquentes Illustration synthétique, à utiliser avec prudence en preuve
    Analyse de similitude Graphe des co-occurrences entre formes lexicales Repérer les mots pivots et leurs associations structurantes

    Comment interpréter une classification hiérarchique descendante (méthode Reinert) ?

    La classification hiérarchique descendante reproduit la méthode décrite par Max Reinert dans les années 1980-1990, à l’origine du logiciel Alceste dont IRaMuTeQ s’inspire pour cette fonctionnalité. L’algorithme croise les segments de texte et les formes pleines (noms, verbes, adjectifs, adverbes) pour partitionner le corpus en classes statistiquement distinctes.

    Dendrogramme de classification hiérarchique affiché sur un écran
    Le dendrogramme issu de la classification hiérarchique descendante visualise la structure des classes lexicales du corpus.

    Interpréter une classe suppose de croiser trois éléments : les formes les plus caractéristiques de la classe (classées par leur khi², qui mesure leur association statistique à la classe), les segments de texte représentatifs (extraits verbatim que le logiciel associe à chaque classe), et la proportion de segments classés par rapport au total du corpus — un taux de classification faible (par exemple bien en dessous de la majorité des segments) doit alerter sur la robustesse de la partition.

    Le chercheur donne ensuite un nom à chaque classe — souvent appelée « monde lexical » — en s’appuyant sur les formes caractéristiques et les extraits verbatim, puis discute ce que cette classe révèle au regard de la question de recherche. Cette étape de nommage reste une interprétation qualitative : deux chercheurs peuvent nommer différemment une même classe, ce qui justifie de toujours documenter le raisonnement dans le mémoire.

    Comment lire une analyse factorielle des correspondances (AFC) ?

    L’AFC projette les classes lexicales et, le cas échéant, les variables étoilées sur un plan factoriel à deux (ou plusieurs) axes. La proximité entre deux points sur ce plan traduit une association lexicale ou statistique ; l’éloignement traduit une opposition.

    Dans un mémoire, l’AFC sert surtout à visualiser si une variable étoilée (par exemple le genre, le groupe d’appartenance, ou la période de collecte) se rapproche davantage d’une classe que d’une autre. Il convient toutefois d’éviter de sur-interpréter la position exacte des points : l’AFC est une représentation approximative de relations complexes, et le pourcentage de variance expliquée par chaque axe (affiché par IRaMuTeQ) donne une indication de la fiabilité de la lecture graphique — un axe expliquant une faible part de la variance totale invite à la prudence dans son interprétation.

    Que révèlent le nuage de mots et l’analyse de similitude ?

    Le nuage de mots hiérarchise visuellement les formes lexicales les plus fréquentes du corpus, la taille de police étant proportionnelle à la fréquence. Il constitue un support d’illustration utile en introduction d’un chapitre de résultats, mais il ne doit pas servir de preuve méthodologique à lui seul : la fréquence brute ne renseigne ni sur le contexte d’emploi d’un mot ni sur sa polarité (positive, négative, ironique).

    L’analyse de similitude va plus loin en construisant un graphe de co-occurrences entre formes lexicales, révélant des mots pivots (hubs) autour desquels s’organisent des réseaux de sens. Elle est particulièrement utile pour identifier la structure relationnelle du vocabulaire d’un corpus, complémentaire de la classification qui, elle, partitionne le corpus en groupes disjoints.

    Quelles sont les limites d’IRaMuTeQ ?

    IRaMuTeQ présente plusieurs limites qu’il convient de discuter explicitement dans la partie méthodologie d’un mémoire.

    • Sensibilité au prétraitement — la lemmatisation, la gestion des mots vides et le nettoyage du corpus influencent fortement les classes obtenues ; deux prétraitements différents peuvent produire des résultats sensiblement différents.
    • Absence de compréhension sémantique fine — l’algorithme travaille sur des co-occurrences statistiques de formes, sans saisir l’ironie, la négation contextuelle ou les figures de style.
    • Interprétation toujours nécessaire — les classes et graphes produits sont des supports, non des conclusions ; le nommage des classes reste un acte interprétatif du chercheur.
    • Corpus de petite taille — sur un corpus réduit ou très hétérogène, la classification hiérarchique descendante peut produire des classes instables ou peu interprétables.
    • Courbe d’apprentissage — la prise en main de R sous-jacent et des paramètres de l’interface demande un temps d’appropriation que beaucoup de mémoires sous-estiment dans leur calendrier.

    IRaMuTeQ ou analyse thématique manuelle : quelle méthode choisir ?

    La analyse thématique manuelle repose sur un codage interprétatif progressif du chercheur, qui construit ses catégories au fil de la lecture du corpus. Elle capte plus finement le contexte, l’implicite et les nuances de sens, mais elle est plus chronophage sur un corpus volumineux et dépend davantage de la subjectivité — et donc de la fiabilité inter-codeurs — du chercheur.

    IRaMuTeQ, à l’inverse, automatise une première structuration statistique du corpus, reproductible et rapide à obtenir même sur plusieurs dizaines d’entretiens. Le choix entre les deux approches — ou leur combinaison — dépend du cadre épistémologique du mémoire : une approche à dominante quantitative ou mixte tirera davantage parti d’IRaMuTeQ en première lecture, tandis qu’une approche compréhensive ou interprétative privilégiera un codage manuel, quitte à utiliser IRaMuTeQ en complément exploratoire. Le guide sur comment analyser des données qualitatives pour un mémoire détaille ce choix méthodologique plus largement, et l’article sur l’analyse de discours pour un mémoire en SHS mobilise également IRaMuTeQ comme un des outils possibles au sein d’un cadre théorique plus large. Pour la rédaction de la section méthode, voir aussi la méthodologie de recherche et les normes de citation applicables aux outils logiciels cités dans un mémoire.

    Foire aux questions

    Qu’est-ce qu’IRaMuTeQ exactement ?

    IRaMuTeQ (Interface de R pour les Analyses Multidimensionnelles de Textes et de Questionnaires) est un logiciel libre développé par Pierre Ratinaud (LERASS, Toulouse), adossé au langage R. Il permet des analyses de statistique textuelle : lexicométrie, classification hiérarchique descendante selon la méthode Reinert, analyse factorielle des correspondances, nuage de mots et analyse de similitude.

    IRaMuTeQ est-il gratuit ?

    Oui, IRaMuTeQ est un logiciel libre et gratuit, distribué sous licence GNU GPL. Il nécessite l’installation préalable de R, sur lequel il s’appuie pour les calculs statistiques.

    Combien de textes faut-il pour une analyse IRaMuTeQ fiable ?

    Il n’existe pas de seuil universel validé par la littérature méthodologique. La qualité de la classification dépend davantage de l’homogénéité du corpus et du nombre de segments de texte analysables que du nombre brut de documents ; un corpus trop réduit ou trop hétérogène produit souvent des classes peu stables ou peu interprétables.

    Quelle est la différence entre la classification Reinert et une analyse thématique manuelle ?

    La classification hiérarchique descendante (méthode Reinert) repose sur des co-occurrences statistiques de formes lexicales et produit des classes de manière automatisée et reproductible. L’analyse thématique manuelle repose sur un codage interprétatif du chercheur, plus sensible au contexte et à l’implicite, mais moins reproductible d’un codeur à l’autre.

    Peut-on utiliser IRaMuTeQ seul, sans autre méthode d’analyse ?

    Cela dépend du cadre méthodologique du mémoire. De nombreux travaux combinent IRaMuTeQ avec une lecture qualitative approfondie des classes lexicales obtenues, afin de contextualiser des résultats statistiques qui, seuls, ne rendent pas compte des nuances de sens ou de l’ironie, par exemple.

    Que sont les variables étoilées dans IRaMuTeQ ?

    Les variables étoilées sont des métadonnées associées à chaque texte du corpus (ex. genre, âge, groupe, date), codées avec un astérisque en début de ligne (ex. *genre_f). Elles permettent ensuite de croiser les classes lexicales obtenues avec ces caractéristiques, par exemple pour observer si un groupe de locuteurs mobilise davantage une classe que d’autres.

    En résumé

    L’analyse textuelle avec IRaMuTeQ apporte une structuration statistique reproductible d’un corpus, particulièrement utile pour un mémoire mobilisant un grand nombre d’entretiens ou de réponses ouvertes. Elle exige toutefois une préparation rigoureuse du corpus, une lecture critique des sorties statistiques — classification hiérarchique descendante, AFC, nuage de mots, analyse de similitude — et une articulation explicite avec une interprétation qualitative, faute de quoi les classes lexicales obtenues resteraient des artefacts statistiques sans portée analytique pour la question de recherche.
  • Modèles d’équations structurelles (SEM/PLS) pour le mémoire de master : guide pratique 2026

    Modèles d’équations structurelles (SEM/PLS) pour le mémoire de master : guide pratique 2026

    Modèles d’équations structurelles (SEM/PLS) pour le mémoire de master : guide pratique 2026

    Votre mémoire de master porte sur la satisfaction au travail, l’intention d’achat, la motivation des apprenants ou la confiance organisationnelle — des concepts qu’on ne mesure pas directement. Dès qu’un questionnaire mobilise plusieurs construits latents reliés entre eux, les régressions multiples classiques montrent leurs limites : elles ignorent l’erreur de mesure et imposent des relations univariées incapables de capturer la complexité réelle des phénomènes. C’est là qu’interviennent les modèles d’équations structurelles (MES, ou SEM en anglais — Structural Equation Modeling). La famille SEM/PLS est aujourd’hui la méthode reine en gestion, psychologie, sciences de l’éducation et santé publique pour les données d’enquête à construits latents.

    Pour un étudiant en master, maîtriser les MES représente un avantage compétitif fort à la soutenance : votre directeur de recherche verra que vous distinguez modèle de mesure et modèle structurel, que vous connaissez les indices d’ajustement et leurs seuils, et que vous avez choisi votre logiciel de manière raisonnée. Ce guide vous accompagne pas à pas — de l’analyse factorielle confirmatoire (AFC) jusqu’à la rédaction finale — en couvrant le pipeline CB-SEM (AMOS) vs PLS-SEM (SmartPLS) vs R/lavaan.

    En bref : Un MES combine un modèle de mesure (AFC) et un modèle structurel (relations entre construits). Le choix entre CB-SEM et PLS-SEM dépend de votre objectif (confirmation vs prédiction) et de votre taille d’échantillon. Les indices d’ajustement à surveiller sont RMSEA ( 0,90) et SRMR (< 0,08). Pour les mémoires de master, SmartPLS et R/lavaan sont les outils les plus accessibles.

    Principes fondamentaux des MES

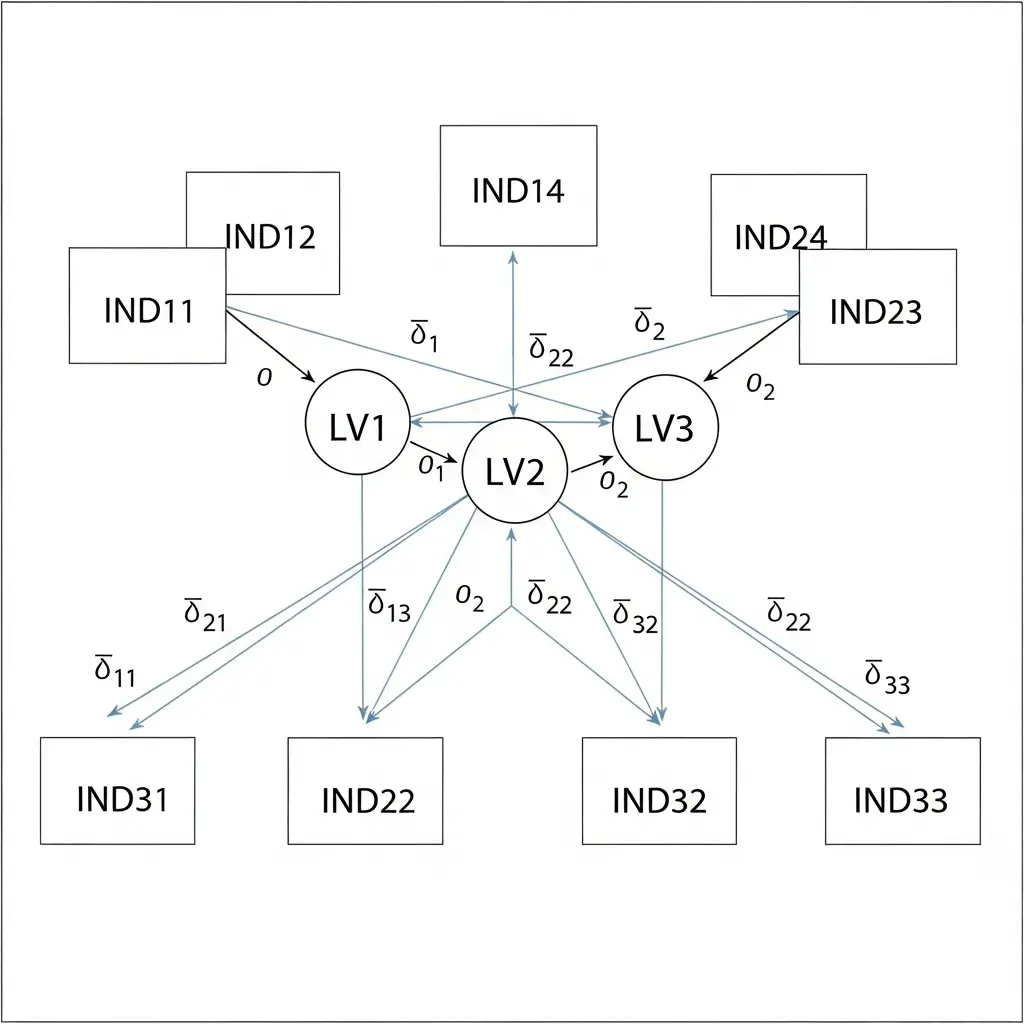
    Un modèle d’équations structurelles est un système mathématique unifié qui permet de tester simultanément deux niveaux d’analyse. Le premier niveau — le modèle de mesure — spécifie comment des variables observables (items d’un questionnaire) reflètent ou forment des construits latents non directement mesurables. Le second niveau — le modèle structurel — représente les relations hypothétiques (causalité, médiation, modération) entre ces construits latents.

    La distinction entre les deux familles de MES est fondamentale :

    • CB-SEM (Covariance-Based SEM) : estime les paramètres en minimisant l’écart entre la matrice de covariance théorique et la matrice observée. Développée par Karl Gustav Jöreskog (LISREL, 1973), cette approche vise à tester et confirmer des théories établies. Elle suppose la multinormalité des données et requiert généralement N ≥ 200.
    • PLS-SEM (Partial Least Squares SEM) : approche composite développée par Herman Wold. Elle maximise la variance expliquée des construits cibles (logique prédictive), accepte des petits échantillons et des données non normales, et est particulièrement adaptée à la recherche exploratoire.

    Dans les deux cas, la démarche reste séquentielle : on valide d’abord le modèle de mesure (étape AFC), puis on interprète le modèle structurel. Cette logique reflète la posture épistémologique hypothético-déductive la plus commune en sciences de gestion et en psychologie.

    Exemple de modèle d'équations structurelles : variables latentes (ovales) reliées à des variables observées (rectangles) avec coefficients standardisés
    Exemple de diagramme SEM après estimation — variables latentes en ovales, indicateurs observés en rectangles. Source : Wikimedia Commons (CC BY-SA 4.0)

    Étape 1 — L’analyse factorielle confirmatoire (AFC)

    Contrairement à l’analyse factorielle exploratoire (AFE), l’AFC ne cherche pas la structure factorielle : elle vérifie que la structure que vous avez théoriquement spécifiée correspond aux données. C’est une étape obligatoire avant tout modèle structurel.

    Spécification du modèle de mesure

    Pour chaque construit latent, assignez a priori les indicateurs qui lui appartiennent. Si votre questionnaire mesure l’engagement organisationnel avec 6 items (EO1 à EO6), l’engagement affectif avec 4 items (EA1 à EA4) et l’intention de départ avec 3 items (ID1 à ID3), vous spécifiez explicitement que EO1–EO6 → Engagement_Org, EA1–EA4 → Engagement_Affectif, et ID1–ID3 → Intention_Départ. Aucun indicateur ne doit saturer librement sur plusieurs facteurs (sauf si votre théorie le justifie).

    Critères de validité à évaluer

    1. Saturations standardisées (λ) ≥ 0,70 : chaque indicateur doit expliquer au moins 49 % de la variance du construit. Une saturation inférieure à 0,50 est généralement éliminatoire.
    2. Variance Moyenne Extraite (AVE) ≥ 0,50 : indique que le construit explique davantage la variance de ses indicateurs que l’erreur de mesure.
    3. Fiabilité composite (ρc) ≥ 0,70 : alternative à l’alpha de Cronbach, plus adaptée aux MES. Consultez notre guide sur l’alpha de Cronbach et la fidélité des instruments pour comparer les deux approches.
    4. Validité discriminante : selon le critère HTMT (Heterotrait-Monotrait Ratio), la valeur doit rester inférieure à 0,85 (critère conservateur) ou 0,90 (critère libéral) entre chaque paire de construits.

    La validité de vos instruments de mesure avant le SEM est directement liée à leur validation psychométrique complète — un prérequis que votre jury vérifiera systématiquement.

    Étape 2 — Indices d’ajustement et seuils 2026

    Une fois le modèle de mesure estimé, les indices d’ajustement quantifient dans quelle mesure votre modèle théorique reproduit la structure de covariance observée dans les données. Le tableau suivant synthétise les seuils de référence issus des travaux de Hu et Bentler (1999) et des recommandations actuelles :

    Tableau 1. Indices d’ajustement des MES — seuils de référence 2026
    Indice Seuil excellent Seuil acceptable Interprétation
    Chi-deux / ddl (χ²/df) < 2 < 5 Très sensible à N, à relativiser
    RMSEA < 0,06 ≤ 0,08 Ajustement absolu, pénalise la complexité
    CFI > 0,95 > 0,90 Incrémental, compare au modèle indépendant
    TLI (NNFI) > 0,95 > 0,90 Incrémental + pénalité de complexité
    SRMR < 0,06 < 0,08 Résidus standardisés, intuitif
    AIC / BIC Valeur la plus basse Comparaison de modèles alternatifs

    Remarque importante sur le χ² : lorsque N > 200, le chi-deux devient quasiment toujours significatif, ce qui n’indique pas nécessairement un mauvais ajustement. Les tutoriels de l’AlloStats de l’UQAM sur les MES avec R et avec JASP recommandent de rapporter le ratio χ²/ddl plutôt que la valeur brute et d’y associer systématiquement RMSEA et CFI.

    Modifier le modèle : règle d’or

    Si les indices sont hors seuil, les logiciels proposent des indices de modification (MI) suggérant de libérer certains paramètres (covariations d’erreurs, cross-loadings). Chaque modification doit impérativement être justifiée théoriquement — jamais uniquement par l’amélioration statistique. Cette règle est unanimement partagée dans la littérature et attendue par vos évaluateurs.

    Étape 3 — Estimation du modèle structurel

    Une fois la qualité du modèle de mesure validée, vous estimez les chemins structurels (β) reliant les construits latents. Chaque chemin correspond à une hypothèse de recherche.

    Éléments à rapporter dans votre mémoire

    • Coefficient de chemin standardisé (β) : comparable à un coefficient de régression standardisé.
    • Valeur p et intervalles de confiance bootstrap : pour CB-SEM, les valeurs p issues du maximum de vraisemblance ; pour PLS-SEM, les IC à 95 % issus d’un bootstrap à 5 000 rééchantillonnages.
    • Coefficient de détermination R² : variance du construit endogène expliquée par les prédicteurs. Hair et al. (2019) proposent R² > 0,25 (modeste), > 0,50 (moyen), > 0,75 (fort).
    • Taille d’effet f² : mesure l’impact de chaque prédicteur spécifique sur R² (0,02 petit, 0,15 moyen, 0,35 grand).
    • Relevance prédicative Q² (PLS-SEM) : indicateur Stone-Geisser via blindfolding ; Q² > 0 signifie pertinence prédicative.

    Pour les mémoires intégrant des analyses de médiation dans leur modèle structurel, le guide sur l’analyse de médiation avec SPSS et la macro PROCESS apporte des repères complémentaires sur la logique des effets indirects.

    CB-SEM vs PLS-SEM : quelle approche pour votre mémoire ?

    Le choix entre CB-SEM et PLS-SEM n’est pas anodin : il découle directement de vos objectifs de recherche, de la nature de vos construits et de vos contraintes pratiques.

    Tableau 2. Comparatif CB-SEM vs PLS-SEM pour le mémoire de master
    Critère CB-SEM PLS-SEM
    Objectif principal Confirmation / test de théorie Prédiction / exploration
    Taille d’échantillon N ≥ 200 recommandé N ≥ 30–100 (complexité-dépendant)
    Distribution des données Multinormalité requise Distribution libre
    Type de construits Reflectifs (common factor) Reflectifs et formatifs
    Indices d’ajustement globaux Oui (RMSEA, CFI, TLI, SRMR) SRMR pour PLS, indices globaux via PLSc
    Logiciels typiques AMOS, LISREL, Mplus, R/lavaan SmartPLS, R (plspm, cSEM)
    Disciplines les plus concernées Psychologie, sociologie, épidémiologie Gestion, marketing, SI, tourisme

    La logique de décision recommandée est la suivante : si votre mémoire vise à tester un modèle théorique établi (TAM, théorie du comportement planifié, modèle de DeLone & McLean) sur un échantillon de taille suffisante, optez pour CB-SEM. Si vous développez un modèle prédictif, travaillez avec un échantillon contraint (N < 200) ou avez des construits formatifs, PLS-SEM s'impose.

    Choix du logiciel : AMOS, SmartPLS, R/lavaan

    IBM AMOS

    AMOS (Analysis of Moment Structures) est l’implémentation CB-SEM la plus répandue en Europe francophone pour les mémoires de master. Son interface graphique de dessin de diagrammes rend la spécification du modèle intuitive. Il est intégré à la suite SPSS — si votre université dispose d’une licence SPSS, AMOS est probablement accessible. Ses limites : coût de la licence individuelle, et il n’offre pas nativement PLS-SEM.

    SmartPLS

    SmartPLS est la référence incontestée pour PLS-SEM, avec une communauté académique très active. La version 4 intègre désormais CB-SEM via PLSc, ce qui en fait un outil polyvalent. Une licence académique à tarif réduit est disponible, et l’interface visuelle facilite la représentation du modèle. C’est l’outil recommandé si votre directeur travaille en sciences de gestion ou en marketing.

    R/lavaan

    Le package lavaan (latent variable analysis) est une implémentation CB-SEM complète, gratuite et open-source pour R. Il offre une flexibilité maximale : modèles multigroups, mesure de l’invariance, bootstrapping avancé. Pour les étudiants qui maîtrisent déjà R — par exemple après avoir réalisé leurs analyses en composantes principales dans cet environnement — lavaan représente l’option la plus puissante et la mieux documentée dans la communauté internationale.

    La syntaxe de base pour une AFC dans lavaan est la suivante :

    library(lavaan)
    
    modele_mesure <- '
      Engagement =~ EO1 + EO2 + EO3 + EO4
      Satisfaction =~ SA1 + SA2 + SA3
      Intention =~ ID1 + ID2 + ID3
    '
    
    ajustement <- cfa(modele_mesure, data = donnees, estimator = "MLR")
    summary(ajustement, fit.measures = TRUE, standardized = TRUE)

    Le paramètre estimator = "MLR" (maximum de vraisemblance robuste) est recommandé lorsque la normalité multivariée n’est pas parfaitement vérifiée — ce qui est fréquent avec des données Likert. Cette option produit des indices d’ajustement corrigés de la non-normalité (correction de Satorra-Bentler).

    Rédiger les résultats SEM pour le directeur et le jury

    La présentation des résultats SEM dans un mémoire suit une structure standardisée que votre jury reconnaîtra immédiatement comme académiquement rigoureuse.

    Structure recommandée pour la section résultats

    1. Présentation du modèle théorique : reproduisez le diagramme de chemin annoté (saturations standardisées sur les flèches de mesure, coefficients β sur les flèches structurelles). Chaque logiciel exporte ce diagramme en haute résolution.
    2. Tableau des indices d’ajustement du modèle de mesure (AFC) : reportez CFI, TLI, RMSEA (avec IC 90 %), SRMR, et commentez chaque valeur au regard des seuils de la littérature.
    3. Tableau de validité convergente et discriminante : saturations standardisées, AVE, fiabilité composite, et matrice HTMT ou critère de Fornell-Larcker.
    4. Tableau des hypothèses structurelles : numéro d’hypothèse, chemin testé, β standardisé, IC bootstrap 95 %, valeur p, décision (confirmée/infirmée).
    5. Discussion des résultats en regard de la théorie : ne commentez pas les chiffres isolément — connectez chaque résultat à la théorie mobilisée et aux études antérieures.

    Une bonne démarche quantitative pour le mémoire intègre ces éléments dès la rédaction du chapitre de méthodologie, ce qui facilite ensuite la présentation des résultats sans répétition.

    Conseil de jury : Un jury en master vérife systématiquement la cohérence entre vos hypothèses théoriques numérotées et le tableau récapitulatif des tests structurels. Utilisez la même numérotation (H1, H2…) du cadre conceptuel jusqu’aux tableaux de résultats. Les incohérences dans la numérotation sont parmi les erreurs les plus pénalisantes à la soutenance.

    Erreurs fréquentes à éviter

    • Sauter l’AFC et aller directement au modèle structurel : sans validation du modèle de mesure, les chemins structurels sont biaisés. Vos saturations peuvent absorber une variance qui devrait aller dans les résidus.
    • Modifier le modèle de façon purement empirique : libérer des covariations d’erreur uniquement parce que le MI est élevé, sans justification théorique, est assimilé à du « model fishing » par les jurys expérimentés.
    • Ignorer la multinormalité en CB-SEM : utilisez un estimateur robuste (MLR dans lavaan, option « Bollen-Stine » dans AMOS) si votre test de Mardia révèle une non-normalité multivariée.
    • Confondre R² et qualité du modèle : un R² faible (6 % dans certains modèles exploratoires) n’invalide pas le modèle — il signifie simplement que les prédicteurs testés n’expliquent qu’une partie de la variance.
    • Utiliser PLS-SEM avec des construits purement reflectifs pour confirmer une théorie établie : dans ce cas, CB-SEM ou PLSc sont méthodologiquement plus défendables devant un jury en psychologie ou en sociologie.
    • Présenter les résultats sans rapporter les seuils de la littérature : chaque indice doit être accompagné de sa référence bibliographique (Hu & Bentler, 1999 ; Hair et al., 2019) pour que le lecteur puisse évaluer si votre ajustement est satisfaisant.

    Pour compléter votre arsenal méthodologique, Tesify peut vous aider à structurer votre chapitre de résultats et à vérifier la cohérence entre vos hypothèses et vos analyses. Commencez votre mémoire avec Tesify.

    FAQ — Modèles d’équations structurelles en mémoire

    Quelle est la différence entre CB-SEM et PLS-SEM ?

    CB-SEM (Covariance-Based SEM) repose sur l’estimation par maximum de vraisemblance et vise à tester et confirmer une théorie ; il requiert un échantillon large (N ≥ 200) et des données multinormales. PLS-SEM (Partial Least Squares SEM) est orienté prédiction, accepte des échantillons plus petits et des distributions non normales, et est particulièrement adapté aux recherches exploratoires ou aux modèles incluant des construits formatifs.

    Quels sont les seuils acceptables pour RMSEA, CFI, TLI et SRMR ?

    Les seuils couramment admis sont : RMSEA < 0,06 (excellent) et ≤ 0,08 (acceptable) ; CFI et TLI > 0,95 (excellent) et > 0,90 (acceptable) ; SRMR < 0,08. Ces valeurs sont issues des recommandations de Hu et Bentler (1999) et des tutoriels AlloStats de l’UQAM sur les MES avec R et avec JASP.

    Quel logiciel choisir entre AMOS, SmartPLS et R/lavaan pour un mémoire de master ?

    AMOS (IBM) est adapté au CB-SEM avec interface graphique, mais nécessite une licence payante. SmartPLS est recommandé pour PLS-SEM, offre désormais CB-SEM via PLSc et dispose d’une interface intuitive (licence académique disponible). R/lavaan est gratuit, très puissant pour CB-SEM, idéal si votre université encourage l’open source, avec une courbe d’apprentissage plus marquée.

    Qu’est-ce qu’une AFC et pourquoi est-elle obligatoire avant le modèle structurel ?

    L’AFC (Analyse Factorielle Confirmatoire) vérifie que les indicateurs observés mesurent bien les construits latents prévus par la théorie. Elle évalue la validité convergente (AVE ≥ 0,50 ; saturations ≥ 0,70) et la validité discriminante avant d’estimer les relations entre construits. Passer directement au modèle structurel sans AFC expose votre mémoire à des biais d’estimation non détectés et sera systématiquement relevé par un jury expérimenté.

    Quelle taille d’échantillon est nécessaire pour faire du SEM dans un mémoire de master ?

    Pour CB-SEM, la règle de base est N ≥ 200 ; certains auteurs recommandent un ratio de 10 observations par paramètre estimé. Pour PLS-SEM, un minimum de 30 à 100 observations peut suffire selon la complexité du modèle, ce qui le rend plus accessible pour les mémoires de master avec des contraintes d’accès au terrain.

    Comment présenter les résultats SEM dans le mémoire ?

    Présentez d’abord les résultats de l’AFC avec un tableau récapitulatif des indices d’ajustement, des saturations standardisées et de l’AVE/fiabilité composite. Puis exposez le modèle structurel : chemins standardisés (β), valeurs p, R², intervalles de confiance bootstrap. Commentez chaque indice par rapport aux seuils de la littérature et justifiez les éventuelles modifications du modèle par des arguments théoriques, jamais statistiques seuls.

    Les MES sont-ils adaptés à un mémoire en gestion ou en sciences de l’éducation ?

    Oui. Les modèles d’équations structurelles sont fréquemment utilisés en gestion (satisfaction client, Technology Acceptance Model), en psychologie, en sciences de l’éducation (motivation, engagement) et en santé publique. L’essentiel est de disposer d’un questionnaire avec des construits latents mesurés par des indicateurs reflétant une théorie préétablie.

    Pourquoi le chi-deux est-il peu fiable en SEM pour les grands échantillons ?

    Le chi-deux (χ²) teste l’hypothèse nulle selon laquelle la matrice de covariance théorique est identique à la matrice observée. Avec un échantillon important (N > 200), il devient presque systématiquement significatif même pour un bon modèle, car le test est trop sensible aux petites déviations. C’est pourquoi les chercheurs utilisent le ratio χ²/ddl conjointement avec des indices incrémentaux (CFI, TLI) et d’ajustement absolu (RMSEA, SRMR).

  • Analyse de Données Mémoire : Méthodes et Outils pour Traiter vos Résultats (2026)

    Analyse de Données Mémoire : Méthodes et Outils pour Traiter vos Résultats (2026)

    Analyse de Données Mémoire : Méthodes et Outils pour Traiter vos Résultats (2026)

    L’analyse de données est le cœur de la démarche empirique dans un mémoire de recherche. C’est le moment où vous transformez vos données brutes — qu’il s’agisse de retranscriptions d’entretiens, de questionnaires, d’archives ou de bases de données statistiques — en résultats interprétables qui répondent à votre question de recherche. C’est aussi le chapitre qui différencie un mémoire ordinaire d’un travail de qualité : une analyse rigoureuse, bien présentée et correctement interprétée est la marque d’un chercheur compétent.

    Ce guide couvre les principales méthodes d’analyse de données pour un mémoire de master, les logiciels disponibles, et les règles de présentation des résultats conformes aux exigences académiques françaises.

    En résumé : Pour l’analyse qualitative, utilisez l’analyse thématique (manuelle ou avec NVivo/IRaMuTeQ). Pour l’analyse quantitative, les statistiques descriptives et inférentielles avec SPSS, R ou Excel. Présentez vos résultats dans le corps du texte avec des tableaux et figures, et placez les données brutes en annexe. Interprétez toujours vos résultats en lien avec votre cadre théorique.

    Analyse Qualitative

    L’analyse thématique

    L’analyse thématique est la méthode qualitative la plus utilisée dans les mémoires de master en sciences humaines et sociales. Elle consiste à identifier, coder et interpréter des thèmes récurrents dans votre corpus. La méthode en 6 étapes (Braun & Clarke) :

    1. Se familiariser avec les données (lectures répétées)
    2. Générer les codes initiaux (étiqueter les extraits significatifs)
    3. Rechercher les thèmes (regrouper les codes similaires)
    4. Réviser les thèmes
    5. Définir et nommer les thèmes
    6. Rédiger les résultats

    Approfondissez cette méthode dans notre guide analyse thématique : méthode pas à pas.

    L’analyse de contenu

    L’analyse de contenu est plus quantifiée que l’analyse thématique : elle compte les occurrences de catégories prédéfinies dans un corpus. Elle peut être qualitative (interprétative) ou quantitative (fréquences). Très utilisée en communication, sciences politiques et sociologie des médias.

    L’analyse de discours

    Méthode linguistique et sociologique qui examine les structures argumentatives, les implicites et les positionnements idéologiques dans les discours. Requiert une formation spécifique en linguistique ou en analyse du discours.

    Analyse Quantitative

    Statistiques descriptives

    Pour décrire votre échantillon et vos variables :

    • Variables qualitatives : fréquences, pourcentages, mode
    • Variables quantitatives continues : moyenne, médiane, écart-type, minimum, maximum
    • Représentations graphiques : histogrammes, diagrammes en barres, nuages de points

    Tests d’inférence statistique

    Test Usage
    Test t de Student Comparer deux moyennes
    Chi-2 Association entre deux variables qualitatives
    ANOVA Comparer plus de deux groupes
    Régression linéaire Prédire une variable quantitative
    Régression logistique Prédire une variable binaire
    Corrélation de Pearson / Spearman Relation entre deux variables

    Logiciels d’Analyse

    Pour l’analyse qualitative

    • IRaMuTeQ : logiciel français gratuit, excellent pour l’analyse lexicale et textuelle. Très utilisé dans les thèses françaises en SHS.
    • NVivo : logiciel professionnel de codage qualitatif (payant). Standard dans la recherche qualitative internationale.
    • Atlas.ti : alternative à NVivo, populaire en Europe.
    • Excel : pour des codages simples avec un corpus réduit.

    Pour l’analyse quantitative

    • SPSS : interface graphique intuitive, très répandu dans les universités françaises. Accessible via les licences universitaires.
    • R : gratuit, très puissant, nécessite des compétences en programmation. Standard dans la recherche académique internationale.
    • Python (pandas, scipy) : pour les analyses avancées et la visualisation de données.
    • Excel : suffisant pour des analyses descriptives simples et des visualisations de base.

    Présentation des Résultats

    Tableaux

    Chaque tableau doit avoir : un numéro (Tableau 1, Tableau 2), un titre descriptif au-dessus, une source si les données ne sont pas originales, et une note explicative si nécessaire. Les tableaux sont numérotés séquentiellement dans tout le document.

    Figures (graphiques)

    Chaque figure a un numéro (Figure 1, Figure 2) et un titre au-dessous. N’utilisez pas de couleurs si votre mémoire est imprimé en noir et blanc — préférez des hachures ou des niveaux de gris.

    Citations d’entretiens

    Pour illustrer vos thèmes qualitatifs, citez des extraits d’entretiens en italique ou entre guillemets, avec la référence à l’enquêté (E1, E2, ou un code défini dans votre méthodologie).

    De l’Analyse à l’Interprétation

    L’analyse produit des résultats ; l’interprétation leur donne du sens. Ne confondez pas les deux :

    • Analyse : « 67% des répondants déclarent utiliser des outils IA pour leur mémoire »
    • Interprétation : « Ce taux élevé suggère que l’IA s’est normalisée dans les pratiques académiques étudiantes, en contradiction avec les politiques restrictives de certaines universités »

    L’interprétation doit toujours être mise en perspective avec votre cadre théorique et la littérature existante. C’est le cœur de votre contribution intellectuelle. Pour la rédaction de votre chapitre méthodologie, consultez notre guide méthodologie de recherche : guide complet.

    Ressource : Pour vous aider à rédiger les chapitres d’analyse et d’interprétation de votre mémoire, Tesify propose une assistance IA adaptée aux normes académiques françaises. Également disponible en espagnol sur Tesify.es.

    FAQ — Analyse de Données dans un Mémoire

    Combien d’entretiens faut-il retranscrire intégralement ?

    Dans un mémoire de master, il est recommandé de retranscrire intégralement tous vos entretiens et de les placer en annexe (ou de proposer de les transmettre sur demande du jury). Pour une thèse de doctorat avec un corpus large, des retranscriptions sélectives (passages les plus significatifs) peuvent être acceptées. Votre directeur de mémoire vous guidera sur les attentes de votre UFR.

    SPSS est-il gratuit pour les étudiants français ?

    SPSS est généralement disponible gratuitement pour les étudiants via les licences universitaires. Connectez-vous au portail de votre université ou renseignez-vous auprès du service informatique. Si votre université ne dispose pas de licence SPSS, R (totalement gratuit) est une alternative très complète.

    Peut-on faire un mémoire de master sans analyse statistique ?

    Oui. Un mémoire purement qualitatif (entretiens, analyse documentaire, ethnographie) ne requiert pas d’analyse statistique. La rigueur et la profondeur de l’analyse thématique ou de discours remplacent alors la validité statistique. Le choix de l’approche dépend de votre question de recherche, pas d’une hiérarchie de méthodes.

    Comment structurer le chapitre « Résultats » dans un mémoire ?

    Le chapitre Résultats présente vos données analytiquement sans (trop) les interpréter — l’interprétation figure dans le chapitre Discussion. Organisez-le par thèmes (qualitatif) ou par hypothèses (quantitatif). Chaque section présente un résultat avec ses illustrations (tableaux, figures, citations) et une brève description analytique.

    Rédigez vos chapitres d’analyse avec Tesify

    Tesify est la plateforme IA de création de contenu académique qui vous aide à structurer et rédiger vos chapitres d’analyse avec la rigueur attendue dans les mémoires français. Essayez gratuitement.

    Commencer maintenant →