Catégorie : Méthodologie

Auto-created category: Méthodologie

  • Comment formuler les hypothèses d’un mémoire de psychologie ? Hypothèse générale, hypothèses opérationnelles, VI et VD (2026)

    Comment formuler les hypothèses d’un mémoire de psychologie ? Hypothèse générale, hypothèses opérationnelles, VI et VD (2026)

    Réponse directe : un mémoire de psychologie formule d’abord une hypothèse générale, qui relie deux concepts théoriques, puis une ou plusieurs hypothèses opérationnelles, qui traduisent ces concepts en variables mesurables et prédisent un résultat précis dans un sens précis. La qualité du mémoire se joue dans ce passage : une hypothèse opérationnelle bien construite désigne la variable indépendante, la variable dépendante, la population et la direction attendue de l’effet, si bien que le test statistique en découle sans discussion.

    Cette convention est propre à la psychologie universitaire française. Elle est enseignée dès la licence dans les cours de méthodologie expérimentale, et le jury de master l’attend sous cette forme. Un mémoire qui présente des « hypothèses » vagues, sans distinction entre le niveau théorique et le niveau opérationnel, est lu comme un travail qui n’a pas compris ce qu’il testait. Cet article répond aux questions qui reviennent à chaque rendu, spécialité par spécialité.

    Qu’est-ce qu’une hypothèse générale en psychologie ?

    L’hypothèse générale est une proposition qui relie deux concepts issus de votre cadre théorique, sans préciser comment ils seront mesurés. Elle découle de la problématique et de la revue de littérature, et elle est formulée au niveau des construits : « Le sentiment d’efficacité personnelle influence la persévérance face à une tâche difficile. » Aucune échelle n’est nommée, aucun score n’est prédit : c’est une proposition théorique.

    Elle est unique, ou presque. Un mémoire de master en psychologie a en général une hypothèse générale et deux à quatre hypothèses opérationnelles. Deux hypothèses générales signalent souvent deux mémoires, et le jury le dira. Si votre problématique en appelle deux, hiérarchisez-les : une principale, une secondaire qui explore une condition ou une population particulière.

    Ce qui la distingue de la problématique : la problématique est une question, l’hypothèse générale est la réponse provisoire que vous allez tester. La différence entre les deux, et la façon de passer de l’une à l’autre, est détaillée dans notre article sur l’hypothèse de recherche dans un mémoire de master ; le présent guide traite la couche que ce cadre général n’aborde pas, celle de l’opérationnalisation propre à la psychologie.

    Qu’est-ce qu’une hypothèse opérationnelle, et comment passe-t-on de l’une à l’autre ?
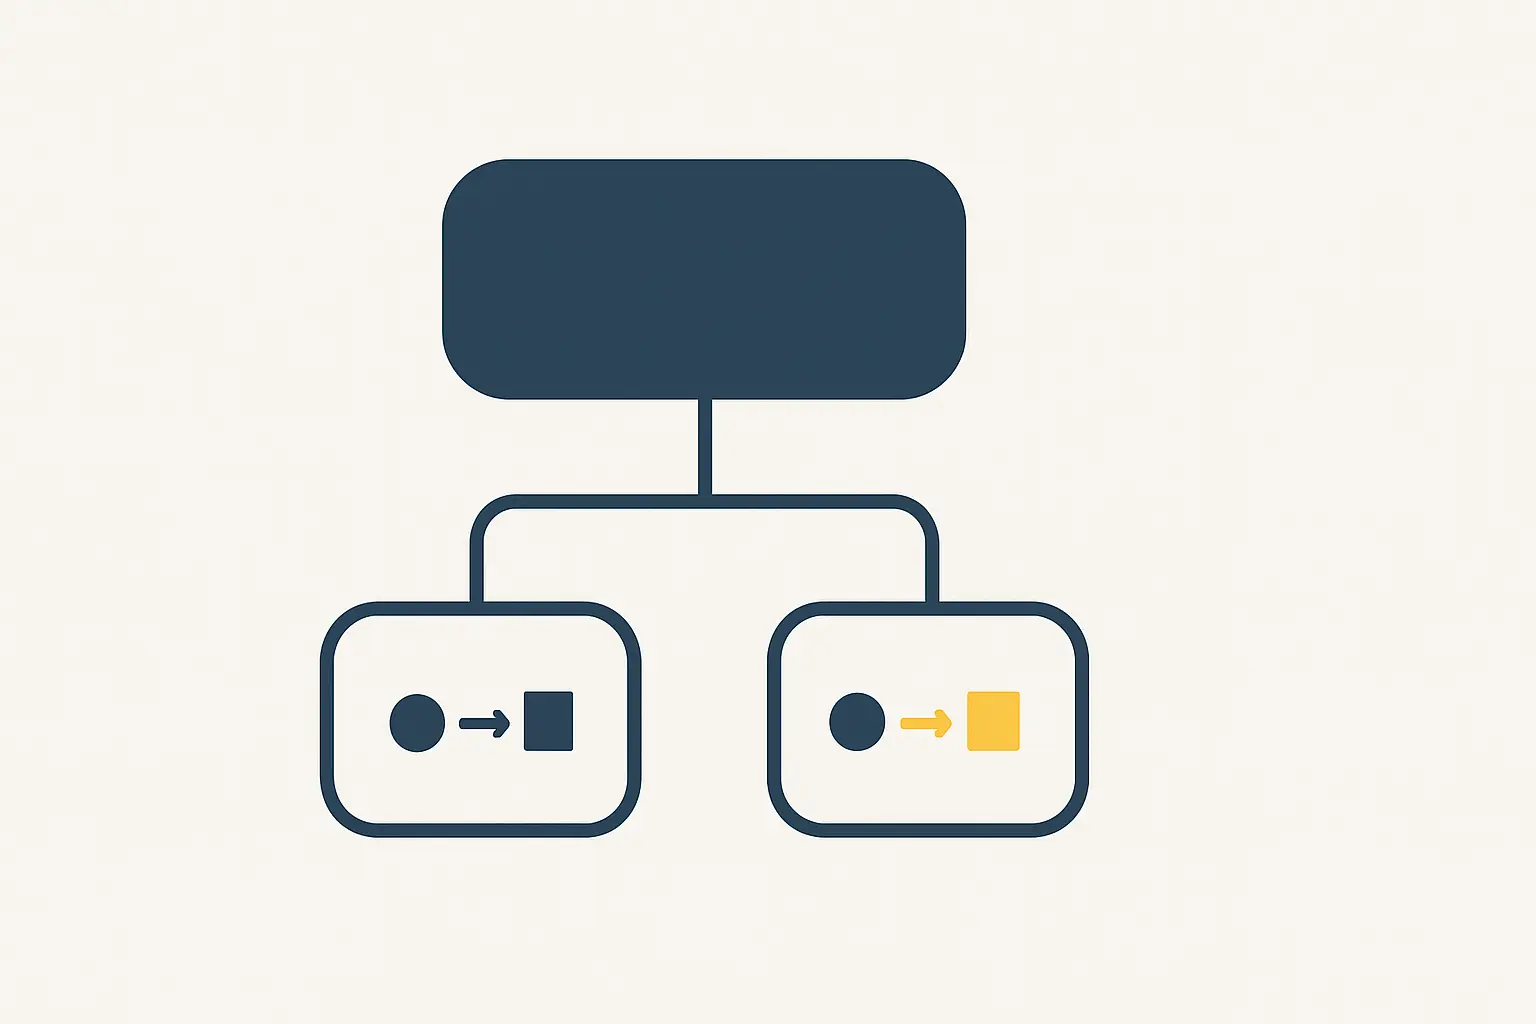
    Schéma d'une hypothèse générale déclinée en deux hypothèses opérationnelles reliant une variable indépendante à une variable dépendante
    De l’hypothèse générale aux hypothèses opérationnelles : un concept, une variable, une prédiction.

    L’hypothèse opérationnelle est la traduction de l’hypothèse générale dans les termes de votre protocole : elle nomme la variable indépendante telle que vous la manipulez ou la mesurez, la variable dépendante telle que vous la relevez, la population, et le sens de l’effet attendu. Elle prédit un résultat observable.

    Le passage s’appelle l’opérationnalisation. Pour chaque concept de l’hypothèse générale, vous répondez à une question : par quoi, concrètement, ce concept sera-t-il représenté dans mes données ? « Sentiment d’efficacité personnelle » devient « score à l’échelle de sentiment d’efficacité générale en dix items » ; « persévérance » devient « nombre de tentatives avant abandon sur une série d’anagrammes insolubles ». L’hypothèse opérationnelle s’écrit alors : « Les participants dont le score d’efficacité personnelle est élevé effectueront davantage de tentatives avant abandon que les participants dont le score est faible. »

    Le choix des instruments qui portent cette opérationnalisation ne s’improvise pas : les échelles disposant d’une validation française, celles qui sont libres et celles qui sont payantes sont recensées dans notre catalogue des échelles validées pour un mémoire de psychologie. Une hypothèse opérationnelle qui repose sur un instrument non validé est une hypothèse que vous ne pourrez pas défendre.

    Niveau Ce qu’elle contient Exemple
    Hypothèse générale Deux concepts théoriques, une relation L’anxiété d’évaluation dégrade la performance en résolution de problèmes.
    Hypothèse opérationnelle 1 VI mesurée, VD mesurée, population, direction Chez des étudiants de L2, le score d’anxiété d’évaluation sera corrélé négativement au nombre de problèmes résolus en douze minutes.
    Hypothèse opérationnelle 2 VI manipulée, VD mesurée, direction Les participants placés en condition « évaluation notée » résoudront moins de problèmes que ceux placés en condition « exercice sans note ».

    Comment identifier la variable indépendante et la variable dépendante ?
    Schéma reliant une variable indépendante manipulée ou mesurée à une variable dépendante
    La variable indépendante est manipulée ou mesurée ; la variable dépendante est toujours mesurée.

    La variable indépendante est ce dont vous supposez qu’il produit un effet ; la variable dépendante est ce sur quoi cet effet est mesuré. En psychologie, la variable indépendante peut être provoquée (vous la manipulez : consigne, condition expérimentale, présence ou absence d’un feedback) ou invoquée (vous la mesurez sans la contrôler : âge, sexe, niveau d’anxiété, groupe clinique). Cette distinction, propre au vocabulaire de la méthodologie expérimentale, doit apparaître dans votre chapitre méthode, parce qu’elle conditionne ce que vous avez le droit de conclure.

    Une variable indépendante provoquée autorise une conclusion causale, à condition que les participants aient été répartis aléatoirement entre les conditions. Une variable invoquée n’autorise qu’une conclusion associative : vous pourrez dire que l’anxiété est liée à la performance, pas qu’elle la cause. La formulation de l’hypothèse opérationnelle doit refléter cette limite dès le départ, avec « sera associé à » plutôt qu’« entraînera ». Les designs qui combinent les deux types de variables, et ce qu’ils permettent de conclure, sont présentés dans notre guide du design expérimental dans un mémoire.

    Ajoutez toujours les variables contrôlées et les variables parasites identifiées. Un jury de psychologie demandera ce que vous avez fait de l’heure de passation, de l’ordre des tâches, de la fatigue ou de la désirabilité sociale. Les nommer dans la méthode, même pour dire qu’elles n’ont pas pu être contrôlées, vaut mieux que les découvrir en soutenance.

    Faut-il formuler une hypothèse directionnelle ?

    Oui, chaque fois que la littérature le permet, et c’est presque toujours le cas en master. Une hypothèse directionnelle prédit le sens de l’effet : « plus élevé », « diminuera », « corrélation négative ». Une hypothèse non directionnelle se contente de prédire une différence ou une relation, sans sens. La première est plus risquée et plus informative ; la seconde n’est acceptable que sur un objet réellement inexploré.

    La direction a une conséquence statistique immédiate : elle justifie un test unilatéral, à condition que la direction ait été annoncée avant la collecte et qu’elle figure dans votre plan d’analyse. Un test unilatéral décidé après avoir vu les données n’est pas défendable. La logique de cette déclaration préalable est expliquée dans notre article sur le plan d’analyse statistique rédigé avant la collecte.

    Comment rédiger la formulation exacte ?

    Une hypothèse opérationnelle se rédige à l’indicatif futur ou présent, sous forme affirmative, en une phrase. Elle contient dans l’ordre : la population, la variable indépendante avec ses modalités, la variable dépendante avec son unité de mesure, et le sens de l’effet. Le gabarit qui fonctionne :

    Chez [population], [VI, modalité A] produira [VD, sens] par rapport à [VI, modalité B].

    Ou, pour une relation corrélationnelle : Chez [population], [score VI] sera corrélé [positivement / négativement] à [score VD].

    Numérotez les hypothèses opérationnelles H1, H2, H3, et reprenez exactement les mêmes numéros dans le chapitre résultats et dans la discussion. Le jury lit les trois chapitres en cherchant cette correspondance. Une H2 qui disparaît entre la méthode et les résultats est la remarque la plus fréquente en soutenance de master.

    Trois formulations à bannir : « nous pensons que », qui affaiblit la proposition ; « il existe un lien entre », qui ne prédit rien ; « l’anxiété a un impact sur la performance », qui ne dit ni le sens ni la mesure. Chacune se corrige en appliquant le gabarit.

    À quoi ressemblent les hypothèses selon la spécialité ?

    La logique est identique dans toutes les spécialités de la psychologie ; ce qui change, c’est la nature des variables et donc la forme des hypothèses opérationnelles.

    Psychologie clinique et psychopathologie

    Les variables indépendantes sont le plus souvent invoquées : groupe clinique contre groupe témoin, niveau de symptômes, exposition à un événement. Hypothèse type : « Chez des adultes consultant pour un trouble anxieux, le score de flexibilité psychologique sera corrélé négativement au score de symptômes anxieux, après contrôle de l’âge. » Les hypothèses causales y sont rares ; la prudence de formulation est attendue.

    Psychologie cognitive

    C’est la spécialité de la variable provoquée : conditions expérimentales, consignes, temps de présentation. Hypothèse type : « Les temps de réaction seront plus longs en condition d’interférence qu’en condition congruente. » Les hypothèses portent souvent sur des interactions entre deux facteurs, qu’il faut alors formuler une par une.

    Psychologie sociale

    Les mémoires combinent variables manipulées par scénario et variables mesurées par échelle. Hypothèse type : « Les participants exposés à un message de norme descriptive déclareront une intention de tri plus élevée que ceux exposés à un message informatif, et cet effet sera plus marqué chez les participants à forte identification au groupe. » La seconde partie est une hypothèse de modération, qu’il faut numéroter à part.

    Psychologie du travail et des organisations

    Les variables sont presque toutes invoquées et mesurées par questionnaire, ce qui appelle des hypothèses corrélationnelles et des modèles de médiation. Hypothèse type : « La latitude décisionnelle sera associée négativement à l’épuisement émotionnel, et cette relation sera médiatisée par le sentiment de reconnaissance. »

    Psychologie du développement

    L’âge est la variable invoquée centrale, souvent croisée avec une tâche. Hypothèse type : « Les enfants de 7 ans réussiront davantage d’essais de la tâche de fausse croyance de second ordre que les enfants de 5 ans. »

    Combien d’hypothèses opérationnelles faut-il ?

    Deux à quatre pour un mémoire de master, une à deux pour un travail de licence. Le critère n’est pas le nombre mais la couverture : chaque hypothèse opérationnelle doit tester un aspect distinct de l’hypothèse générale, et l’ensemble doit permettre de conclure sur celle-ci. Cinq hypothèses qui testent la même relation avec cinq variables dépendantes redondantes ne valent pas mieux qu’une seule.

    Chaque hypothèse appelle un test, et chaque test consomme de la puissance statistique. Avec quatre-vingts participants, quatre hypothèses opérationnelles sont raisonnables ; huit ne le sont pas. Le choix du test qui correspond à chaque hypothèse selon votre plan de recherche est détaillé dans notre guide pour choisir le test statistique d’un mémoire de psychologie.

    Que faire si l’hypothèse n’est pas confirmée ?

    La rapporter telle quelle. Une hypothèse opérationnelle infirmée n’est pas un échec du mémoire ; une hypothèse infirmée que l’on réécrit après coup pour qu’elle colle aux données en est un. Le chapitre résultats dit si H1 est confirmée, partiellement confirmée ou infirmée ; la discussion en propose l’interprétation : puissance insuffisante, opérationnalisation discutable, effet réellement absent. Ce raisonnement, et les phrases qui le portent, sont l’objet de notre article sur la lecture d’un résultat non significatif.

    Ce que le jury sanctionne, ce n’est pas l’infirmation, c’est l’incohérence : une hypothèse directionnelle dans la méthode, un test bilatéral dans les résultats, et une conclusion qui parle d’un effet « tendanciel » que rien n’a prédit.

    Formuler et opérationnaliser vos hypothèses avec Tesify

    Tesify part de votre problématique et de votre cadre théorique pour proposer l’hypothèse générale, dériver les hypothèses opérationnelles dans le gabarit attendu en psychologie, identifier pour chacune la variable indépendante, la variable dépendante et la direction de l’effet, puis rédiger la section correspondante du chapitre méthode et le tableau de correspondance hypothèses, variables, tests. Vous gardez la décision sur ce que vous testez ; vous cessez de perdre vos soirées à reformuler.

    Rédiger les hypothèses de votre mémoire de psychologie avec Tesify

    Questions fréquentes

    Quelle est la différence entre hypothèse théorique et hypothèse générale ?

    Ce sont deux noms pour le même niveau. Selon les manuels et les universités, la proposition qui relie les concepts s’appelle hypothèse théorique ou hypothèse générale ; l’hypothèse opérationnelle, parfois appelée hypothèse expérimentale, en est la traduction mesurable. Utilisez le vocabulaire de votre UFR et tenez-vous-y d’un chapitre à l’autre.

    Une hypothèse opérationnelle doit-elle nommer l’échelle utilisée ?

    Elle nomme la variable telle qu’elle est mesurée, ce qui revient le plus souvent à désigner le score d’une échelle précise. Le nom complet de l’instrument, sa version française et ses qualités psychométriques figurent dans le chapitre méthode ; l’hypothèse peut se contenter d’une désignation courte, à condition qu’elle soit sans ambiguïté.

    Peut-on formuler des hypothèses dans un mémoire qualitatif de psychologie ?

    Un mémoire qualitatif, fondé sur des entretiens analysés thématiquement, ne formule généralement pas d’hypothèses opérationnelles, parce qu’il ne mesure pas de variables. Il travaille à partir de questions de recherche et parfois d’hypothèses interprétatives, formulées comme des attentes à explorer. Précisez ce choix dans la méthode plutôt que de forcer des hypothèses sur un dispositif qui ne les teste pas.

    Faut-il écrire l’hypothèse nulle dans le mémoire ?

    Non, sauf consigne contraire de votre directeur. L’hypothèse nulle est l’objet du test statistique, pas une hypothèse de recherche, et elle est implicite dès que vous rapportez une valeur p. Mentionner qu’un test rejette ou ne rejette pas l’hypothèse nulle dans les résultats suffit ; elle n’a pas sa place dans la liste des hypothèses de la méthode.

    Où placer les hypothèses dans le plan du mémoire ?

    L’hypothèse générale clôt la partie théorique, juste après la problématique. Les hypothèses opérationnelles ouvrent le chapitre méthode ou en constituent la première section, avant la description des participants et du matériel. Elles sont ensuite reprises, avec les mêmes numéros, en tête de chaque sous-section des résultats.

    Comment savoir si une hypothèse opérationnelle est bien formulée ?

    Elle passe quatre vérifications : on peut y lire la population, la variable indépendante avec ses modalités, la variable dépendante avec sa mesure et le sens de l’effet ; le test statistique en découle sans hésitation ; un résultat contraire est possible et reconnaissable ; enfin, deux lecteurs indépendants la comprennent de la même façon.
  • Comment choisir le test statistique d’un mémoire de psychologie : le tableau par plan de recherche (2026)

    Comment choisir le test statistique d’un mémoire de psychologie : le tableau par plan de recherche (2026)

    Un mémoire de psychologie ne choisit pas son test statistique dans un manuel : il le déduit de son plan de recherche. Deux groupes ou un seul, mesures répétées ou indépendantes, variable manipulée ou simplement mesurée, une variable dépendante ou plusieurs — quand ces quatre questions ont une réponse, le test est désigné. Ce guide déroule cette déduction étape par étape, dans les termes que les enseignants de méthodologie et les jurys de master en psychologie utilisent, avec le tableau de correspondance à recopier dans votre plan d’analyse et les conventions de rapport propres à la discipline.

    Il s’adresse à l’étudiant qui a ses données, ou son protocole, et qui doit écrire la section « analyses statistiques » de son chapitre méthode cette semaine. Si votre hypothèse opérationnelle n’est pas encore stabilisée, commencez par notre article sur la façon de formuler les hypothèses d’un mémoire de psychologie : le test se déduit de l’hypothèse, jamais l’inverse.

    Étape 1. Identifier votre plan de recherche

    La méthodologie en psychologie distingue quatre grandes familles de plans, et chacune ouvre un sous-ensemble de tests. Reconnaissez le vôtre avant toute chose.

    • Plan expérimental : vous manipulez une variable indépendante et vous répartissez les participants au hasard entre les conditions. C’est le plan de la psychologie cognitive et d’une partie de la psychologie sociale.
    • Plan quasi expérimental : vous comparez des groupes que vous n’avez pas constitués au hasard — patients contre témoins, classes existantes, avant et après une intervention sans groupe contrôle randomisé. Fréquent en clinique et en psychologie du développement.
    • Plan corrélationnel : vous mesurez plusieurs variables sur un même échantillon, par questionnaire le plus souvent, et vous étudiez leurs relations. C’est le plan de la psychologie du travail et de la majorité des mémoires cliniques par questionnaire.
    • Plan mixte : vous combinez un facteur inter-sujets (groupe) et un facteur intra-sujets (temps ou condition). Le plus riche, et le plus exigeant en analyse.

    Les propriétés de chacun de ces plans — ce qu’ils permettent de conclure, leurs menaces de validité — sont détaillées dans notre guide du design expérimental dans un mémoire. Le présent article commence là où ce guide s’arrête : au choix du test.

    Étape 2. Qualifier vos variables

    Pour chaque hypothèse opérationnelle, notez la nature de la variable indépendante et de la variable dépendante. Trois questions suffisent.

    Combien de modalités a la variable indépendante ? Deux (condition contre contrôle, patients contre témoins) ou plus de deux (trois niveaux de difficulté, quatre groupes d’âge). Le passage de deux à trois modalités change le test : le t de Student cède la place à l’analyse de variance.

    Les mesures sont-elles indépendantes ou appariées ? Indépendantes quand chaque participant n’est que dans une condition ; appariées quand le même participant est mesuré plusieurs fois, ou quand les participants sont appariés deux à deux. Toute la famille des tests se dédouble sur ce critère.

    Quelle est la nature de la variable dépendante ? Un score continu (temps de réaction, score d’échelle, nombre de bonnes réponses), un rang ou une échelle ordinale, ou une catégorie (réussite ou échec, diagnostic présent ou absent). C’est le critère qui sépare les tests paramétriques, non paramétriques et catégoriels.

    Étape 3. Lire le tableau de correspondance

    Arbre de décision menant du plan de recherche d'un mémoire de psychologie au test statistique
    Du plan de recherche au test : quatre questions, une déduction.

    Le tableau ci-dessous croise les réponses aux étapes 1 et 2 et désigne le test attendu dans un mémoire de psychologie, avec son équivalent non paramétrique quand les conditions ne sont pas remplies, et la taille d’effet à rapporter.

    Votre hypothèse Plan et variables Test Repli non paramétrique Taille d’effet
    Deux groupes diffèrent sur un score Inter-sujets, VI à 2 modalités, VD continue t de Student pour échantillons indépendants (Welch si variances inégales) U de Mann-Whitney d de Cohen
    Un même groupe change entre deux mesures Intra-sujets, 2 mesures, VD continue t apparié Wilcoxon d de Cohen apparié
    Trois groupes ou plus diffèrent Inter-sujets, VI à 3+ modalités ANOVA à un facteur, puis post hoc de Tukey Kruskal-Wallis êta carré partiel
    Un même groupe est mesuré trois fois ou plus Intra-sujets, 3+ mesures ANOVA à mesures répétées, correction de Greenhouse-Geisser si besoin Friedman êta carré partiel
    Deux facteurs se combinent Plan factoriel 2×2 ou plus ANOVA factorielle, effets principaux et interaction aucun équivalent simple êta carré partiel
    Groupe et temps se combinent Plan mixte ANOVA mixte, interaction groupe × temps aucun équivalent simple êta carré partiel
    Deux scores sont liés Corrélationnel, 2 VD continues r de Pearson rho de Spearman r lui-même
    Plusieurs variables prédisent un score Corrélationnel, 2+ prédicteurs Régression linéaire multiple régression sur rangs, rarement R carré, bêta standardisés
    Une variable explique le lien entre deux autres Corrélationnel, médiation Effet indirect par bootstrap (macro PROCESS, modèle 4) effet indirect et son intervalle
    Le lien varie selon une troisième variable Corrélationnel, modération Régression avec terme d’interaction, pentes simples variation de R carré
    Deux variables catégorielles sont liées VD catégorielle Khi-deux d’indépendance test exact de Fisher V de Cramér
    Prédire une issue binaire VD binaire, prédicteurs continus ou non Régression logistique rapports de cotes

    Ce tableau est organisé par question de recherche parce que c’est ainsi qu’un jury de psychologie raisonne. Une autre entrée, par nature de la variable dépendante, existe dans notre annuaire des analyses selon la variable dépendante ; les deux se recoupent et se complètent.

    Étape 4. Vérifier les conditions, puis décider du repli

    Chaque test paramétrique repose sur des conditions que vous devez vérifier et rapporter : normalité des distributions ou des résidus, homogénéité des variances, sphéricité pour les mesures répétées, linéarité et absence de multicolinéarité pour la régression. En psychologie, les jurys attendent que ces vérifications figurent dans le chapitre résultats, en une phrase par condition.

    Le repli non paramétrique n’est pas automatique. Avec trente participants par groupe et une asymétrie modérée, le t de Student et l’ANOVA restent robustes ; en dessous de quinze par groupe, ou face à une distribution franchement asymétrique, le test de rangs devient le choix prudent. Ce qu’un jury sanctionne, ce n’est pas d’avoir gardé le test paramétrique, c’est de ne pas avoir regardé. La procédure pour chaque condition et son plan de secours sont recensés dans notre annuaire des conditions statistiques et de leurs plans de secours.

    Trois cas particuliers reviennent en psychologie. Les temps de réaction sont presque toujours asymétriques : la pratique courante consiste à exclure les temps aberrants selon une règle annoncée à l’avance, puis à analyser la moyenne ou la médiane par participant. Les scores d’échelle de Likert sont traités comme continus dès qu’ils sont moyennés sur plusieurs items, jamais item par item. Les effectifs cliniques, souvent inférieurs à vingt par groupe, orientent vers les tests de rangs et imposent de discuter la puissance.

    Étape 5. Choisir le logiciel

    Trois logiciels couvrent la quasi-totalité des mémoires de psychologie en France, et le choix dépend d’abord de ce que votre UFR enseigne.

    SPSS reste la référence des UFR de psychologie et de la plupart des directeurs de mémoire ; la macro PROCESS s’y ajoute pour les médiations et modérations. Jamovi et JASP sont gratuits, produisent des sorties directement au format attendu par les normes APA et sont de plus en plus acceptés, y compris pour les ANOVA à mesures répétées. R est attendu dans les masters à orientation recherche et en psychologie cognitive, où les analyses de temps de réaction et les modèles mixtes le rendent difficile à contourner. Aucun jury ne pénalise un logiciel gratuit ; tous pénalisent une sortie mal lue.

    Étape 6. Rapporter le résultat aux normes de la discipline

    Phrase de résultat statistique avec ses trois éléments mis en évidence : statistique, valeur p et taille d'effet
    Une phrase de résultat aux normes APA : la statistique, la valeur p et la taille d’effet.

    La psychologie rapporte ses résultats selon les normes de l’American Psychological Association, que les UFR françaises appliquent dans leur septième édition. Chaque résultat comporte quatre éléments dans un ordre fixe : la statistique du test avec ses degrés de liberté, la valeur de probabilité exacte, la taille d’effet, et l’intervalle de confiance quand il est disponible. Une différence de moyennes se rapporte ainsi : t(58) = 2,41, p = 0,019, d = 0,62, IC à 95 % [0,10 ; 1,14].

    Trois conventions propres à la discipline : la valeur de p s’écrit exacte à trois décimales, sauf en dessous de 0,001 ; la taille d’effet est obligatoire même pour un résultat non significatif ; les statistiques descriptives (moyenne et écart-type par condition) précèdent toujours le test inférentiel. La phrase exacte à écrire pour chaque test figure dans notre annuaire des phrases pour rapporter chaque test statistique.

    Un point que les jurys de psychologie regardent de près : la cohérence entre la statistique, les degrés de liberté et la valeur p. Une recopie fautive se détecte en quelques secondes avec les outils de vérification, et elle jette le doute sur l’ensemble du chapitre.

    Étape 7. Écrire la section « analyses statistiques » du chapitre méthode

    Cette section se rédige avant l’analyse, au futur ou au présent, et tient en une demi-page. Elle contient, dans l’ordre : le logiciel et sa version ; le seuil de significativité retenu ; pour chaque hypothèse opérationnelle, numérotée, le test prévu et la taille d’effet associée ; les conditions qui seront vérifiées et le repli prévu si elles ne le sont pas ; la règle de traitement des valeurs manquantes et des données aberrantes.

    Un tableau à trois colonnes — hypothèse, variables, test — clôt utilement la section. C’est celui que le jury consultera pendant la soutenance pour vérifier que chaque hypothèse a bien été testée par le test annoncé. Rédiger ce tableau avant de voir les données protège en outre contre la tentation de choisir, après coup, le test qui donne le résultat souhaité — la logique du plan d’analyse déclaré, présentée dans notre article sur le plan d’analyse statistique rédigé avant la collecte.

    Les cinq erreurs les plus fréquentes dans un mémoire de psychologie

    1. Multiplier les t de Student au lieu d’une ANOVA sur trois groupes, ce qui gonfle le risque de faux positif.
    2. Analyser un plan intra-sujets avec un test pour échantillons indépendants, en oubliant que les mesures sont appariées.
    3. Corréler item par item plutôt que sur les scores composites, ce qui produit des dizaines de coefficients ininterprétables.
    4. Conclure à une causalité à partir d’un plan corrélationnel, y compris après une médiation.
    5. Omettre la taille d’effet et s’en tenir à la valeur p, alors que la discipline exige les deux depuis plus de dix ans.

    Choisir et rédiger vos analyses avec Tesify

    Tesify part de vos hypothèses opérationnelles et de la description de votre plan pour proposer le test correspondant à chacune, la liste des conditions à vérifier, la taille d’effet à rapporter, puis rédige la section « analyses statistiques » du chapitre méthode et le tableau hypothèses, variables, tests. Il formule ensuite les phrases de résultats aux normes APA à partir des chiffres de vos sorties. Vous conservez l’analyse ; vous cessez de perdre des soirées à la mettre en forme.

    Rédiger la section analyses de votre mémoire de psychologie avec Tesify

    Questions fréquentes

    Quel test pour comparer un groupe de patients et un groupe témoin ?

    Un t de Student pour échantillons indépendants si la variable dépendante est un score continu et que les effectifs dépassent une quinzaine par groupe ; un U de Mann-Whitney si les effectifs sont faibles ou la distribution très asymétrique. Rapportez dans les deux cas une taille d’effet et les statistiques descriptives de chaque groupe.

    Faut-il une ANOVA ou plusieurs tests t ?

    Une ANOVA dès que la variable indépendante a trois modalités ou plus, suivie de comparaisons post hoc corrigées. Enchaîner des tests t sur chaque paire de groupes multiplie le risque de conclure à tort à une différence, et un jury de psychologie le relèvera.

    Combien de participants faut-il pour un mémoire de psychologie quantitatif ?

    Cela dépend du test et de la taille d’effet attendue : une trentaine par groupe pour une comparaison de deux moyennes avec un effet moyen, davantage pour une interaction ou une régression à plusieurs prédicteurs. Le calcul se fait avant la collecte avec un logiciel de puissance et se rapporte dans le chapitre méthode.

    Peut-on utiliser Jamovi ou JASP à la place de SPSS ?

    Oui, dans la grande majorité des UFR. Ces logiciels gratuits couvrent tous les tests d’un mémoire de master, y compris les ANOVA à mesures répétées et les médiations, et produisent des tableaux au format APA. Vérifiez simplement que votre directeur peut relire vos sorties.

    Que faire quand les conditions du test ne sont pas remplies ?

    Vérifier d’abord l’ampleur du problème, car les tests paramétriques tolèrent des écarts modérés à la normalité dès que les groupes dépassent une trentaine de participants. Si l’écart est important ou les effectifs faibles, passer au test de rangs équivalent, le dire explicitement dans les résultats et rapporter la taille d’effet adaptée.

    La médiation prouve-t-elle une causalité ?

    Non. Une analyse de médiation sur des données transversales décrit une structure de relations compatible avec un mécanisme causal ; elle ne l’établit pas. La formulation attendue dans la discussion est celle d’une relation cohérente avec l’hypothèse, et les limites doivent mentionner le caractère corrélationnel du plan.

  • Titre de mémoire : 40 exemples par discipline et la formule qui fonctionne (2026)

    Titre de mémoire : 40 exemples par discipline et la formule qui fonctionne (2026)

    Le titre est la première phrase de votre mémoire que le jury lit, et la seule que les moteurs de recherche de DUMAS ou de theses.fr indexeront intégralement. Pourtant, il est presque toujours écrit en dernier, en dix minutes, la veille du dépôt. Résultat : des titres trop larges (« Le management dans les PME »), des accroches sans contenu (« Quand le soin devient parole ») ou des intitulés de vingt-huit mots que personne ne retiendra en soutenance.

    Cet article donne la formule qui fonctionne dans la quasi-totalité des disciplines, puis quarante exemples construits, discipline par discipline, avec la convention propre à chacune. Ce sont des modèles de structure, pas des sujets à reprendre.

    Ce que le titre d’un mémoire doit faire, et ce qu’il ne doit pas faire

    Un bon titre remplit trois fonctions en une ligne et demie. Il nomme l’objet (de quoi parle le travail), il situe le terrain (où, auprès de qui, sur quelle période) et il annonce l’angle (la question, la relation ou la tension étudiée). Un titre qui ne remplit qu’une de ces fonctions décrit un rayon de bibliothèque ; un titre qui les remplit toutes décrit une recherche.

    Il doit aussi être retrouvable. Les mémoires déposés sur DUMAS et les thèses de theses.fr sont interrogés d’abord par leur titre : les mots que vous y placez sont ceux qui ramèneront des lecteurs, des futurs étudiants et, parfois, des recruteurs. Notre guide sur les mots-clés et l’indexation d’un mémoire sur DUMAS et HAL détaille ce mécanisme ; le titre en est la première brique.

    Ce qu’il ne doit pas faire : promettre plus que le mémoire ne tient. « L’impact de l’intelligence artificielle sur l’emploi » annonce une thèse en trois volumes ; le mémoire derrière porte sur dix entretiens dans une entreprise de logistique, et le décalage se paie en soutenance.

    La formule : objet, terrain, angle, en deux niveaux

    Schéma d'un titre de mémoire à deux niveaux : un titre principal et un sous-titre séparés par deux-points
    Le titre à deux niveaux : l’objet et l’angle au premier, le terrain et la méthode au second.

    La structure la plus robuste en français universitaire est le titre à deux niveaux séparés par deux-points. Le premier niveau porte l’objet et l’angle ; le second précise le terrain, la méthode ou la population. Chaque niveau tient en six à douze mots.

    Forme Structure Quand l’utiliser Exemple
    Nominale à deux niveaux Objet et angle : terrain et méthode Le cas général, toutes disciplines La fidélisation des clients par abonnement : une étude quantitative auprès de 180 abonnés d’une enseigne de sport
    Interrogative Question directe : sous-titre nominal Sciences humaines, éducation, travail social Pourquoi les enseignants débutants quittent-ils le métier ? Trajectoires de dix professeurs des écoles en Seine-Saint-Denis
    Citation puis cadrage « Verbatim court » : objet et terrain Recherches qualitatives, sociologie, soins « On fait avec » : le travail d’ajustement des aides-soignantes de nuit en EHPAD
    Relation entre deux termes X et Y : angle, terrain Droit, science politique, économie Télétravail et pouvoir de direction : le contrôle de l’activité du salarié après les accords de 2020

    Les mots à supprimer d’office : « étude de », « analyse de », « contribution à », « réflexion sur », « approche de ». Ils occupent trois mots pour dire que vous avez étudié quelque chose, ce que le lecteur sait déjà. « Analyse de la motivation des salariés en télétravail » devient « La motivation des salariés en télétravail », et gagne une place pour le terrain.

    40 exemples de titres de mémoire, discipline par discipline

    Fiches d'exemples de titres de mémoire classées par discipline
    Chaque discipline a sa convention de titre ; les exemples qui suivent la respectent.

    Chaque discipline a une convention de titre que les jurys reconnaissent immédiatement. Les exemples ci-dessous la respectent ; le commentaire en tête de section dit laquelle.

    Droit

    Le titre juridique est nominal, sans question, et il nomme le mécanisme étudié avec le vocabulaire exact du code ou de la jurisprudence. Le sous-titre précise souvent la période ou le texte de référence. La construction des intitulés internes obéit à d’autres règles, décrites dans notre article sur les titres qualifiants et le plan binaire d’un mémoire de droit.

    1. La clause de non-concurrence après la rupture conventionnelle : contrepartie financière et renonciation de l’employeur
    2. Le consentement du mineur au traitement de ses données personnelles : l’article 45 de la loi Informatique et Libertés à l’épreuve des plateformes
    3. L’obligation de vigilance des sociétés mères : premières applications judiciaires de la loi du 27 mars 2017
    4. Le bail mobilité et la précarisation du logement étudiant : un régime dérogatoire en question

    Gestion, management et marketing

    Le titre annonce une relation entre deux construits et le terrain d’entreprise. La mention du nombre de répondants ou du secteur dans le sous-titre est appréciée, parce qu’elle signale d’emblée la portée des résultats.

    1. Marque employeur et intention de candidater : une enquête auprès de 214 étudiants en fin de master
    2. Le management à distance et la confiance perçue : le cas d’une direction régionale bancaire après 2020
    3. Avis en ligne et intention d’achat en restauration : le rôle modérateur de la familiarité avec l’enseigne
    4. Le rebranding d’une marque patrimoniale et la réaction des clients fidèles : étude de cas d’une maison de biscuiterie bretonne

    Psychologie

    La convention est celle des articles scientifiques : les variables apparaissent dans le titre, la population aussi, et la relation étudiée est explicite. On évite les métaphores.

    1. Anxiété d’évaluation et performance en mathématiques chez les élèves de troisième : le rôle médiateur du sentiment d’efficacité personnelle
    2. Charge mentale des aidants de personnes atteintes de la maladie d’Alzheimer : stratégies de coping et qualité de vie
    3. Effet de la présentation du feedback sur la motivation intrinsèque : une étude expérimentale auprès de 96 étudiants de licence
    4. Alliance thérapeutique en visioconsultation : perception de patients suivis pour un trouble anxieux

    Sciences de l’éducation et MEEF

    Le titre situe le niveau scolaire et, très souvent, le dispositif étudié. Le mémoire MEEF gagne à nommer la compétence professionnelle ou la discipline enseignée.

    1. La différenciation pédagogique en cycle 3 : pratiques déclarées et pratiques observées chez six professeurs des écoles
    2. Le débat philosophique en classe de CM2 et le développement de l’argumentation orale
    3. Évaluer sans noter : effets d’une évaluation par ceintures sur l’engagement des élèves de sixième en français
    4. Les représentations de l’erreur chez les enseignants stagiaires : une enquête auprès de 42 fonctionnaires stagiaires d’un INSPÉ

    Soins infirmiers

    Le travail de fin d’études infirmier a une convention propre : le titre porte les deux concepts du cadre conceptuel et le contexte de soins, souvent avec un verbatim en ouverture.

    1. Le toucher relationnel auprès de la personne âgée désorientée : posture soignante en unité de soins de longue durée
    2. « Je n’ai pas le temps » : la relation d’aide en service de médecine face à la charge de travail
    3. L’annonce d’une mauvaise nouvelle et la place de l’infirmier : entre rôle prescrit et rôle propre
    4. L’accompagnement du refus de soin chez le patient en fin de vie : autonomie, consentement et responsabilité infirmière

    Sociologie et travail social

    La citation en ouverture, suivie d’un sous-titre nominal, est la forme la plus répandue. Le terrain est nommé avec précision : type d’établissement, territoire, public.

    1. « On n’est pas des assistantes sociales » : le travail relationnel des conseillères en insertion dans une mission locale
    2. Habiter en foyer de jeunes travailleurs : trajectoires résidentielles et sociabilités de jeunes en apprentissage
    3. La parentalité sous contrôle : les mères suivies en aide éducative à domicile face à l’injonction à coopérer
    4. Devenir éducateur spécialisé : socialisation professionnelle et épreuves du premier poste en MECS

    Science politique et relations internationales

    Le titre articule un objet politique et une échelle. Les titres à deux termes reliés par « et » y sont fréquents, à condition que le sous-titre indique ce qui relie les deux.

    1. Mobilisation et institutionnalisation : le devenir d’un collectif de riverains face à un projet d’éoliennes en Haute-Vienne
    2. Gouverner par les données : la fabrique des indicateurs de performance dans une métropole française
    3. Le vote des jeunes ruraux aux élections municipales de 2026 : abstention, offre politique et sentiment d’abandon
    4. Diplomatie climatique et intérêts nationaux : la position française dans les négociations sur les pertes et préjudices

    Économie et finance

    Le titre nomme la variable expliquée, la variable explicative et les données. La mention de la période et du niveau d’observation évite toute ambiguïté sur la portée.

    1. Prix de l’immobilier et gares du Grand Paris Express : une estimation en différence de différences sur les transactions 2015-2024
    2. Le coût du crédit aux PME après la remontée des taux : une analyse sur données de la Banque de France
    3. Télétravail et productivité dans les services : ce que révèlent les enquêtes emploi 2021-2024
    4. La tarification dynamique du train et l’accès à la mobilité : effets distributifs d’une politique commerciale

    STAPS et sciences du sport

    Le titre indique le protocole, la population et la mesure. Les abréviations de tests standardisés y sont admises quand elles sont reconnues.

    1. Effets d’un programme d’activité physique adaptée de douze semaines sur la capacité fonctionnelle de patients coronariens
    2. Motivation autodéterminée et abandon sportif chez les nageuses de 14 à 17 ans : une étude longitudinale sur une saison
    3. Charge d’entraînement perçue et blessures sans contact en football amateur : suivi de deux équipes de Régional 1
    4. Le management d’un club omnisports associatif face à la professionnalisation : le cas d’une structure de 2 000 licenciés

    Lettres, langues et histoire

    Le titre situe le corpus, l’auteur ou la période, et l’angle d’analyse. Le sous-titre précise souvent les bornes chronologiques ou la nature du corpus.

    1. Dire la ville sans la nommer : les espaces urbains dans les romans de Marguerite Duras
    2. L’apprentissage du français par des adultes allophones en atelier sociolinguistique : analyse d’un corpus d’interactions
    3. Une paroisse rurale face à la Révolution : le registre des délibérations de Saint-Julien-de-Coppel, 1789-1795
    4. Traduire l’humour : les stratégies de sous-titrage d’une série britannique en français et en espagnol

    Les six erreurs qui coûtent un titre

    1. Le titre-rayon. « Le marketing digital des PME » ne dit ni ce que vous avez cherché, ni où. Ajoutez un angle et un terrain, ou reconnaissez que le sujet n’est pas encore cadré ; dans ce cas, notre méthode pour choisir et resserrer un sujet de mémoire vous fera gagner un mois.
    2. L’accroche seule. « Quand les murs parlent » sans sous-titre est un titre de roman. L’accroche est admise, mais elle exige un second niveau qui dit l’objet.
    3. La question rhétorique. « L’intelligence artificielle va-t-elle remplacer les enseignants ? » appelle un oui ou un non que le mémoire ne donnera pas. Une question de titre doit être une vraie question de recherche, à laquelle votre terrain répond.
    4. Le jargon opaque. Un titre que votre tuteur d’entreprise ne comprend pas ne sera pas retrouvé par les moteurs. Réservez les termes techniques au sous-titre.
    5. La promesse trop large. « En France », « dans les organisations », « chez les jeunes » : chaque mot de généralisation sera retourné contre vous en soutenance. Nommez le terrain réel.
    6. La longueur. Au-delà de vingt mots, le titre ne tient plus sur une ligne de page de garde et ne se mémorise pas. Coupez le second niveau, jamais le premier.

    Titre provisoire, titre définitif : quand le fixer

    Le titre déposé en début d’année est provisoire par nature : votre problématique va bouger, votre terrain va se resserrer. La plupart des universités acceptent un changement de titre jusqu’au dépôt, avec un formulaire signé du directeur. Vérifiez la procédure dès le second semestre, pas la veille.

    Le moment juste pour l’écrire définitivement est celui où votre problématique est stabilisée et votre plan arrêté, c’est-à-dire après la collecte et avant la rédaction de l’introduction. La méthode pour arriver à une problématique qui tient est exposée dans notre article sur la formulation de la problématique d’un mémoire ; le titre en est la version condensée, en une ligne et demie.

    Une fois fixé, le titre se retrouve à trois endroits qui doivent être strictement identiques : la page de garde, le formulaire de dépôt et le résumé. Les règles de mise en forme de la première sont détaillées dans notre guide de la page de garde d’un mémoire. Une différence d’un mot entre la page de garde et le dépôt peut bloquer la validation administrative.

    Tester son titre en soixante secondes

    Avant d’arrêter votre choix, faites passer le titre par cinq questions. Chaque « non » désigne la correction à faire.

    • Un lecteur qui ne lit que le titre sait-il de quoi le mémoire parle, où il a été mené et ce qu’il cherche ?
    • Les trois mots les plus importants de votre problématique y figurent-ils ?
    • Peut-on le lire à voix haute sans reprendre son souffle ?
    • Est-il honnête sur la portée : nomme-t-il le terrain réel plutôt qu’un ensemble que vous n’avez pas étudié ?
    • Retirez-en un mot : le titre perd-il quelque chose ? Si non, le mot était de trop.

    Trouver le titre avec Tesify

    Tesify part de votre problématique et de votre plan pour proposer plusieurs formulations de titre dans la convention de votre discipline, niveau principal et sous-titre, puis génère le résumé et les mots-clés cohérents avec le titre retenu.

    Formuler le titre et le résumé de votre mémoire avec Tesify

    Questions fréquentes

    Quelle longueur pour un titre de mémoire ?

    Entre huit et vingt mots, sous-titre compris. En dessous de huit, le titre manque presque toujours de terrain ou d’angle ; au-delà de vingt, il ne tient plus sur une ligne de page de garde et devient impossible à citer. Le premier niveau tient en six à dix mots, le second en six à douze.

    Un titre de mémoire peut-il être une question ?

    Oui, dans les disciplines qui l’admettent : sciences de l’éducation, sociologie, travail social, science politique. Il doit alors s’agir de la question de recherche elle-même, suivie d’un sous-titre nominal qui situe le terrain. En droit, en économie et en psychologie, la forme nominale reste la norme.

    Faut-il mettre le nom de l’entreprise dans le titre ?

    Seulement si l’entreprise a donné son accord écrit et si le mémoire n’est pas soumis à confidentialité. Dans le doute, décrivez-la sans la nommer : « une enseigne de distribution alimentaire », « un cabinet d’expertise comptable de 40 salariés ». Le terrain reste identifiable pour le jury sans exposer l’organisation.

    Peut-on changer le titre de son mémoire après l’avoir déclaré ?

    Dans la plupart des universités, oui, jusqu’au dépôt, sur accord du directeur de mémoire et par un formulaire de modification. Le titre définitif doit ensuite être identique sur la page de garde, dans le résumé et sur le formulaire de dépôt. Renseignez-vous sur la procédure dès que votre problématique est stabilisée.

    Le titre doit-il contenir l’année ou la période étudiée ?

    Il le doit dès que la période fait partie de l’objet : une réforme, une crise, des données datées, un corpus borné. Elle se place dans le sous-titre, en chiffres. Si la période n’est qu’un contexte de collecte, elle n’a pas sa place dans le titre et figure dans la méthodologie.

  • Le journal d’analyse : tracer vos décisions statistiques avant la soutenance (2026)

    Le journal d’analyse : tracer vos décisions statistiques avant la soutenance (2026)

    La question tombe à la douzième minute de votre soutenance, sur un ton parfaitement aimable : « Vous mentionnez 176 participants dans votre méthodologie, mais vos tableaux en comptent 168. Que sont devenus les huit autres ? »

    Vous le savez, ou vous l’avez su. C’était en mars, un dimanche soir, vous aviez retiré des questionnaires manifestement remplis au hasard. Mais nous sommes en septembre, et vous êtes incapable de dire lesquels, combien exactement, ni selon quel critère.

    Cette question n’est pas piégeuse. C’est la plus banale des questions de méthode, et elle est mortelle sans traçabilité — non parce que la décision était mauvaise, mais parce que ne pas pouvoir la justifier la fait ressembler à un arrangement.

    Le journal d’analyse est la parade. C’est un tableau de quatre colonnes, tenu au fil de l’eau, qui coûte deux minutes par entrée et vous rend un mémoire défendable.

    Pourquoi la mémoire ne suffit pas

    Entre la collecte et la soutenance, il s’écoule souvent six à dix mois. Sur cette durée, vous prendrez entre quinze et trente décisions de traitement, la plupart prises rapidement, seul, dans un moment de concentration où elles paraissent évidentes.

    Trois choses s’effacent, dans cet ordre : le seuil exact que vous aviez retenu, la raison pour laquelle vous l’aviez choisi, et l’existence même de la décision. La dernière est la plus dangereuse : une décision oubliée devient une incohérence inexpliquée entre deux chapitres.

    Il y a aussi un enjeu qui dépasse la soutenance. Une décision prise après avoir vu les résultats et une décision prise avant sont deux choses radicalement différentes sur le plan scientifique. Sans trace datée, vous ne pouvez plus prouver l’ordre — et cette impossibilité, un lecteur exigeant la retiendra contre vous.

    Chronologie des décisions d'analyse consignées au fil du travail
    La date est la colonne la plus importante : elle prouve qu’une règle a été fixée avant d’avoir vu le résultat.

    Le format : quatre colonnes, rien de plus

    Un tableur ou un simple document suffit. Quatre colonnes, une ligne par décision.

    Date Décision Motif Effet
    12/03 Exclusion de 8 questionnaires remplis à moins de 50 % Seuil fixé avant analyse ; réponses inexploitables N passe de 176 à 168
    14/03 Recodage inversé des items 3, 7 et 11 de l’échelle Items formulés négativement dans l’instrument d’origine Alpha de 0,42 à 0,81
    18/03 Regroupement des modalités « autre » et « sans emploi » Effectifs inférieurs à 5, khi-deux inapplicable 4 modalités au lieu de 6
    02/04 Passage à l’ANOVA de Welch Levene significatif (p = 0,008), règle annoncée en méthodologie Conclusion inchangée

    La colonne Effet est celle que tout le monde oublie, et c’est la plus utile. Elle vous dit, d’un coup d’œil, si une décision a compté. « Conclusion inchangée » désamorce d’avance toute suspicion ; « le coefficient passe de non significatif à significatif » vous avertit qu’il faudra en parler, et vaut mieux le savoir maintenant que devant le jury.

    Les huit décisions à consigner systématiquement

    1. Exclusions de participants — combien, lesquels, selon quel critère, fixé quand.
    2. Traitement des données manquantes — suppression, imputation, seuil de tolérance par variable. Le sujet a ses subtilités, détaillées dans notre article sur les données manquantes et les mécanismes MCAR, MAR et MNAR.
    3. Recodages et transformations — items inversés, passage au logarithme, création de scores composites.
    4. Regroupements de modalités — quelles catégories fusionnées, pour quelle raison statistique.
    5. Traitement des valeurs extrêmes — conservées, écartées, ou analysées dans les deux cas.
    6. Changements de test — chaque bifurcation liée à une condition d’application, avec le diagnostic qui l’a déclenchée. C’est le cas le plus fréquent, et l’annuaire des conditions statistiques et de leurs plans de secours les recense toutes.
    7. Choix de seuils — niveau de significativité, correction des comparaisons multiples, seuil de VIF retenu.
    8. Analyses abandonnées — la plus négligée et la plus protectrice. Si vous avez testé un modèle qui ne figure pas dans le mémoire, notez-le et notez pourquoi.

    Le cas particulier des analyses abandonnées

    Il mérite un mot, parce qu’il touche à l’intégrité. Tester dix modèles et ne rapporter que celui qui « marche » revient à transformer une exploration en confirmation — et un jury attentif s’en rend compte, parce qu’un modèle isolé qui fonctionne parfaitement dans un jeu de données modeste est statistiquement suspect.

    La conduite honnête n’est pas de tout rapporter, mais de savoir ce que vous avez fait et de pouvoir le dire. « J’ai d’abord testé une spécification avec l’ancienneté en variable continue ; la relation n’étant pas linéaire, je suis passé à un découpage en classes » est une phrase qui inspire confiance. « Je ne me souviens pas d’avoir testé autre chose », face à un directeur qui se rappelle du contraire, ne l’inspire pas.

    Modèle de tableau à quatre colonnes pour consigner chaque décision
    Quatre colonnes, deux minutes par ligne. C’est tout le dispositif.

    Comment le tenir sans que ça devienne un travail

    Une ligne, immédiatement. La règle unique : dès que vous modifiez quoi que ce soit à vos données ou que vous changez de test, vous écrivez la ligne avant de continuer. Écrite sur le moment, elle prend deux minutes ; reconstituée trois mois plus tard, elle en prend trente et reste approximative.

    Ne renommez jamais un fichier par-dessus l’ancien. Gardez une version intacte de vos données brutes, séparée de vos fichiers de travail, et numérotez les étapes. Le journal renvoie alors à un état de fichier précis, ce qui rend chaque décision réellement vérifiable.

    Conservez vos commandes. Si votre logiciel permet d’enregistrer une syntaxe ou un script plutôt que de tout faire à la souris, faites-le : c’est un journal automatique, exact et daté, qui documente gratuitement la moitié de vos manipulations.

    Un seul endroit. Un fichier, pas trois. Le journal éclaté entre un carnet papier, des notes de téléphone et des commentaires dans un tableur ne sera jamais relu.

    Cette discipline s’intègre naturellement à la planification générale du mémoire — voyez notre guide du rétroplanning de mémoire de master pour situer la phase d’analyse dans votre calendrier.

    Du journal à la méthodologie

    Le journal n’est pas destiné à être recopié tel quel : c’est une matière première. Le passage se fait en trois mouvements.

    Ce qui remonte en méthodologie : les règles générales, formulées à l’impersonnel et au passé. « Les questionnaires complétés à moins de 50 % ont été exclus de l’analyse (n = 8), selon un critère fixé avant le traitement des données. »

    Ce qui remonte en résultats : les bifurcations liées à un diagnostic, avec le chiffre qui les a déclenchées. « Le test de Levene indiquant une hétérogénéité des variances (p = 0,008), l’ANOVA de Welch a été retenue. »

    Ce qui remonte en discussion : les décisions dont l’effet a été notable, traitées en limites. « Le regroupement des modalités les moins représentées, rendu nécessaire par des effectifs théoriques insuffisants, réduit la finesse de l’analyse par catégorie socioprofessionnelle. »

    Une version synthétique en annexe est un plus apprécié, surtout si vous avez pris plusieurs décisions discutables : elle montre que rien n’est caché. Ajoutez-la à votre checklist de relecture avant soutenance.

    Le jour de la soutenance

    Relisez le journal la veille. C’est, très concrètement, une banque de réponses aux questions de méthode : chaque ligne correspond à une question possible, et vous en avez déjà la réponse datée et chiffrée.

    L’effet en séance est net. À « pourquoi avez-vous exclu ces participants ? », vous répondez : « Selon un critère de complétude fixé avant analyse, à 50 % du questionnaire. Huit questionnaires étaient concernés, l’échantillon analysé compte donc 168 répondants, et une vérification incluant ces huit cas ne modifie pas les conclusions. »

    Trois phrases, un critère, un chiffre, une vérification. La question est close, et vous venez de démontrer une rigueur que le reste de la soutenance n’aura plus à prouver. Notre guide de la soutenance de mémoire et des questions du jury couvre la préparation générale de l’oral.

    Le journal a d’ailleurs une vertu qui dépasse la soutenance : il rend votre travail reproductible. Un lecteur disposant de vos données brutes et de votre journal doit pouvoir retrouver vos tableaux. C’est la même exigence de transparence que celle qui structure la triangulation en recherche qualitative, appliquée au versant quantitatif.

    Transformer le journal en chapitres, avec Tesify

    Le journal règle la traçabilité. Reste le travail qui prend le plus de temps : convertir un tableau de décisions techniques en prose académique, la répartir correctement entre méthodologie, résultats et discussion, et maintenir exactement le même vocabulaire et les mêmes seuils d’un chapitre à l’autre sur cent pages.

    Tesify est conçu pour cette étape. À partir de vos propres décisions d’analyse, il vous aide à structurer les passages de justification, à les placer au bon endroit du mémoire, et à garder une terminologie constante — le point où les mémoires quantitatifs perdent le plus de points sans que leurs auteurs s’en aperçoivent. Vos données, vos arbitrages et vos conclusions restent les vôtres, et le texte est écrit à 100 % par vous.

    Rédiger votre méthodologie avec Tesify

    Questions fréquentes

    Le journal d’analyse doit-il figurer dans le mémoire ?

    Il n’est pas obligatoire dans le corps du texte, et il n’y a d’ailleurs pas sa place sous forme brute. Son rôle premier est d’alimenter votre section méthodologie et de vous préparer à la soutenance. Une version synthétique en annexe est appréciée, surtout si vos décisions ont été nombreuses ou discutables : elle transforme une zone d’ombre potentielle en preuve de rigueur.

    Quelle différence avec un carnet de bord de recherche ?

    Le carnet de bord couvre l’ensemble du processus : lectures, hypothèses successives, impressions de terrain, échanges avec le directeur. Le journal d’analyse est plus étroit et plus formel : uniquement les décisions de traitement des données, chacune datée, motivée et accompagnée de son effet. Les deux se complètent ; le second est celui que le jury interrogera.

    Est-il trop tard si mes analyses sont déjà terminées ?

    Non, et cela vaut vraiment la peine. Reconstituez-le à partir de vos fichiers, de leurs dates de modification, de vos syntaxes enregistrées et de vos échanges avec votre directeur. La reconstitution est moins fiable qu’une tenue au fil de l’eau — et il faut être honnête sur les points dont vous n’êtes plus certain — mais elle vaut infiniment mieux que l’absence de traçabilité. Comptez deux heures pour un mémoire quantitatif ordinaire.

    Le jury peut-il exiger de voir mes fichiers de données ?

    C’est rare en master, mais un directeur peut parfaitement demander à voir un fichier ou une syntaxe, en particulier si un résultat le surprend. Conservez donc une version intacte de vos données brutes, distincte de vos fichiers de travail, ainsi que la trace de vos commandes. Vérifiez par ailleurs ce que votre engagement de confidentialité et votre information des participants vous autorisent à conserver et à montrer, et pour combien de temps.

    Faut-il consigner les analyses qui n’ont rien donné ?

    Oui, et ce sont les entrées les plus précieuses. Elles vous protègent de deux façons : elles vous permettent de répondre sans hésiter si on vous demande si vous avez envisagé une autre spécification, et elles vous évitent de refaire six semaines plus tard une analyse que vous aviez déjà écartée pour une bonne raison — que vous aurez oubliée.

  • Annuaire 2026 : la phrase à écrire pour chaque test statistique

    Annuaire 2026 : la phrase à écrire pour chaque test statistique

    Le test a tourné. Le tableau est à l’écran. Et vous êtes bloqué sur une chose qu’aucun cours de statistiques n’enseigne : comment écrit-on cela en français dans le chapitre résultats ?

    Cet annuaire donne un modèle de phrase par test, avec les valeurs à remplacer. Les chiffres qui suivent sont des exemples : remplacez-les par les vôtres, gardez la structure.

    Les trois éléments qu’aucune phrase ne peut omettre

    Quel que soit le test, une phrase de résultat complète contient toujours :

    1. la statistique du test et ses degrés de libertét(118), F(2, 147), χ²(3) ;
    2. la valeur de p, exacte de préférence ;
    3. une taille d’effet, qui dit de combien plutôt que de dire seulement « oui ».

    Le troisième est celui qu’on oublie, et c’est le plus reproché. Un résultat significatif sans taille d’effet ne permet pas de savoir si l’écart observé compte dans la réalité. Notre guide indique quelle mesure de taille d’effet accompagne quel test.

    À cela s’ajoute un quatrième élément, non chiffré et tout aussi obligatoire : le sens du résultat en langage ordinaire. Une phrase qui se termine sur une parenthèse statistique laisse au lecteur le soin de deviner qui a le score le plus élevé. Dites-le.

    Phrase modèle dont trois emplacements obligatoires sont mis en évidence
    Statistique et degrés de liberté, valeur de p, taille d’effet : trois emplacements, aucun facultatif.

    Comparer deux groupes

    Test t pour échantillons indépendants

    « Les étudiants en alternance obtiennent une moyenne significativement plus élevée (M = 14,2 ; ET = 2,1) que les étudiants en formation initiale (M = 13,1 ; ET = 2,4), t(118) = 2,61 ; p = 0,010 ; d de Cohen = 0,48. »

    Si les variances sont inégales, ajoutez la mention de la correction et notez que les degrés de liberté deviennent décimaux : « les variances étant inégales (Levene : p = 0,02), la correction de Welch a été appliquée, t(104,3) = 2,44 ; p = 0,016 ».

    Mann-Whitney

    « La distribution des scores diffère significativement entre les deux groupes (U = 1 204 ; z = −2,38 ; p = 0,017 ; r = 0,22), les scores médians étant plus élevés dans le groupe expérimental (Mdn = 15) que dans le groupe témoin (Mdn = 13). »

    Notez le vocabulaire : on parle de médianes et de distributions, pas de moyennes. Le choix entre test t et Mann-Whitney se justifie une seule fois, en méthodologie, pas à chaque résultat.

    Test t pour échantillons appariés

    « Le score moyen augmente significativement entre le pré-test (M = 11,8 ; ET = 2,0) et le post-test (M = 13,4 ; ET = 2,2), t(59) = 5,12 ; p < 0,001 ; d = 0,66. »

    Comparer trois groupes ou plus

    ANOVA à un facteur

    « L’analyse de variance révèle un effet significatif du service d’affectation sur la satisfaction, F(2, 147) = 6,84 ; p = 0,001 ; η²p = 0,085. Les comparaisons post hoc de Tukey indiquent que le service A (M = 4,1) obtient un score supérieur au service C (M = 3,4 ; p = 0,001), les autres écarts n’atteignant pas le seuil. »

    La phrase de l’ANOVA seule ne suffit jamais : elle dit qu’au moins deux groupes diffèrent, sans dire lesquels. Le post hoc fait partie du résultat.

    ANOVA à mesures répétées

    « L’hypothèse de sphéricité étant rejetée (Mauchly : p = 0,004), la correction de Greenhouse-Geisser a été appliquée. L’effet du temps est significatif, F(1,72 ; 101,4) = 9,03 ; p < 0,001 ; η²p = 0,133. »

    Les degrés de liberté décimaux sont le signe visible de la correction : c’est ce que le lecteur averti vérifie, comme le détaille notre guide de l’ANOVA à mesures répétées.

    Kruskal-Wallis

    « Le test de Kruskal-Wallis met en évidence une différence significative entre les trois services (H(2) = 11,42 ; p = 0,003). Les comparaisons deux à deux avec ajustement de Bonferroni situent la différence entre les services A et C (p = 0,002). »

    Si l’inégalité des variances vous a conduit à un test de repli plutôt qu’à l’ANOVA classique, dites-le une fois dans la méthodologie et n’y revenez pas.

    Un tableau de résultats transformé en paragraphe rédigé
    Le tableau montre, la phrase dit. Un chapitre résultats a besoin des deux.

    Variables catégorielles

    Khi-deux d’indépendance

    « Il existe une association significative entre le statut d’emploi et le fait d’avoir suivi la formation, χ²(2, N = 240) = 9,71 ; p = 0,008 ; V de Cramér = 0,20. Les salariés en contrat permanent sont proportionnellement plus nombreux à l’avoir suivie (62 % contre 41 %). »

    Deux détails souvent manqués : l’effectif N se place dans la parenthèse des degrés de liberté, et la phrase doit préciser le sens de l’association, ce que le khi-deux à lui seul ne dit pas.

    Relations entre variables continues

    Corrélation

    « La satisfaction au travail est positivement et modérément corrélée à l’autonomie perçue, r(148) = 0,42 ; p < 0,001. »

    Pour une corrélation de rangs : « rs(148) = 0,38 ; p < 0,001 ». Le coefficient est lui-même une taille d’effet : rien à ajouter. Le choix entre Pearson et Spearman se justifie en méthodologie.

    Régression linéaire multiple

    « Le modèle explique une part significative de la variance de la performance, = 0,31 ; ajusté = 0,29 ; F(3, 146) = 21,84 ; p < 0,001. L’autonomie perçue en est le prédicteur le plus fort (β = 0,38 ; t = 5,02 ; p < 0,001), suivie de l’ancienneté (β = 0,19 ; p = 0,014), tandis que l’âge n’apporte pas de contribution significative (β = 0,06 ; p = 0,42). »

    Rapportez le modèle d’ensemble avant les coefficients, jamais l’inverse. Les vérifications préalables — normalité des résidus, homoscédasticité, absence de multicolinéarité — se mentionnent en une phrase juste avant, comme le détaille notre guide de la régression linéaire multiple.

    Modération

    « L’introduction du terme d’interaction améliore significativement le modèle (Δ = 0,04 ; F(1, 212) = 9,87 ; p = 0,002 ; β = −0,21). L’analyse des pentes simples montre que l’effet du stress est significatif à faible soutien social (B = 0,48 ; p < 0,001) et non significatif à soutien élevé (B = 0,06 ; p = 0,52). »

    Une modération ne se rapporte jamais sans sa décomposition : le terme d’interaction seul ne dit pas dans quel sens l’effet varie.

    Les phrases qui entourent les résultats

    Vérification des conditions : « La normalité des distributions a été examinée par le test de Shapiro-Wilk et l’inspection des graphiques ; l’égalité des variances a été vérifiée par le test de Levene. » Une seule phrase, en tête du chapitre, plutôt que répétée à chaque test.

    Résultat non significatif : « La différence entre les deux groupes n’atteint pas le seuil de significativité (t(96) = 1,21 ; p = 0,23 ; d = 0,24). » Écrivez « n’est pas significative », jamais « il n’y a pas de différence » : l’absence de preuve n’est pas une preuve d’absence.

    Effectif et données écartées : « L’analyse porte sur 148 questionnaires exploitables sur les 162 recueillis, quatorze ayant été écartés pour non-réponse partielle. » Ce nombre doit correspondre exactement à celui annoncé en méthodologie.

    Les conventions typographiques françaises

    • Virgule décimale, pas point : p = 0,03 et non p = .03.
    • Symboles en italique : M, ET, t, F, p, r, N. Les indices et les noms propres restent droits.
    • Espace insécable avant les deux-points et le point-virgule, et dans les grands nombres : 1 204.
    • Jamais p = 0,000, que certains logiciels affichent par arrondi. Écrivez p < 0,001.
    • Valeur exacte de préférence : p = 0,03 est plus informatif que p < 0,05.
    • Cohérence du nombre de décimales : deux pour les moyennes et les coefficients, trois pour les valeurs de p.

    La frontière avec la discussion

    Le chapitre résultats traduit, il ne discute pas. « Les femmes déclarent un niveau de stress supérieur » appartient aux résultats. « Ce qui pourrait s’expliquer par la double charge domestique » appartient à la discussion. Les faits d’un côté, le pourquoi de l’autre.

    Un test réussi ne dispense pas non plus de prudence causale : sauf plan expérimental ou stratégie d’identification explicite, écrivez est associé à et non cause.

    Deux compagnons de cet annuaire : l’annuaire des conditions statistiques et de leurs plans de secours, pour savoir quel test employer quand une condition tombe, et le plan d’analyse à écrire avant la collecte, pour décider tout cela en amont.

    Du modèle à votre texte

    Ces phrases sont des gabarits, pas un chapitre. Un bon chapitre résultats les enchaîne dans un ordre qui suit vos hypothèses, avec des transitions, un rappel de ce que chaque test devait trancher, et une progression lisible pour un lecteur qui n’a pas vos données sous les yeux.

    Tesify vous accompagne sur ce passage : organiser le chapitre résultats hypothèse par hypothèse, maintenir une terminologie cohérente avec votre méthodologie, et transformer une série de sorties logicielles en texte académique continu. Vos données et vos analyses restent les vôtres.

    Rédiger votre chapitre résultats avec Tesify

    Questions fréquentes

    Faut-il répéter les valeurs du tableau dans le texte ?

    Non, et c’est une erreur fréquente. Le texte commente les résultats saillants et renvoie au tableau pour le détail ; recopier l’intégralité du tableau en prose double la longueur du chapitre sans rien ajouter. La règle pratique : si un chiffre figure déjà dans un tableau, ne le reprenez dans le texte que s’il porte une conclusion.

    Combien de décimales faut-il donner ?

    Deux pour les moyennes, écarts-types et coefficients ; trois pour les valeurs de p. Au-delà, vous affichez une précision que vos données n’ont pas. L’essentiel est la cohérence : le même nombre de décimales pour le même type de quantité dans tout le mémoire.

    Faut-il rapporter les tests de conditions dans le chapitre résultats ?

    Une phrase suffit, en ouverture du chapitre, pour dire quelles vérifications ont été conduites. Le détail chiffré de chaque test de normalité et d’homogénéité alourdit inutilement le texte et se place mieux en annexe. Ce qui doit apparaître dans le corps, en revanche, c’est toute décision qui a changé le test employé.

    Peut-on écrire « la différence est très significative » ?

    Mieux vaut l’éviter. La significativité n’est pas graduelle : un résultat l’est ou ne l’est pas au seuil retenu. Ce qui est graduel, c’est la taille de l’effet — et c’est elle qu’il faut qualifier de faible, modérée ou forte. Écrivez « la différence est significative et d’ampleur modérée », pas « très significative ».

    Dans quel ordre présenter les résultats ?

    Dans l’ordre de vos hypothèses, systématiquement. Commencez par une description de l’échantillon et des variables, puis traitez H1, H2, H3 dans l’ordre où elles ont été énoncées au cadre théorique. Un lecteur doit pouvoir passer du chapitre théorique au chapitre résultats sans jamais chercher où est passée une hypothèse.

  • Vous venez d’une formation littéraire et votre mémoire exige des statistiques (2026)

    Vous venez d’une formation littéraire et votre mémoire exige des statistiques (2026)

    Vous avez choisi les lettres, l’histoire, les sciences de l’éducation ou le droit — au moins en partie parce que les mathématiques n’y occupaient plus le premier rang. Et voilà que votre mémoire de master repose sur un questionnaire de 180 répondants, que votre directeur parle de « tester vos hypothèses », et que quelqu’un a prononcé le mot ANOVA.

    Vous n’êtes pas une exception. Vous êtes la majorité : à la rentrée 2024, 40,8 % des étudiants inscrits en diplôme de master relèvent des lettres, langues et sciences humaines, et 33,0 % du droit, des sciences économiques et de l’AES — près de trois masterants sur quatre. Ce sont précisément les disciplines où l’enquête par questionnaire est reine et où la formation statistique initiale est la plus légère.

    Voici ce dont vous avez réellement besoin, et surtout ce dont vous n’avez pas besoin.

    Vous n’avez pas à devenir statisticien

    C’est le malentendu qui fait perdre le plus de temps. Personne n’attend de vous que vous démontriez un théorème, que vous compreniez pourquoi une distribution converge, ou que vous sachiez d’où sort la formule d’un écart-type.

    Aucun calcul ne se fait à la main dans un mémoire de master. Le logiciel calcule. Ce qu’on vous demande est d’un autre ordre, et c’est de la logique, pas de l’arithmétique : savoir quel outil répond à quelle question, savoir ce qu’il suppose, et savoir ce que son résultat autorise à conclure.

    Autrement dit, exactement le type de raisonnement qu’une formation littéraire entraîne très bien.

    Six tuiles représentant les compétences statistiques réellement nécessaires
    Six compétences suffisent à un mémoire de master. Le reste est du confort.

    Les six compétences qui suffisent

    1. Savoir de quel type est chacune de vos variables

    Continue, ordinale ou catégorielle. Rien de plus. Ce classement détermine à lui seul quels tests sont possibles, et c’est la compétence la plus rentable de la liste : la majorité des impasses de fin de mémoire viennent d’une variable mesurée dans un format qui interdit l’analyse prévue.

    2. Savoir associer une question à un test

    Comparer deux groupes, comparer trois groupes ou plus, mesurer un lien entre deux variables continues, croiser deux variables catégorielles, prédire une variable à partir de plusieurs autres. Cinq familles de questions, cinq familles de tests. Vous n’avez pas à connaître les vingt tests existants : vous avez à savoir dans quelle famille vous êtes.

    3. Savoir lire trois nombres dans une sortie

    Une sortie logicielle affiche des dizaines de valeurs, et trois suffisent presque toujours : la statistique du test, la valeur de p, et une mesure de la taille d’effet. Apprenez à les localiser dans le tableau que votre logiciel produit, et l’essentiel est acquis.

    4. Savoir quoi faire quand une condition n’est pas remplie

    C’est la compétence qui distingue un mémoire solide d’un mémoire fragile — et la seule qui demande un peu d’anticipation. Les tests supposent des conditions : normalité, égalité des variances, indépendance. Elles ne seront pas toutes remplies, et ce n’est pas un problème tant que vous savez vers quoi basculer. Notre annuaire des conditions et de leurs plans de secours est conçu pour être gardé ouvert à côté de vous.

    5. Savoir écrire la phrase

    Un résultat n’existe pas tant qu’il n’est pas rédigé. La forme est conventionnelle, donc apprenable une fois pour toutes : notre annuaire des phrases à écrire pour chaque test donne un gabarit par situation. C’est la partie où votre formation vous avantage nettement.

    6. Savoir dire ce que vous ne pouvez pas conclure

    Sous-estimée, et pourtant très valorisée en soutenance. Distinguer une association d’une causalité, reconnaître qu’un résultat non significatif n’est pas une preuve d’absence, énoncer les limites de son échantillon : rien de tout cela n’est mathématique. C’est de l’honnêteté intellectuelle, et un jury la repère immédiatement.

    Les trois réflexes à abandonner tout de suite

    Vouloir comprendre les formules avant de commencer. C’est la façon la plus efficace de perdre trois semaines. On apprend à lire une sortie logicielle en la lisant, pas en remontant à sa dérivation mathématique. Commencez par une analyse réelle sur vos propres données ; la compréhension viendra par l’usage.

    Lancer des tests « pour voir ». Cliquer partout jusqu’à trouver une étoile de significativité produit mécaniquement des faux positifs, et cela se voit dans un mémoire — parce que les analyses présentées ne correspondent plus aux hypothèses annoncées. Décidez avant, avec un plan d’analyse écrit avant la collecte.

    Déléguer entièrement à quelqu’un d’autre. Compréhensible, et risqué : vous devrez défendre chaque choix en soutenance, et la question « pourquoi ce test-là ? » arrive toujours. Faire relire ses résultats par quelqu’un de compétent est en revanche une excellente idée — à condition d’avoir conduit les analyses soi-même.

    Grille de tableur propre avec une ligne d'en-tête et une colonne d'identifiants distinguées
    La moitié des blocages n’ont rien de statistique : ce sont des fichiers mal construits.

    Le fichier de départ : cinq règles de saisie

    Voici la partie dont personne ne parle et qui coûte le plus de temps. Un logiciel de statistiques n’analyse pas un tableau mis en forme pour être lu par un humain ; il attend une structure précise.

    1. Une ligne = un individu, une colonne = une variable. Jamais de sous-tableaux, jamais de cellules fusionnées, jamais de lignes de titre au milieu du fichier. Si vous avez mesuré la même personne à trois moments, cela fait trois colonnes, pas trois lignes.
    2. Une seule ligne d’en-tête, en haut, avec des noms de colonnes courts, sans espaces ni accents : age, sexe, satisf_1, satisf_2.
    3. Une colonne d’identifiant en première position, avec un numéro unique par répondant. C’est elle qui vous permettra de retrouver un questionnaire papier lorsqu’une valeur paraîtra suspecte — le geste central du traitement des valeurs aberrantes.
    4. Coder les réponses en chiffres, et tenir un dictionnaire des codes à côté : 1 = femme, 2 = homme, 3 = autre. Ne mélangez jamais du texte et des nombres dans une même colonne, y compris pour un « NSP ».
    5. Laisser une cellule vide pour une non-réponse. Surtout pas un zéro, qui serait lu comme une valeur réelle, ni un tiret, qui transformerait la colonne en texte. La distinction entre vide et zéro conditionne tout le traitement des données manquantes.

    Une heure passée à construire le fichier correctement en économise dix par la suite. Si vos données viennent d’un formulaire en ligne, l’export est généralement déjà dans ce format : ne le « rangez » pas.

    Choisir un logiciel qui ne vous combatte pas

    La règle d’or : utilisez ce que votre département enseigne, parce que c’est ce sur quoi on pourra vous dépanner à 23 heures la veille d’un rendu. Un outil moins pratique mais soutenu vaut mieux qu’un outil idéal utilisé seul.

    À défaut de consigne, privilégiez une interface graphique. JASP et jamovi sont gratuits, se pilotent à la souris, affichent les résultats déjà mis en forme, et donnent exactement les mêmes valeurs que les logiciels payants. Un langage de programmation est un excellent investissement si vous poursuivez en recherche, et un détour coûteux si votre horizon est la soutenance de juin.

    Dans tous les cas, indiquez le logiciel et sa version dans votre méthodologie : c’est attendu, et c’est une ligne.

    Un calendrier réaliste

    Les proportions surprennent souvent, et c’est précisément pour cela qu’il faut les connaître :

    • Préparer le fichier : environ une semaine. Presque toujours sous-estimé.
    • Lancer les analyses : deux à trois jours. Presque toujours surestimé — une fois le plan d’analyse écrit et le fichier propre, la manipulation est rapide.
    • Rédiger le chapitre résultats : une à deux semaines.
    • Rédiger la discussion : au moins autant.

    Autrement dit, la statistique proprement dite occupe une fraction minime du temps total. Ce qui prend du temps, c’est ce qui l’entoure : préparer, puis écrire. Et l’écriture est votre terrain.

    Une remarque sur la taille de l’échantillon, puisqu’elle inquiète : mieux vaut la calculer avant de collecter, avec un calcul de puissance, que la subir après. Et si votre échantillon reste modeste, ce n’est pas une faute — c’est une limite à énoncer. Ce que les jurys sanctionnent n’est jamais un petit échantillon, c’est un petit échantillon présenté comme s’il permettait de généraliser.

    Votre avantage réel

    Terminons par ce que personne ne vous dira. Un mémoire quantitatif n’est pas jugé sur la sophistication de ses tests. Il est jugé sur la qualité de son raisonnement : la façon dont la question de recherche devient une hypothèse, dont l’hypothèse devient une mesure, et dont le résultat est interprété avec la prudence qui convient.

    Un étudiant issu d’une formation littéraire qui applique correctement un test t et l’écrit avec rigueur rendra un meilleur mémoire qu’un étudiant qui empile des modèles sophistiqués sans savoir ce qu’ils supposent. La partie difficile de votre mémoire n’est pas celle que vous redoutez.

    Tesify vous accompagne sur cette partie-là : structurer le chapitre méthodologie et le chapitre résultats, transformer une sortie logicielle en paragraphe académique, et maintenir une terminologie cohérente entre vos hypothèses, vos analyses et votre discussion. Vos données et vos analyses restent les vôtres, et le texte est écrit à 100 % par vous.

    Rédiger votre mémoire quantitatif avec Tesify

    Questions fréquentes

    Faut-il être bon en mathématiques pour faire un mémoire quantitatif ?

    Non. Aucun calcul ne se fait à la main : le logiciel s’en charge intégralement. Ce qui est évalué relève de la logique — quel test répond à quelle question, quelles conditions il suppose, ce que son résultat permet de conclure. Beaucoup d’étudiants excellents en mathématiques rendent des mémoires quantitatifs médiocres parce qu’ils négligent précisément cette couche de raisonnement.

    Mon directeur ne connaît pas les statistiques : comment faire ?

    C’est fréquent en sciences humaines, et gérable. Cherchez une seconde ressource : un enseignant de méthodologie de votre département, la bibliothèque universitaire qui propose souvent des ateliers, ou un doctorant de votre laboratoire. Présentez votre plan d’analyse sur une page plutôt que votre mémoire entier : c’est un format qu’on peut relire en dix minutes, et vous obtiendrez beaucoup plus facilement un avis.

    Puis-je faire un mémoire mixte, à la fois qualitatif et quantitatif ?

    Oui, et c’est souvent pertinent en sciences humaines. Attention toutefois au volume : une approche mixte demande de mener deux collectes et deux analyses dans le même temps imparti. En master, mieux vaut un volet quantitatif modeste mais bien conduit, complété par quelques entretiens, qu’une ambition double mal terminée.

    Que faire si je découvre en cours de route que mes données ne permettent pas mon analyse ?

    Ne le cachez pas : documentez-le. Écrivez ce qui était prévu, pourquoi cela n’a pas été possible, et ce que vous avez fait à la place. Ce paragraphe démontre exactement la lucidité méthodologique attendue à ce niveau. Ce qui est sanctionné, c’est le silence sur un changement de plan, jamais le changement lui-même.

    Combien de tests faut-il pour un mémoire de master ?

    Aussi peu que votre problématique en exige — souvent trois à cinq, un par hypothèse. Multiplier les analyses ne renforce pas un mémoire : cela dilue le propos et augmente le risque de résultats significatifs par hasard. Trois tests bien choisis, bien conduits et bien rédigés valent mieux que quinze tableaux dont personne ne saisit l’articulation.

  • Le plan d’analyse statistique : choisir vos tests avant d’avoir vos données (2026)

    Le plan d’analyse statistique : choisir vos tests avant d’avoir vos données (2026)

    La question arrive toujours dans le même ordre, et c’est le mauvais : « j’ai récupéré mes 200 réponses, maintenant quel test dois-je utiliser ? »

    Posée à ce moment-là, elle est déjà trop tard. Il arrive qu’aucun test ne convienne — parce que la variable a été mesurée sur trois modalités là où il en fallait une continue, parce que les groupes sont trop déséquilibrés, parce que la question n’a pas été posée à ceux qu’il fallait. À ce stade, la collecte est close et rien ne se rattrape.

    Le remède tient en une à deux pages écrites avant la collecte : le plan d’analyse statistique. Il ne demande pas de compétences supplémentaires, et il se recycle presque tel quel en sous-section de votre chapitre méthodologie.

    Pourquoi l’ordre change tout

    Deux raisons, l’une pratique, l’autre méthodologique.

    La raison pratique. Écrire « pour tester H2, je comparerai la moyenne de satisfaction entre les trois services » oblige immédiatement à vérifier que votre questionnaire produira bien une variable de satisfaction continue et une variable de service à trois modalités, avec assez de répondants dans chacune. Ce contrôle prend dix minutes tant que le questionnaire est modifiable, et devient impossible une fois qu’il est diffusé.

    La raison méthodologique. Un même jeu de données autorise énormément d’analyses différentes : plusieurs découpages de groupes, plusieurs variables de résultat, avec ou sans les cas atypiques. En explorant assez longtemps, on finit statistiquement par trouver quelque chose de significatif — même quand il n’y a rien. Fixer les analyses à l’avance supprime ce risque à la racine, et c’est une garantie que vous pouvez revendiquer en soutenance.

    Rien de tout cela n’interdit l’exploration. Cela impose seulement de la nommer : les analyses du plan sont confirmatoires, les autres sont exploratoires et se présentent comme telles.

    Frise chronologique où la décision est verrouillée avant l'arrivée des données
    La valeur du plan vient uniquement de sa date : après coup, ce n’est plus qu’une description.

    Les six lignes d’un plan d’analyse

    1. Vos variables et leur niveau de mesure

    Listez chaque variable qui interviendra dans une hypothèse, en précisant si elle est continue, ordinale ou catégorielle, et combien de modalités elle comporte. C’est fastidieux et c’est l’étape la plus rentable : le niveau de mesure détermine à lui seul la famille de tests disponibles. La plupart des impasses de fin de mémoire viennent d’une variable mesurée dans un format qui interdit l’analyse prévue.

    2. Une hypothèse, un test

    Pour chaque hypothèse issue de votre cadre théorique, nommez le test qui la tranchera. La discipline est simple : si une hypothèse n’a pas de test en face, elle n’est pas testable telle qu’elle est formulée et doit être reformulée. C’est le meilleur contrôle de qualité qui existe sur une série d’hypothèses de recherche, et il ne coûte rien.

    3. Les conditions à vérifier, et le plan de secours

    C’est la colonne que personne n’écrit, et celle qui sauve les mémoires. Chaque test paramétrique repose sur des conditions — normalité, égalité des variances, indépendance, linéarité — qui ne seront pas toutes remplies. Ce n’est pas une éventualité, c’est la situation ordinaire.

    Décidez donc à l’avance de ce que vous ferez : quel test de repli, quelle correction, quelle transformation. « Si la normalité est rejetée, je passe au test non paramétrique correspondant » est une phrase qui vaut des points en soutenance parce qu’elle prouve que la décision n’a pas été prise en fonction du résultat. Notre annuaire des conditions statistiques et de leurs plans de secours est fait pour être recopié dans cette colonne.

    Tableau associant chaque hypothèse de recherche au test statistique correspondant
    Le cœur du plan tient dans un tableau : une ligne par hypothèse, une colonne pour le repli.

    4. Le traitement des données imparfaites

    Deux décisions, à prendre avant de voir les données parce qu’elles influencent directement les résultats :

    • Les données manquantes. Quelle proportion de non-réponse rend un questionnaire inexploitable ? Écartez-vous le questionnaire entier ou seulement l’analyse concernée ? La distinction entre les mécanismes de données manquantes détermine ce qui est légitime.
    • Les valeurs extrêmes. Quel critère de repérage, et quelle règle de décision ? Fixer à l’avance qu’on ne supprime que les valeurs impossibles rend impossible la tentation d’écarter une observation gênante une fois le résultat connu.

    5. Le seuil, les tests multiples, la taille d’effet

    Annoncez le seuil de significativité retenu et précisez si vos tests sont uni ou bilatéraux. Si vous prévoyez de nombreuses comparaisons, dites comment vous en tiendrez compte plutôt que d’accumuler les tests en silence.

    Surtout, engagez-vous à rapporter une taille d’effet à côté de chaque p. C’est aujourd’hui attendu dans la plupart des disciplines, et cela vous protège de la conclusion la plus faible qui soit : « c’est significatif », sans jamais dire de combien.

    6. Le logiciel et sa version

    Une ligne, souvent oubliée, et systématiquement attendue dans la méthodologie. Nommez l’outil et sa version. Le choix n’a aucune incidence sur la validité de vos résultats ; son absence, en revanche, est une lacune facile à éviter.

    La forme : un tableau, pas un chapitre

    L’essentiel du plan tient dans un tableau d’une page, avec une ligne par hypothèse et cinq colonnes : l’hypothèse, les variables concernées avec leur niveau de mesure, le test prévu, les conditions à vérifier, le test de repli.

    Ajoutez autour trois courts paragraphes — préparation des données, seuil et tailles d’effet, logiciel — et votre plan est complet. Ce format a un avantage décisif : il se lit en dix minutes. C’est ce qui le rend utile en rendez-vous d’encadrement, là où un texte de six pages ne serait jamais relu.

    Vous avez déjà collecté ? Faites-le quand même

    Situation très fréquente, et la réponse n’est pas « tant pis ». Écrivez le plan avant d’ouvrir votre fichier de données, ou du moins avant de lancer le moindre test. Vous perdez la garantie d’antériorité, mais vous conservez l’essentiel : des décisions prises sur des critères plutôt qu’en fonction des p-valeurs obtenues.

    Datez le document, mentionnez qu’il a été rédigé après la collecte, et tenez-vous-y. Un mémoire qui assume cet ordre est plus solide qu’un mémoire qui prétend l’inverse.

    Et si vous n’avez pas encore collecté, une dernière étape s’impose logiquement à cet endroit : une fois les tests choisis, vous savez exactement quoi entrer dans un calcul de taille d’échantillon. C’est même la seule façon de le faire correctement, puisque le calcul dépend du test retenu.

    Écrire le plan, puis le chapitre

    Le plan d’analyse est un document de travail ; la sous-section « analyses statistiques » de votre mémoire en est la version rédigée, au passé et en prose continue. Le passage de l’un à l’autre est mécanique, et c’est exactement le genre de réécriture qui prend un après-midi de trop.

    Tesify vous accompagne sur ce trajet : transformer votre tableau de décisions en paragraphes académiques, articuler cette sous-section avec le reste de votre méthodologie, et maintenir une terminologie cohérente entre les hypothèses, la méthode et les résultats. Vos données et vos analyses restent les vôtres.

    Rédiger votre méthodologie quantitative avec Tesify

    Questions fréquentes

    Quelle longueur doit faire un plan d’analyse statistique ?

    Une à deux pages suffisent largement pour un mémoire de master, et l’essentiel tient souvent dans un seul tableau. Ce n’est pas un chapitre supplémentaire à rédiger : c’est un document de travail, qui deviendra ensuite quelques paragraphes de votre méthodologie. Si votre plan dépasse trois pages, vous êtes probablement en train d’écrire le chapitre au lieu de préparer les décisions.

    Puis-je changer de test après avoir vu mes données ?

    Oui — quand une condition d’application n’est pas remplie. C’est précisément ce que prévoit la colonne « plan de secours », et personne ne vous le reprochera. Ce qui n’est pas légitime, c’est de changer de test parce que le premier ne donnait pas le résultat espéré. La différence tient entièrement à la raison invoquée, et c’est pourquoi cette raison doit être écrite.

    Que faire si mon directeur ne me l’a pas demandé ?

    Faites-le quand même, et apportez-le au rendez-vous suivant. Un tableau d’une page se relit en dix minutes, alors qu’un chapitre méthodologie complet attend souvent des semaines. C’est le format qui permet à votre directeur de repérer une hypothèse mal opérationnalisée ou un test inadapté à un moment où tout reste modifiable — c’est-à-dire au seul moment où son avis peut vraiment vous servir.

    Faut-il un plan d’analyse pour un mémoire qualitatif ?

    L’équivalent existe, sous une autre forme : préciser la méthode d’analyse retenue, le mode de codage, qui code, comment les désaccords sont tranchés, et à quel moment vous considérerez le corpus suffisant. La logique est identique — fixer les règles avant de connaître les résultats — même si les objets sont différents.

    Faut-il inclure le plan d’analyse dans le mémoire final ?

    Pas sous sa forme de tableau de travail. Il se fond dans la sous-section « analyses statistiques » du chapitre méthodologie, rédigée en prose et au passé. Certains le placent aussi en annexe lorsqu’il est détaillé, ce qui est apprécié dans les disciplines de santé, mais ce n’est pas une attente générale en master.

    Mon plan prévoyait un test qui s’est révélé impossible : est-ce grave ?

    Non, à condition de le dire. Écrivez ce qui était prévu, pourquoi cela n’a pas pu être fait — effectif insuffisant dans un groupe, variable finalement trop peu variable — et ce que vous avez fait à la place. Ce paragraphe de trois lignes vaut mieux qu’un silence, et il démontre exactement la maîtrise méthodologique que le jury cherche à évaluer.

  • 765 895 ou 342 554 étudiants en master ? Ce que les chiffres officiels comptent vraiment (2026)

    765 895 ou 342 554 étudiants en master ? Ce que les chiffres officiels comptent vraiment (2026)

    Combien d’étudiants préparent un master en France ? La question paraît simple, la base de données officielle est ouverte, et pourtant deux réponses également défendables en sortent.

    765 895 si vous comptez les inscrits en cursus master. 342 554 si vous comptez les inscrits en diplôme de master. Un facteur de plus de deux, sur la même base, la même année, sans la moindre erreur de manipulation.

    Et ce n’est pas le plus troublant : selon le filtre retenu, la première discipline change. C’est la Santé dans un cas, les Lettres et sciences humaines dans l’autre. Voici les chiffres de la rentrée 2024, d’où vient l’écart, et ce que cet écart apprend à quiconque doit citer une statistique publique dans un mémoire.

    La source et son périmètre

    Les chiffres proviennent du système d’information SISE, publié en données ouvertes par le ministère de l’enseignement supérieur. Le jeu de données recense les effectifs d’étudiants inscrits dans les établissements publics sous tutelle du ministère, ventilés par établissement, cursus, diplôme, discipline, sexe et origine géographique.

    Un périmètre à retenir avant de citer quoi que ce soit : cette base n’inclut pas l’enseignement privé, les écoles de commerce, ni les établissements relevant d’autres ministères — enseignement agricole, formations paramédicales, écoles d’art relevant de la Culture. Toute phrase du type « en France, X étudiants… » construite sur cette base est donc, en toute rigueur, une phrase sur le supérieur public sous tutelle du ministère.

    Toutes formations confondues, cette base comptait 1 940 430 inscrits à la rentrée 2024, en hausse par rapport aux 1 900 016 de 2023.

    Entonnoir muni de plusieurs filtres réduisant progressivement un flux de données
    Aucun de ces deux chiffres n’est faux. Ils ne répondent simplement pas à la même question.

    Pourquoi 765 895 n’est pas 342 554

    Le second cycle, appelé « cursus M » dans la nomenclature, est défini par un niveau d’études, pas par un diplôme. Y sont donc rangés tous les étudiants qui se situent après la licence, quel que soit le diplôme qu’ils préparent.

    La décomposition de ces 765 895 inscrits est éloquente :

    • 342 554 préparent un diplôme de master ;
    • 175 538 sont en formations de santé — les années avancées de médecine, pharmacie, odontologie, maïeutique ;
    • 101 248 relèvent d’autres formations ;
    • 99 078 sont en formations d’ingénieurs ;
    • 19 522 sont en instituts d’études politiques ;
    • le solde se répartit entre diplômes inter-universitaires, préparations aux concours de l’enseignement, diplômes d’ENS et divers diplômes conférant le grade de master.

    Un étudiant de cinquième année de médecine est donc, statistiquement, un étudiant « en cursus master ». Il ne prépare pourtant pas un master et n’écrira pas de mémoire de master. Le mot est le même, la réalité ne l’est pas.

    La première discipline dépend du filtre

    C’est ici que l’écart cesse d’être une curiosité comptable pour devenir un problème d’interprétation.

    En cursus master, la hiérarchie des grandes disciplines à la rentrée 2024 est la suivante :

    • Santé — 217 776 (28,4 %)
    • Sciences et sciences de l’ingénieur — 203 905 (26,6 %)
    • Droit, sciences économiques, AES — 170 615 (22,3 %)
    • Lettres, langues et sciences humaines — 164 594 (21,5 %)
    • STAPS — 6 899 (0,9 %)

    En diplôme de master, la même base, la même année, donne un classement méconnaissable :

    • Lettres, langues et sciences humaines — 139 751 (40,8 %)
    • Droit, sciences économiques, AES — 113 161 (33,0 %)
    • Sciences et sciences de l’ingénieur — 83 341 (24,3 %)
    • STAPS — 6 155 (1,8 %)
    • Théologie — 146

    La Santé, première discipline dans la première lecture, disparaît entièrement de la seconde : dans cette base, aucun effectif ne combine la grande discipline « Santé » et le diplôme « master ». Les 217 776 étudiants de santé du cursus M sont classés en formations de santé, et les masters à contenu sanitaire — santé publique, ingénierie de la santé — sont rattachés à d’autres grandes disciplines.

    Résultat : selon le filtre, on peut écrire en toute bonne foi que la première discipline du second cycle français est la santé, ou que c’est les lettres et sciences humaines. Les deux phrases sont exactes. Une seule répond à la question que la plupart des lecteurs croient poser.

    Un total décomposé en cinq parts inégales, la plus grande mise en évidence
    Décomposer un total est le contrôle le plus rentable qu’on puisse faire sur une statistique publique.

    Ce que dit vraiment la population des masterants

    Si l’on s’en tient au diplôme de master — la population qui, elle, rédigera bien un mémoire —, un fait domine : près de trois masterants sur quatre relèvent des sciences humaines, du droit ou de l’économie. Les deux blocs cumulent 252 912 inscrits, soit 73,8 % du total, contre 24,3 % pour l’ensemble sciences et ingénierie.

    C’est une donnée structurante pour comprendre les difficultés méthodologiques les plus répandues. La majorité des mémoires de master français sont écrits par des étudiants dont la formation initiale comporte peu de statistiques, alors même que leurs disciplines — psychologie, sciences de l’éducation, sciences de gestion, sociologie — recourent massivement aux enquêtes par questionnaire et aux tests d’hypothèses.

    L’effectif de master est par ailleurs remarquablement stable : 352 321 en 2019, 333 241 en 2023, 342 554 en 2024. Les variations d’une rentrée à l’autre sont de l’ordre de quelques pour cent, ce qui invite à la prudence face à tout commentaire dramatisant sur une seule année.

    Comment vérifier un compteur avant de le citer

    La leçon de méthode est le vrai enseignement de ces chiffres, et elle vaut pour n’importe quelle interface de données publiques. Trois contrôles, dans cet ordre.

    1. Le test du filtre. Ajoutez une condition et vérifiez que le nombre baisse. Ici, restreindre aux femmes fait passer les 765 895 inscrits du cursus M à 445 370 : le paramètre est bien pris en compte. Un compteur qui renvoie le même total quel que soit le filtre ignore silencieusement vos paramètres, et le chiffre que vous en tirez ne veut rien dire.
    2. Le test de la valeur inexistante. Interrogez une modalité qui n’existe pas. Une rentrée « 1899 » ou un diplôme mal orthographié doivent renvoyer un ensemble vide. S’ils renvoient un nombre, l’interface fait de l’approximation et ne compte pas ce que vous croyez.
    3. Le test de la somme. Décomposez le total et vérifiez que les parties le reconstituent exactement. C’est ce contrôle qui révèle ici que « cursus master » recouvre quatorze catégories de diplômes, dont une seule s’appelle master.

    Ces trois tests prennent cinq minutes et évitent l’erreur la plus coûteuse d’un mémoire sur données secondaires : citer un chiffre juste en réponse à une autre question que la sienne. Le cas de theses.fr, dont le moteur ne compte pas ce qu’il semble compter, illustre la même famille de pièges sur un moteur de recherche textuel.

    Citer ces chiffres proprement

    Une référence exploitable comporte cinq éléments : le producteur, le nom du jeu de données, l’année de rentrée, la date de consultation, et le filtre exact appliqué. Le dernier est le plus souvent omis et le plus important : sans lui, votre chiffre n’est pas reproductible, et un lecteur qui interroge la même base autrement obtiendra un autre nombre, tout aussi correct.

    Modèle de phrase : « À la rentrée 2024, 342 554 étudiants étaient inscrits en diplôme de master dans les établissements publics sous tutelle du ministère de l’enseignement supérieur, dont 40,8 % en lettres, langues et sciences humaines (SISE, effectifs d’étudiants inscrits, filtre diplôme = master, consulté en 2026). »

    Pour interroger ce type de base sans écrire une ligne de code, notre guide sur l’interrogation d’une API de données ouvertes par URL détaille la manipulation, et le tableau d’orientation des sources publiques aide à choisir le bon producteur selon la question posée. Sur les admissions plutôt que les inscriptions, voyez les chiffres officiels de la plateforme Mon Master.

    Et pour votre propre mémoire

    Si vous exploitez ces données comme source secondaire, la rigueur exigée est exactement celle décrite ci-dessus : périmètre explicite, filtre documenté, prudence sur les évolutions annuelles. Et si vous produisez vos propres données, la même exigence s’applique en amont — savoir ce que vous comptez avant de compter, ce qui est précisément l’objet d’un plan d’analyse écrit avant la collecte.

    Tesify vous accompagne sur la rédaction qui entoure ces chiffres : présenter une source secondaire avec son périmètre, justifier vos choix de filtrage, et intégrer des statistiques officielles dans une argumentation sans les surinterpréter.

    Rédiger votre mémoire sur données publiques avec Tesify

    Questions fréquentes

    Combien d’étudiants sont inscrits en master en France ?

    À la rentrée 2024, 765 895 étudiants relèvent du cursus master dans les établissements publics sous tutelle du ministère de l’enseignement supérieur, mais 342 554 seulement préparent un diplôme de master. Le premier chiffre inclut les années avancées d’études de santé, les écoles d’ingénieurs internes aux universités et les instituts d’études politiques, comptés par leur niveau et non par leur diplôme.

    Quelle est la première discipline en master ?

    Cela dépend entièrement du filtre. En cursus master, c’est la Santé, avec 217 776 inscrits soit 28,4 %. En diplôme de master, la Santé n’apparaît plus et la première discipline devient Lettres, langues et sciences humaines, avec 139 751 inscrits soit 40,8 %. Précisez toujours lequel des deux périmètres vous citez.

    Ces chiffres couvrent-ils tous les établissements ?

    Non. La base couvre le public sous tutelle du ministère de l’enseignement supérieur. Sont exclus l’enseignement privé, les écoles de commerce et les établissements relevant d’autres ministères. Une phrase commençant par « en France » sur la seule foi de cette base est donc trop large : écrivez « dans le supérieur public sous tutelle du ministère ».

    Les effectifs de master augmentent-ils ?

    Ils sont stables. On compte 352 321 inscrits en diplôme de master à la rentrée 2019, 333 241 en 2023 et 342 554 en 2024. Les écarts d’une année sur l’autre restent de quelques pour cent, sans tendance marquée sur la période. Méfiez-vous des commentaires bâtis sur la comparaison de deux rentrées consécutives.

    Puis-je utiliser ces données comme corpus pour mon mémoire ?

    Oui, et c’est un excellent terrain quand la question porte sur la structure de l’enseignement supérieur : la base est très finement ventilée, par établissement, par discipline, par sexe et par origine géographique, sur plusieurs rentrées. Vérifiez simplement que la variable qui vous intéresse est renseignée sur toute la période visée avant d’arrêter votre sujet — une couverture partielle découverte tardivement est le principal risque d’un mémoire sur données secondaires.

  • Vous n’avez pas pu randomiser : différence-de-différences, score de propension ou variable instrumentale ? (2026)

    Vous n’avez pas pu randomiser : différence-de-différences, score de propension ou variable instrumentale ? (2026)

    La question tombe en soutenance, et elle est presque toujours la même : « comment savez-vous que c’est votre dispositif qui a produit cet écart, et non le fait que les personnes qui y ont participé étaient déjà différentes au départ ? »

    C’est la question de l’identification causale, et elle n’a pas de réponse statistique automatique. Dans un essai randomisé, le tirage au sort y répond seul. Mais un mémoire de master travaille presque toujours sur des données observationnelles : les gens ont choisi de suivre la formation, les entreprises ont choisi de se certifier, les communes ont choisi d’adopter le dispositif.

    Trois stratégies existent pour s’en sortir honnêtement : la différence-de-différences, le score de propension et la variable instrumentale. Elles ne demandent pas les mêmes données, ne reposent pas sur les mêmes hypothèses, et ne sont pas également réalistes dans un mémoire. Voici comment choisir.

    Le vrai problème : le contrefactuel manquant

    Ce que vous voudriez mesurer, c’est la différence entre ce qui est arrivé aux personnes traitées et ce qui leur serait arrivé sans le traitement. Cette seconde quantité n’existe pas : c’est le contrefactuel, et il est par construction inobservable.

    Toute la méthodologie causale consiste donc à construire un substitut crédible du contrefactuel — un groupe, une période ou une variation qui puisse raisonnablement tenir lieu de « ce qui se serait passé sinon ».

    Le danger porte un nom : le biais de sélection. Si les personnes qui se portent volontaires pour une formation sont déjà les plus motivées, comparer leur performance à celle des non-participants mesure la motivation autant que la formation. Aucune quantité de sophistication statistique appliquée après coup ne répare une comparaison mal construite. C’est la version opérationnelle du principe bien connu selon lequel une corrélation n’établit pas une causalité.

    Pourquoi « j’ai ajouté des variables de contrôle » ne suffit pas

    Le réflexe naturel est d’introduire l’âge, le diplôme, l’ancienneté et le secteur comme covariables dans une régression linéaire multiple, puis de présenter le coefficient du traitement comme un effet « toutes choses égales par ailleurs ».

    C’est utile, mais il faut être lucide sur la portée : cette formule ne neutralise que les caractéristiques que vous avez mesurées. Elle ne dit rien de la motivation, du soutien hiérarchique, de l’ambition ou de l’état de santé antérieur si vous ne les avez pas dans votre base. Or ce sont précisément ces variables non observées qui déterminent le plus souvent qui reçoit le traitement.

    Les trois méthodes qui suivent se distinguent justement par ce qu’elles font de l’inobservé.

    Deux courbes parallèles qui divergent après une date d'intervention
    La différence-de-différences ne compare pas deux niveaux : elle compare deux évolutions.

    Différence-de-différences : comparer des évolutions, pas des niveaux

    C’est la stratégie la plus accessible en mémoire, et de loin.

    Le principe. Vous observez deux groupes — un traité, un non traité — à deux moments : avant et après l’intervention. Vous calculez l’évolution de chaque groupe, puis la différence entre ces deux évolutions. Le groupe témoin sert à absorber tout ce qui a bougé pour tout le monde pendant la période : la conjoncture, la saison, une réforme nationale.

    Le calcul se fait en une seule régression, avec trois termes : une indicatrice de groupe, une indicatrice de période, et leur produit. C’est le coefficient de ce produit qui est l’estimation de l’effet — la mécanique est rigoureusement celle d’un terme d’interaction, avec la même lecture des coefficients.

    Ce que ça neutralise. Toute différence stable entre les deux groupes, y compris non mesurée. Si votre groupe traité était déjà plus performant au départ, l’écart de départ est éliminé.

    L’hypothèse critique : les tendances parallèles. Sans le traitement, les deux groupes auraient évolué de la même façon. Elle n’est pas démontrable, mais elle se rend crédible : si vous disposez de plusieurs périodes avant l’intervention, montrez que les deux courbes évoluaient déjà en parallèle. Un graphique de ces trajectoires pré-traitement est l’élément le plus convaincant que vous puissiez mettre dans un mémoire d’évaluation.
    Le piège classique. Un traitement déclenché parce que le groupe allait mal — un dispositif d’accompagnement lancé dans les services où l’absentéisme grimpait déjà. Les tendances n’étaient alors pas parallèles avant, et la méthode attribuera au dispositif un retour à la moyenne qui se serait produit de toute façon.

    Le modèle à effets fixes sur données de panel est la généralisation directe de cette logique à plusieurs unités et plusieurs périodes.

    Score de propension : fabriquer un groupe témoin comparable

    Le principe. Vous n’avez pas de mesure « avant », mais vous avez beaucoup de caractéristiques observées. Vous estimez alors, pour chaque individu, la probabilité d’avoir reçu le traitement compte tenu de ces caractéristiques — c’est le score de propension, obtenu par une régression logistique binaire dont la variable dépendante est le fait d’être traité.

    Vous appariez ensuite chaque individu traité à un ou plusieurs non-traités ayant un score voisin, et vous comparez les résultats à l’intérieur de ces paires. L’idée : entre deux personnes qui avaient la même probabilité de participer, celle qui a participé et celle qui n’a pas participé sont raisonnablement comparables.

    Les deux contrôles obligatoires. Ils sont rarement faits dans les mémoires, et un jury informé les demandera.

    • Le support commun. Les distributions de scores des deux groupes doivent se recouvrir. Un individu traité dont le score est de 0,97 n’a aucun jumeau possible : il faut l’écarter, et dire combien vous en avez écartés.
    • L’équilibre après appariement. Vérifiez que chaque covariable est désormais distribuée de façon similaire dans les deux groupes. L’indicateur usuel est la différence de moyennes standardisée, qu’on souhaite ramener sous 0,10. C’est ce tableau « avant / après appariement » qui prouve que la méthode a fait son travail.

    La limite qu’il faut assumer par écrit. L’appariement n’équilibre que ce que vous avez mesuré. Il ne protège en rien contre une variable non observée qui déterminerait à la fois la participation et le résultat. Sur ce point précis, le score de propension est moins protecteur que la différence-de-différences, qui neutralise l’inobservé stable sans avoir eu besoin de le mesurer. Écrivez-le dans vos limites : cela vous vaudra des points plutôt que d’en coûter.

    Deux groupes d'individus appariés deux à deux, certains restant sans paire
    Apparier, c’est aussi accepter de perdre les individus qui n’ont aucun équivalent dans l’autre groupe.

    Variable instrumentale : élégante, et rarement praticable

    Le principe. Vous cherchez une variable — l’instrument — qui pousse les gens vers le traitement sans avoir d’effet propre sur le résultat. Elle joue le rôle d’un tirage au sort naturel : la part de variation du traitement qu’elle explique est, elle, indépendante des caractéristiques des individus.

    L’estimation se fait en deux temps : on prédit d’abord le traitement à partir de l’instrument, puis on utilise cette prédiction à la place du traitement réel dans l’équation de résultat.

    Deux conditions, dont une invérifiable.

    1. La pertinence : l’instrument doit être fortement corrélé au traitement. Cela se teste, et la règle usuelle est un F supérieur à 10 dans la première équation. Un instrument faible produit des estimations très biaisées, parfois pires que la régression naïve.
    2. La restriction d’exclusion : l’instrument ne doit influencer le résultat que par le canal du traitement. Cette condition ne se teste pas. Elle s’argumente, et c’est là que presque tous les candidats échouent.

    Les instruments crédibles de la littérature sont typiquement des accidents administratifs ou géographiques : la distance au centre de formation le plus proche, une date-seuil d’éligibilité, une loterie d’attribution. Ils sont rares, et un instrument bricolé est plus dangereux qu’utile.

    Verdict honnête pour un mémoire de master : ne partez pas sur une variable instrumentale à moins qu’un instrument évident ne soit déjà présent dans votre terrain et que votre directeur le valide. Une différence-de-différences bien conduite vaut mieux qu’une variable instrumentale mal défendue.

    Comment choisir en pratique

    La question à se poser n’est pas « quelle méthode est la meilleure » mais « quelle structure de données ai-je réellement ». Trois questions dans l’ordre :

    1. Ai-je des observations avant et après, sur un groupe traité et un groupe non traité ? → différence-de-différences. C’est le premier choix chaque fois qu’il est disponible.
    2. Sinon, ai-je une seule photographie, mais beaucoup de covariables de qualité ? → score de propension, avec les tableaux de support commun et d’équilibre.
    3. Sinon, ai-je un instrument que je peux défendre théoriquement en trois phrases ? → variable instrumentale. Si l’argument prend plus de trois phrases, vous n’avez pas d’instrument.

    Et si la réponse est non aux trois ? C’est fréquent, et ce n’est pas un échec. Vous présentez alors une association ajustée et non un effet causal : régression avec covariables, vocabulaire prudent, et une section de limites qui explique précisément quel confondant vous ne pouvez pas exclure. Un mémoire qui délimite honnêtement sa portée est mieux noté qu’un mémoire qui revendique une causalité que son plan de recherche ne permet pas.

    Ce qu’il faut écrire

    Quelle que soit la méthode, quatre éléments sont attendus dans le chapitre méthodologie : la nature du traitement et sa date, la manière dont le groupe de comparaison a été constitué, l’hypothèse d’identification énoncée en clair, et les tests ou éléments qui la rendent plausible.

    Modèle de phrase — différence-de-différences : « L’effet est estimé par différence-de-différences, en comparant l’évolution des services équipés à celle des services non équipés entre 2024 et 2026. L’identification repose sur l’hypothèse de tendances parallèles, dont la plausibilité est appuyée par l’évolution comparable des deux groupes sur les trois exercices antérieurs (figure 4). Le coefficient d’interaction indique une réduction de 3,2 points (p = 0,014). »

    Modèle de phrase — score de propension : « Les scores de propension ont été estimés par régression logistique sur huit covariables, puis les participants appariés au plus proche voisin dans la limite du support commun. Onze participants sans équivalent ont été exclus. Après appariement, toutes les différences de moyennes standardisées sont inférieures à 0,10 (tableau 3). L’identification suppose l’absence de confondant non observé, hypothèse discutée en limites. »

    Et la règle de vocabulaire qui traverse tout : est associé à tant que l’identification n’est pas défendue, a pour effet seulement une fois qu’elle l’est.

    Écrire le chapitre qui porte tout cela

    La difficulté d’un mémoire d’évaluation n’est pas le calcul — chacune de ces méthodes tient en quelques lignes de code. Elle est dans l’argumentation : expliquer pourquoi votre groupe de comparaison est crédible, énoncer une hypothèse d’identification sans jargon, et discuter ce qu’elle laisse ouvert.

    Tesify vous accompagne sur cette rédaction : structurer le chapitre méthodologie, articuler la stratégie d’identification avec votre question de recherche, et transformer vos choix techniques en argumentation défendable devant un jury. Vos données et vos analyses restent les vôtres.

    Structurer votre mémoire d’évaluation avec Tesify

    Questions fréquentes

    Puis-je faire une différence-de-différences sans groupe témoin ?

    Non — une comparaison avant/après sur le seul groupe traité n’est pas une différence-de-différences, c’est une simple évolution temporelle. Elle confond votre dispositif avec tout ce qui s’est passé d’autre pendant la période. Si aucun groupe non traité n’existe, cherchez une comparaison imparfaite mais argumentable — un service voisin, une région comparable, une cohorte antérieure — et discutez explicitement ses limites.

    Combien de variables faut-il pour un score de propension ?

    La règle n’est pas quantitative mais conceptuelle : incluez tout ce qui influence à la fois la participation et le résultat. En revanche, n’incluez jamais une variable postérieure au traitement, ni une conséquence du traitement : cela introduit un biais au lieu de le réduire. Une dizaine de covariables bien choisies vaut mieux que trente ajoutées au hasard.

    Faut-il un logiciel particulier ?

    Non. La différence-de-différences se fait dans n’importe quel logiciel de régression, y compris SPSS, puisqu’il s’agit d’une régression avec un terme produit. L’appariement sur score de propension demande une extension sous SPSS, et existe en standard sous R et Stata. Le choix de l’outil n’a aucune incidence sur la validité de la stratégie d’identification.

    Ces méthodes s’appliquent-elles à un mémoire qualitatif ?

    Non, elles supposent une variable de résultat mesurée sur un nombre suffisant d’unités. Un mémoire qualitatif répond à la question causale autrement : par la reconstitution du mécanisme et la comparaison raisonnée de cas, et non par l’estimation d’un effet moyen. Les deux démarches sont légitimes ; ce qui ne l’est pas, c’est d’emprunter le vocabulaire de l’une en pratiquant l’autre.

    Mon jury me demandera-t-il vraiment tout cela en master ?

    Il ne vous demandera pas une variable instrumentale. Il vous demandera presque à coup sûr pourquoi votre groupe de comparaison est comparable — c’est la question standard des soutenances sur données observationnelles. Avoir une réponse préparée, nommée et assumée en limites suffit à transformer le moment le plus redouté de la soutenance en démonstration de maîtrise. Notre guide du design expérimental couvre le cas symétrique, celui où la randomisation reste possible.

  • Faut-il supprimer les valeurs aberrantes de votre mémoire ? (2026)

    Faut-il supprimer les valeurs aberrantes de votre mémoire ? (2026)

    Vous demandez une boîte à moustaches, et le logiciel dessine quatre petits ronds au-dessus de la moustache supérieure, chacun avec son numéro d’observation. La tentation est immédiate : les supprimer, et voir si le résultat devient enfin significatif.

    Réponse courte : non, pas par défaut. Supprimer une observation n’est légitime que dans un seul cas — quand la valeur est fausse, ou quand l’individu n’appartient pas à la population que vous étudiez. Une valeur simplement grande, aussi gênante soit-elle, est une donnée. La supprimer parce qu’elle dérange est une faute méthodologique que les jurys repèrent, surtout quand la suppression fait passer un p juste sous 0,05.

    Voici la démarche complète : distinguer les trois espèces de valeurs aberrantes, les repérer correctement, décider, et surtout écrire ce que vous avez fait.

    Trois choses différentes qu’on appelle « valeur aberrante »

    La confusion vient de là. Le même mot désigne trois situations dont une seule justifie une suppression.

    1. L’erreur. Un âge de 220 ans, un score de 55 sur une échelle qui plafonne à 50, une virgule décimale déplacée. C’est une donnée fausse : elle se corrige si la source le permet, se supprime sinon. Aucun débat.
    2. L’individu hors population. Un cadre dirigeant dans une enquête sur les employés d’exécution ; un patient dont le dossier révèle une pathologie qui figurait dans vos critères d’exclusion. Ce n’est pas une valeur fausse, c’est une personne qui n’aurait pas dû entrer. Elle se retire, à condition que le motif d’exclusion soit énoncé et s’applique à tous de la même manière.
    3. La valeur extrême et vraie. Le répondant qui a réellement quarante ans d’ancienneté, l’entreprise réellement dix fois plus grande que les autres. Celle-là ne se supprime pas. Elle appartient à la réalité que vous prétendez décrire.

    Toute la difficulté du travail consiste à ranger chaque point signalé par le logiciel dans l’une de ces trois cases — et cela ne se fait pas depuis le graphique. Cela se fait en retournant à la source : le questionnaire papier, le dossier, le fichier d’origine.

    Boîte à moustaches stylisée avec trois points situés au-delà des moustaches
    Le logiciel signale des points ; il ne dit jamais lequel est une erreur et lequel est une réalité.

    Les repérer proprement

    Sur une seule variable

    La boîte à moustaches est l’outil le plus lisible. La convention usuelle marque comme atypique toute valeur située à plus d’une fois et demie l’écart interquartile au-delà d’un quartile, et comme extrême celle qui dépasse trois fois cet écart. SPSS affiche les premières par un cercle et les secondes par un astérisque, avec le numéro d’observation à côté — c’est ce numéro qui vous permet de retourner à la ligne concernée.

    Le score standardisé donne le même diagnostic autrement : on convertit la variable en scores centrés-réduits et on examine ceux qui dépassent environ 3,3 en valeur absolue. Sur de petits échantillons, un seuil de 2,5 est parfois retenu, mais il signale mécaniquement plus de points.

    Sur plusieurs variables à la fois

    Un point peut être parfaitement banal sur chaque variable prise isolément et complètement atypique dans leur combinaison : un étudiant de 19 ans avec quinze ans d’expérience professionnelle. Aucun boxplot ne le verra. La distance de Mahalanobis mesure l’éloignement de chaque observation au centre du nuage multivarié en tenant compte des corrélations entre variables ; on la compare à une loi du khi-deux dont le nombre de degrés de liberté est le nombre de variables considérées, avec un seuil très strict.

    En régression : atypique n’est pas influent

    C’est la distinction que la plupart des mémoires manquent, et celle qui impressionne quand elle est maîtrisée.

    Une observation peut être très éloignée du nuage sans changer quoi que ce soit à vos résultats, si elle se situe dans le prolongement de la tendance générale. À l’inverse, une observation modérément atypique mais placée à l’extrémité de la plage des valeurs prédictives peut, à elle seule, faire pivoter votre droite de régression.

    Ce qui compte n’est donc pas l’éloignement mais l’influence. Deux indicateurs à demander dans les options de sauvegarde de votre régression linéaire multiple :

    • la distance de Cook, qui résume de combien l’ensemble des coefficients changerait si l’observation était retirée. Une valeur supérieure à 1 est le signal d’alerte classique ; certains auteurs retiennent un seuil plus sensible, de l’ordre de quatre divisé par la taille de l’échantillon ;
    • le levier, qui mesure l’atypie de l’observation sur les variables explicatives seules.

    Le bon réflexe : trier votre fichier par distance de Cook décroissante et examiner les cinq premières lignes. C’est cinq minutes de travail, et c’est exactement ce qu’un directeur de mémoire vérifiera.

    L’arbre de décision

    Face à un point signalé, trois questions dans cet ordre — et une seule mène à la suppression.

    1. La valeur est-elle possible ? Non → erreur : corrigez depuis la source, ou supprimez la valeur en la traitant ensuite comme une donnée manquante plutôt qu’en supprimant l’individu entier.
    2. L’individu relève-t-il de votre population ? Non → exclusion documentée, avec un critère explicite appliqué uniformément.
    3. La valeur est vraie et l’individu est bien dans votre population ?vous la gardez. Reste alors à choisir comment analyser en sa présence.

    Quatre façons de gérer une valeur extrême qu’on garde

    Garder ne veut pas dire ignorer. Quatre options, de la plus légère à la plus interventionniste.

    1. Ne rien faire, et le dire. Si les indicateurs d’influence sont faibles, la valeur extrême ne pose aucun problème. Mentionnez que vous avez vérifié, et passez à la suite. C’est l’issue la plus fréquente et la plus sous-utilisée.

    2. Changer de test. Beaucoup de méthodes non paramétriques travaillent sur les rangs et sont donc insensibles à l’ampleur des valeurs extrêmes. C’est la raison pour laquelle on bascule d’un test t vers Mann-Whitney, ou du coefficient de Pearson vers Spearman. La médiane, de la même façon, résiste là où la moyenne cède.

    3. Transformer la variable. Une transformation logarithmique ou racine carrée comprime la queue haute d’une distribution asymétrique et ramène les valeurs extrêmes vers le corps de la distribution. Le prix à payer est l’interprétation : vos coefficients ne s’expriment plus dans l’unité d’origine, et il faut le gérer dans la rédaction.

    4. Winsoriser. Plutôt que de retirer l’observation, on ramène sa valeur à un seuil — par exemple au 95e centile. L’individu reste dans l’échantillon, son influence est plafonnée. C’est un compromis acceptable en gestion et en finance, à condition d’annoncer le seuil retenu avant de regarder les résultats, et non après.

    Deux versions d'une même analyse comparées côte à côte sur une balance
    La question n’est pas « avec ou sans », mais « le résultat tient-il dans les deux cas ».

    L’analyse de sensibilité : la réponse qui satisfait tous les jurys

    Voici la meilleure stratégie disponible, et elle est étonnamment simple : faites tourner l’analyse dans les deux versions et rapportez les deux.

    Cela transforme une décision arbitraire en résultat. Deux cas de figure, et vous êtes gagnant dans les deux :

    • Les conclusions sont les mêmes. Votre résultat est robuste. Une phrase en note de bas de page suffit, et elle renforce considérablement votre crédibilité.
    • Les conclusions diffèrent. C’est une information de premier ordre, pas un échec : votre résultat dépend d’une poignée d’observations. Vous le signalez, vous décrivez qui sont ces individus, et vous en faites une limite argumentée. Un jury préfère de très loin cette honnêteté à un résultat fragile présenté comme solide.

    Le seul mauvais choix est de tester les deux versions en silence et de ne rapporter que celle qui arrange. C’est ce que la littérature appelle le tri sélectif des résultats, et c’est précisément ce que l’analyse de sensibilité rend inutile.

    Ce qu’il faut écrire

    Le traitement des valeurs extrêmes se décrit dans la section de préparation des données, avant les résultats, en trois ou quatre phrases. Le lecteur doit pouvoir reconstituer exactement ce que vous avez fait.

    Modèle de phrase — aucune suppression : « L’examen des boîtes à moustaches a identifié quatre observations atypiques sur la variable d’ancienneté. Le retour aux questionnaires a confirmé qu’il s’agissait de valeurs plausibles ; aucune n’a donc été supprimée. Les distances de Cook restant toutes inférieures à 1, ces observations n’exercent pas d’influence déterminante sur les estimations. »

    Modèle de phrase — suppression justifiée : « Deux observations présentaient un âge incompatible avec les critères d’inclusion (respectivement 4 et 220 ans) et ont été identifiées comme des erreurs de saisie ; la valeur a été recodée en donnée manquante. Aucune autre observation n’a été retirée. »

    Modèle de phrase — analyse de sensibilité : « L’analyse a été conduite avec puis sans les trois observations les plus influentes. Les coefficients varient marginalement et les conclusions restent inchangées ; les résultats présentés portent sur l’échantillon complet. »

    Une règle de forme, enfin : ne parlez jamais de « nettoyage » des données sans dire ce que vous avez nettoyé et combien de lignes en sont sorties. Un effectif final qui ne correspond pas à l’effectif annoncé au chapitre méthodologie est l’une des incohérences que les jurys relèvent le plus souvent. L’annuaire des conditions statistiques et de leurs plans de secours reprend cette vérification parmi les contrôles à faire avant de rédiger les résultats.

    Rédiger la partie qui explique vos choix

    Décider quoi faire d’une valeur extrême prend dix minutes. Écrire le paragraphe qui justifie ce choix, l’articuler avec vos critères d’inclusion et le rappeler correctement en limites prend beaucoup plus longtemps — et c’est ce paragraphe que le jury lira.

    Tesify vous accompagne sur cette rédaction : structurer la section de préparation des données, maintenir la cohérence des effectifs d’un chapitre à l’autre, et transformer vos décisions techniques en justifications défendables. Vos données et vos analyses restent les vôtres.

    Rédiger votre chapitre méthodologie avec Tesify

    Questions fréquentes

    Combien de valeurs aberrantes est-il normal d’avoir ?

    Il n’y a pas de norme, et c’est important à comprendre : le critère de la boîte à moustaches signale mécaniquement des points même dans une distribution parfaitement normale, d’autant plus que l’échantillon est grand. En voir quelques-uns n’indique rien d’anormal. Ce qui doit alerter, c’est une proportion élevée sur une même variable — signe possible d’un problème de saisie, d’une échelle mal comprise par les répondants, ou d’une population plus hétérogène que prévu.

    Puis-je supprimer une observation parce qu’elle rend mon test non significatif ?

    Non, jamais. C’est la seule règle absolue de cet article. Une décision de suppression doit être prise sur un critère défini avant de regarder les résultats, et appliquée de la même façon à toutes les observations. Si vous découvrez après coup qu’un point change tout, l’issue correcte n’est pas la suppression mais l’analyse de sensibilité : rapportez les deux versions et discutez la différence.

    Faut-il traiter les valeurs extrêmes avant ou après le test de normalité ?

    Avant, car elles en sont souvent la cause. Une distribution rejetée par un test de normalité l’est fréquemment à cause de deux ou trois valeurs en queue de distribution. Examinez-les d’abord, décidez, puis relancez le diagnostic de normalité sur les données telles que vous avez décidé de les analyser.

    Que faire d’un individu qui a répondu de façon manifestement peu sérieuse ?

    C’est un cas de qualité de réponse, pas de valeur extrême, et il se traite avec ses propres critères : temps de passation anormalement court, réponse identique à tous les items, incohérence entre deux questions de contrôle. Ces critères doivent être fixés à l’avance et énoncés dans le mémoire. Un individu ainsi écarté est une exclusion documentée, pas une valeur aberrante supprimée.

    La winsorisation est-elle acceptée dans un mémoire de master ?

    Oui, à condition d’être annoncée et justifiée. Elle est courante en finance et en gestion, où les distributions de variables monétaires sont très asymétriques. Précisez le seuil retenu, le nombre de valeurs affectées, et présentez de préférence les résultats non winsorisés en annexe. Dans un mémoire, la transparence sur le traitement compte davantage que le choix du traitement lui-même.