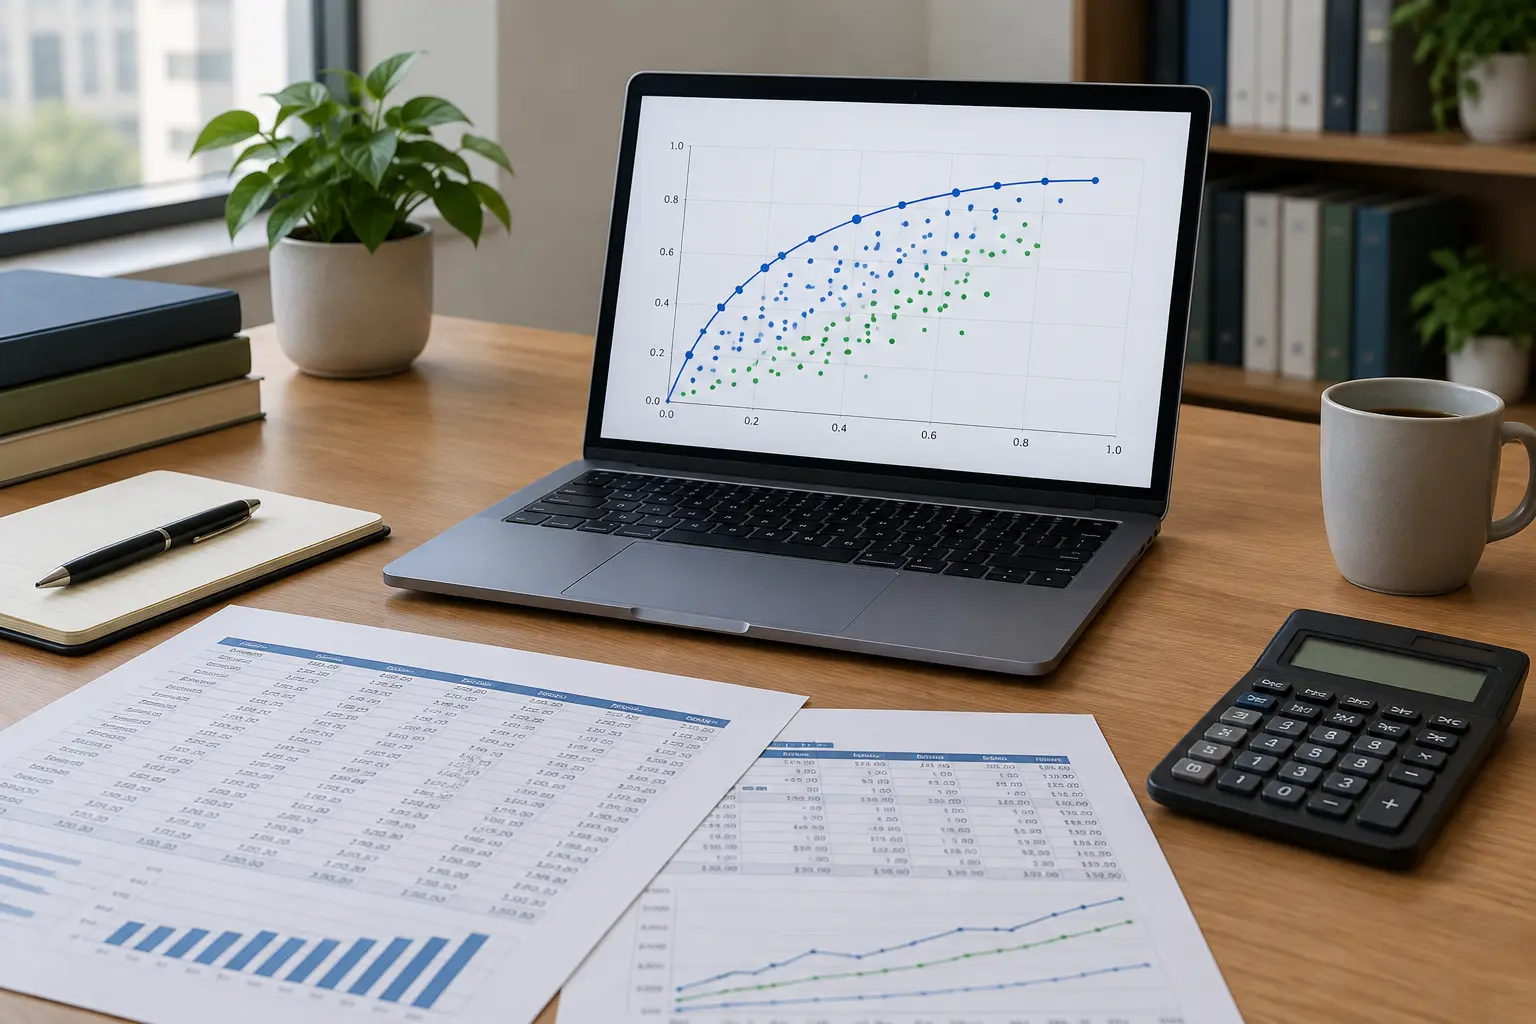
Comparer l’efficience de plusieurs agences, filiales ou établissements à partir de plusieurs ressources consommées et plusieurs résultats produits est une question fréquente en mémoire de gestion, mais elle dépasse ce qu’un simple ratio ou une régression linéaire permet de traiter proprement. La méthode DEA (Data Envelopment Analysis, ou analyse d’enveloppement des données) a été conçue précisément pour ce type de problème. Ce guide en présente le principe et propose un exemple d’application construit pas à pas.
Ce que la méthode DEA permet de faire
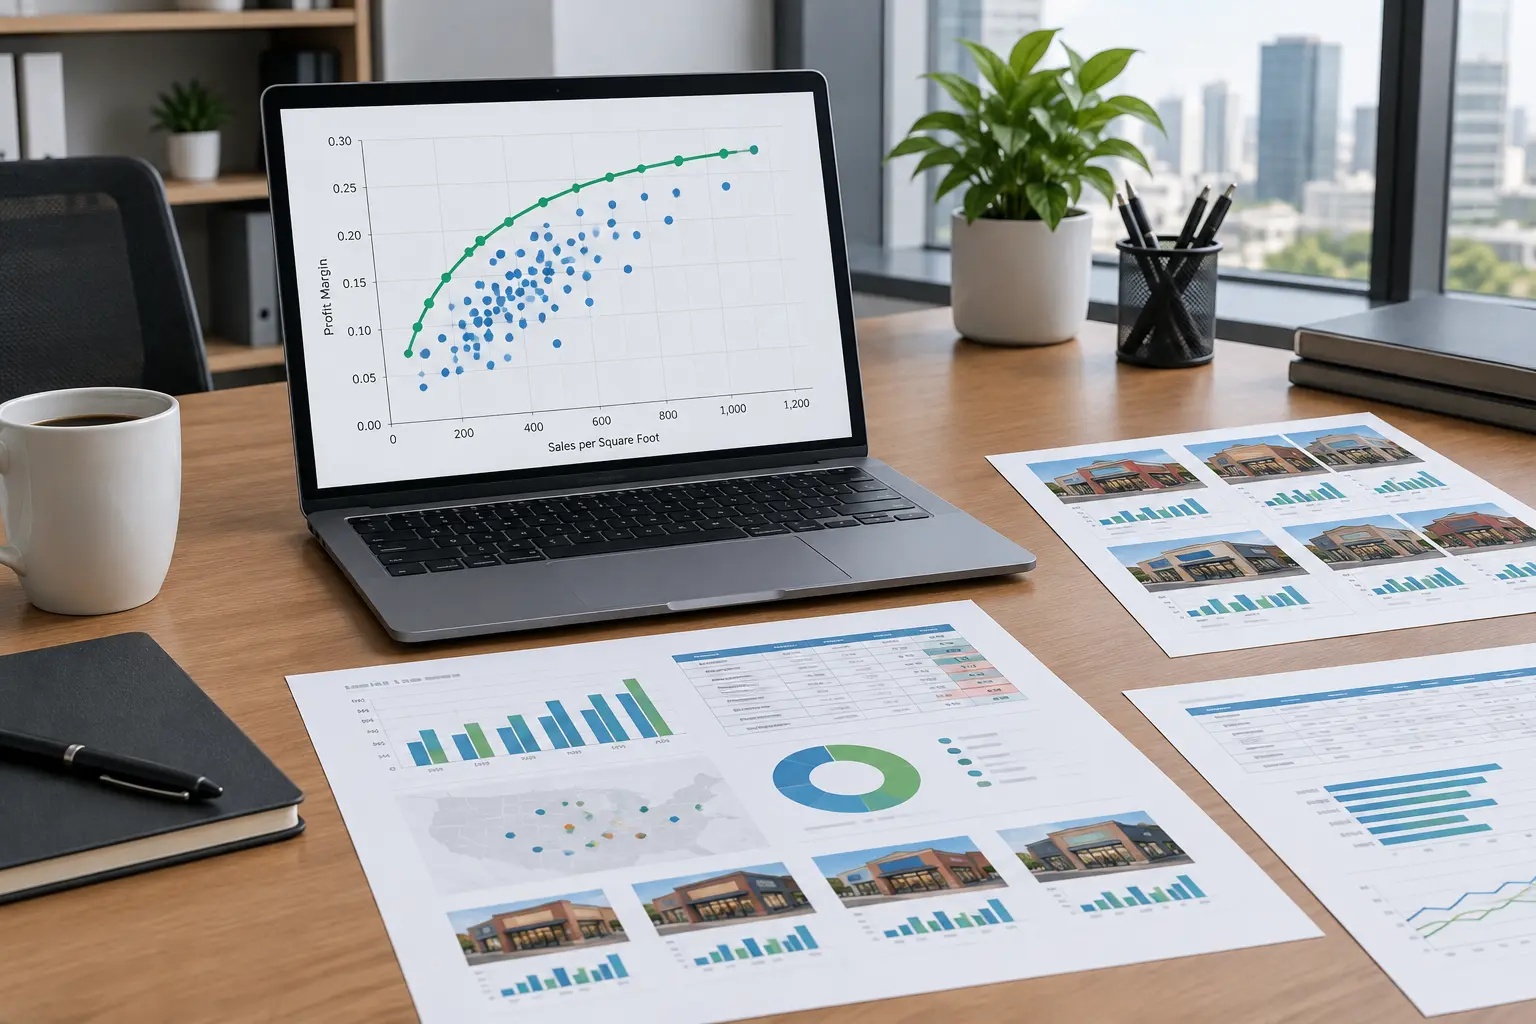
La méthode DEA a été développée par Charnes, Cooper et Rhodes en 1978, puis étendue par Banker, Charnes et Cooper en 1984. C’est une méthode non paramétrique de mesure de l’efficience relative d’un ensemble d’unités comparables (appelées unités de décision, ou DMU pour Decision Making Units), à partir de plusieurs ressources consommées (les intrants) et plusieurs résultats produits (les extrants), sans qu’il soit nécessaire de spécifier a priori une forme fonctionnelle reliant ces variables, contrairement à une régression classique. La méthode construit une frontière d’efficience à partir des unités les plus performantes de l’échantillon, puis mesure la distance de chaque unité à cette frontière : un score de 1 signale une unité efficiente (sur la frontière), un score inférieur à 1 signale une unité moins efficiente que la meilleure pratique observée dans l’échantillon.
Pourquoi cette méthode convient à certains sujets de mémoire de gestion
La DEA est particulièrement adaptée quand un mémoire compare des unités comparables (agences bancaires, magasins d’une même enseigne, hôpitaux, établissements scolaires, exploitations agricoles) sur plusieurs ressources et plusieurs résultats simultanément, sans vouloir agréger ces dimensions dans un ratio unique qui perdrait de l’information. Un ratio classique (chiffre d’affaires par employé, par exemple) ne traite qu’une ressource et qu’un résultat à la fois ; la DEA permet de traiter simultanément plusieurs intrants (effectif, surface, budget) et plusieurs extrants (chiffre d’affaires, satisfaction client, nombre de clients servis), ce qui correspond souvent mieux à la réalité d’une organisation. C’est cette capacité à raisonner simultanément sur plusieurs dimensions, sans les réduire artificiellement à un score composite arbitraire, qui explique l’usage de la méthode dans les études d’efficience organisationnelle depuis plus de quarante ans.
Les deux modèles de base : CCR et BCC
Le modèle initial, dit CCR (du nom de ses auteurs Charnes, Cooper et Rhodes), suppose des rendements d’échelle constants : une unité deux fois plus grande devrait produire, à efficience égale, exactement deux fois plus de résultats. Le modèle BCC (Banker, Charnes, Cooper), développé six ans plus tard, relâche cette hypothèse et autorise des rendements d’échelle variables, ce qui convient mieux à des organisations de tailles très différentes où les grandes structures ne sont pas nécessairement proportionnellement aussi efficientes que les petites. Un mémoire qui compare des unités de taille homogène peut retenir le modèle CCR ; un mémoire qui compare des unités de tailles très variées gagne à justifier explicitement le choix du modèle BCC, ou à présenter les deux pour discuter l’écart entre efficience technique globale et efficience technique pure. Cet écart entre les deux scores, quand il est important, révèle lui-même une information utile : il signale qu’une partie de l’inefficience mesurée provient de la taille de l’unité plutôt que de la façon dont elle est gérée.
Orientation input ou orientation output
Un choix supplémentaire concerne l’orientation du modèle : une orientation input cherche de combien les intrants pourraient être réduits pour atteindre la frontière d’efficience à niveau d’extrants constant, tandis qu’une orientation output cherche de combien les extrants pourraient être augmentés à niveau d’intrants constant. Le choix dépend de ce que l’organisation étudiée maîtrise le plus directement : une orientation input convient à un contexte où les ressources sont figées à court terme (effectifs, surface) et où la question porte sur leur meilleure utilisation ; une orientation output convient davantage quand l’enjeu est d’augmenter la production ou le service rendu à moyens constants.
Exemple d’application construit pas à pas
Prenons un exemple, à visée illustrative, sur la comparaison de l’efficience de dix agences commerciales d’une même enseigne. Les intrants retenus pourraient être le nombre d’employés et la surface de vente ; les extrants, le chiffre d’affaires annuel et le nombre de clients actifs. Après collecte de ces quatre variables pour les dix agences, un logiciel de DEA calcule, pour chaque agence, son score d’efficience relative par rapport aux agences les plus performantes de l’échantillon. Les agences obtenant un score de 1 forment la frontière d’efficience ; elles servent de référence (on parle de « pairs » ou d’unités de comparaison) pour identifier, pour chaque agence moins efficiente, quelle combinaison de réduction d’intrants ou d’augmentation d’extrants lui permettrait théoriquement d’atteindre la frontière. Dans un modèle orienté input, une agence affichant un score de 0,85, par exemple, pourrait théoriquement produire les mêmes résultats avec 15 % de ressources en moins, si elle adoptait les pratiques des agences de référence identifiées par le calcul. Cet exemple est fictif et construit à visée pédagogique ; les données réelles d’un mémoire doivent être vérifiées et collectées sur le terrain étudié, jamais reprises de cet exemple.
Choisir les intrants et les extrants : la décision la plus scrutée par un jury
Le choix des variables retenues comme intrants et extrants conditionne entièrement le résultat de l’analyse, et c’est un point sur lequel un jury de mémoire de gestion interroge souvent un travail utilisant la DEA. Ce choix doit être justifié par le cadre théorique et par la littérature existante sur le secteur étudié, pas seulement par la disponibilité des données. Un nombre trop élevé de variables par rapport au nombre d’unités comparées (DMU) affaiblit la capacité discriminante de la méthode, un point déjà souligné par Golany et Roll (1989) : plus on ajoute de variables, plus d’unités se retrouvent sur la frontière. Plusieurs règles empiriques circulent, sans consensus — on lit par exemple qu’il faudrait au moins deux, voire trois fois plus d’unités que d’intrants et d’extrants réunis —, ce qui limite en pratique le nombre de variables mobilisables pour un échantillon de taille modeste, comme c’est souvent le cas dans un mémoire de master.
Logiciels et outils disponibles
Plusieurs outils permettent de mener une analyse DEA sans développer soi-même les calculs d’optimisation linéaire sous-jacents. Le logiciel libre R propose des packages dédiés, par exemple le package Benchmarking, disponible gratuitement sur le CRAN, qui calcule des scores d’efficience sous différentes hypothèses de rendements d’échelle, orientés input ou output, et identifie les unités de référence. Des logiciels commerciaux spécialisés existent également, avec un coût de licence à vérifier avant de s’engager sur cette méthode si le budget de recherche est contraint. Pour un mémoire de master, R reste généralement un choix accessible, à condition de prévoir un temps d’apprentissage si vous n’avez jamais utilisé ce langage. Quel que soit l’outil retenu, prévoyez un temps de familiarisation avec la syntaxe avant la collecte définitive des données, pour éviter de découvrir une contrainte technique (format de données attendu, traitement des valeurs manquantes) une fois le terrain déjà mené.
Ce que la DEA ne permet pas de conclure
Un score d’efficience DEA est relatif à l’échantillon étudié, pas absolu : une unité jugée efficiente au sein de dix agences pourrait ne plus l’être si l’échantillon s’élargissait à cinquante agences incluant des pratiques encore meilleures. La méthode ne teste pas non plus la significativité statistique des écarts observés au sens d’un test d’hypothèse classique, et elle est sensible aux valeurs aberrantes (une unité atypique peut, à elle seule, déplacer la frontière d’efficience et fausser l’évaluation des autres). Un mémoire sérieux discute ces limites explicitement dans la partie consacrée à la méthode plutôt que de présenter le score d’efficience comme une vérité absolue et définitive.
Interpréter les scores et expliquer les écarts d’efficience par une seconde étape
Une fois les scores d’efficience calculés, un mémoire de gestion s’arrête rarement au classement des unités : la question suivante, souvent posée en soutenance, est « qu’est-ce qui explique qu’une agence soit efficiente et une autre non ? ». Une pratique répandue consiste à mener une analyse de deuxième étape, où le score d’efficience calculé par la DEA devient à son tour la variable à expliquer par d’autres facteurs (ancienneté du responsable d’agence, zone de chalandise, ancienneté de l’agence elle-même, taux de rotation du personnel). Le score DEA étant borné entre 0 et 1, avec souvent plusieurs unités exactement à 1, cette seconde étape a longtemps été traitée par une régression censurée de type Tobit. Ce choix est toutefois débattu : Simar et Wilson (2007, Journal of Econometrics) ont proposé une régression tronquée avec bootstrap, tandis que McDonald (2009, European Journal of Operational Research) a défendu l’usage des moindres carrés ordinaires, jugés au moins aussi appropriés que le Tobit dans ce cadre. Un mémoire doit donc justifier sa méthode de deuxième étape en mentionnant ce débat, plutôt que de présenter le Tobit comme la solution évidente. Pour identifier la famille de régression adaptée à la nature exacte de la variable que vous cherchez à expliquer (continue, bornée, de comptage), l’annuaire des analyses selon le type de variable dépendante détaille les critères de choix, y compris pour des cas moins classiques que la régression linéaire simple. Cette étape supplémentaire transforme un simple classement d’unités en un résultat véritablement explicatif, ce qu’un jury de mémoire de gestion attend généralement au-delà du calcul technique lui-même.
Comment rapporter la méthode dans le chapitre méthodologie
Le chapitre méthode doit préciser : le modèle retenu (CCR ou BCC) et sa justification, l’orientation choisie (input ou output), les intrants et extrants retenus avec leur justification théorique, le nombre d’unités comparées et sa cohérence avec le nombre de variables, la méthode de deuxième étape éventuelle, et le logiciel utilisé avec sa version. Cette traçabilité permet à un lecteur de comprendre exactement comment les scores d’efficience ont été obtenus et d’apprécier la robustesse du choix méthodologique.
Anticiper les questions du jury sur cette méthode
Un mémoire qui mobilise la DEA doit être prêt à répondre à trois questions récurrentes en soutenance : pourquoi ce choix de variables plutôt qu’un autre jeu d’intrants et d’extrants tout aussi défendable ; comment le mémoire traite les unités atypiques qui pourraient déformer la frontière d’efficience ; et ce que le score d’efficience calculé permet réellement de recommander à un gestionnaire, au-delà du simple classement des unités étudiées. Préparer ces réponses dès la rédaction du chapitre méthode, plutôt qu’au moment de la soutenance, renforce nettement la crédibilité du travail.
Questions fréquentes
Faut-il des compétences avancées en statistiques pour utiliser la DEA ?
La méthode elle-même repose sur de la programmation linéaire plutôt que sur des statistiques inférentielles classiques, ce qui la rend accessible sans formation statistique poussée, à condition de bien comprendre la logique de frontière d’efficience et de savoir utiliser un logiciel dédié comme R.
Combien d’unités faut-il comparer pour une analyse DEA de mémoire ?
Il n’existe pas de seuil absolu ni de consensus. Plusieurs règles empiriques circulent, qui demandent de l’ordre de deux à trois fois plus d’unités que d’intrants et d’extrants réunis ; l’essentiel est de justifier le rapport entre nombre d’unités et nombre de variables, car trop de variables réduisent la capacité discriminante de l’analyse.
Peut-on combiner la DEA avec une seconde méthode ?
Oui, c’est une pratique courante : les scores d’efficience obtenus par DEA sont parfois utilisés comme variable dépendante dans une régression de deuxième étape, pour identifier les facteurs qui expliquent les écarts d’efficience observés entre les unités.
Faut-il choisir entre le modèle CCR et le modèle BCC avant de commencer ?
Il est possible, et souvent recommandé pour un mémoire, de calculer les deux et de comparer les scores obtenus : l’écart entre les deux renseigne directement sur la part de l’inefficience liée à l’échelle de l’unité plutôt qu’à sa gestion propre.
Quelle régression utiliser en deuxième étape ?
Le score DEA étant borné entre 0 et 1, le Tobit a longtemps été utilisé, mais ce choix est débattu : Simar et Wilson (2007) proposent une régression tronquée avec bootstrap, McDonald (2009) défend les moindres carrés ordinaires. Choisissez une méthode, citez ce débat et justifiez votre choix dans le chapitre méthode.
Une fois la méthode choisie, la construction du chapitre méthodologique suit la même logique que pour tout mémoire de gestion fondé sur une comparaison d’unités, détaillée dans le guide sur le mémoire de gestion fondé sur une étude de cas. Pour transformer les objectifs de recherche en variables mesurables avant l’analyse, l’article sur l’opérationnalisation des variables détaille la démarche générale.
Plus de 9 000 étudiants rédigent déjà leur mémoire avec Tesify, et chaque ligne reste 100 % écrite par vous. Créez votre espace de rédaction sur Tesify pour avancer sur votre mémoire de gestion.