« L’IA générative en marketing » revient souvent dans les listes de sujets tendance, mais rarement développé au-delà d’une ligne. Un vrai sujet de mémoire suppose de choisir un angle précis, une population, des variables et une méthode — pas seulement un thème à la mode. Ce guide construit un exemple complet, centré sur l’acceptation du contenu marketing généré par IA, pour montrer comment cadrer ce type de sujet du problème jusqu’aux outils d’analyse.
Pourquoi « l’IA générative en marketing » n’est pas encore un sujet
Le thème est réel et porteur, mais il recouvre des objets de recherche très différents selon l’angle retenu : la production de contenu par l’entreprise (comment les équipes marketing utilisent l’IA générative pour créer des visuels ou des textes publicitaires), la réception par les consommateurs (comment le public perçoit et accepte un contenu qu’il sait ou soupçonne généré par IA), ou l’impact organisationnel (comment l’IA générative redéfinit les métiers du marketing). Un sujet de mémoire doit choisir l’un de ces angles et le développer, plutôt que de les mélanger sous un titre générique. Cet article développe le deuxième angle — la réception par les consommateurs — à titre d’exemple complet et transposable aux deux autres.
Poser le problème : pourquoi la question mérite d’être posée
Le contenu publicitaire généré par IA (visuels, textes, voire vidéos) se diffuse désormais dans des campagnes réelles, et la réaction des consommateurs qui identifient ou soupçonnent cette origine reste à documenter, en particulier dans le contexte français. La question de recherche qui en découle : la divulgation ou la détection d’un contenu marketing généré par IA modifie-t-elle la confiance et l’intention d’achat du consommateur, et si oui, sous quelles conditions ? Cette formulation évite l’écueil du sujet trop large (« l’IA et le marketing ») en isolant un mécanisme précis : l’effet de la divulgation ou de la détection sur deux variables de réponse mesurables.
Le cadre théorique à mobiliser
Trois familles de théories permettent d’ancrer ce sujet. La théorie de l’acceptation technologique (TAM, Davis) et ses extensions expliquent l’adoption d’outils par les entreprises, mais s’applique moins directement à la réception par le consommateur d’un contenu produit avec ces outils. Plus pertinents pour l’angle consommateur : les travaux sur l’authenticité perçue de la marque, qui documentent comment un contenu perçu comme moins authentique ou moins humain affecte l’attitude envers la marque ; et les travaux sur la divulgation publicitaire (disclosure), qui étudient depuis longtemps comment révéler qu’un contenu est publicitaire (ou, ici, généré par IA) modifie sa réception. Ces cadres théoriques, déjà bien établis en recherche marketing, offrent un socle solide sans qu’il soit nécessaire d’inventer un modèle entièrement nouveau pour un mémoire de master. Un mémoire sérieux ouvrira aussi une discussion sur la notion d’« uncanny valley » appliquée au contenu généré (un contenu presque mais pas tout à fait crédible peut susciter un malaise plus fort qu’un contenu clairement artificiel ou clairement humain), une piste théorique récente à documenter avec des sources ouvertes plutôt qu’affirmée sans référence.
Objectifs, variables et hypothèses : un exemple construit
L’objectif général pourrait se formuler ainsi : évaluer l’effet de la divulgation d’une origine IA sur la confiance envers la marque et l’intention d’achat, et identifier les facteurs qui modèrent cet effet. Les objectifs spécifiques se déclinent en trois étapes vérifiables : mesurer la confiance et l’intention d’achat face à un contenu présenté comme généré par IA versus un contenu présenté comme conçu par des créatifs humains ; identifier si la familiarité du répondant avec les outils d’IA générative modère cet effet ; et formuler des recommandations pour les praticiens sur l’opportunité et les conditions de la divulgation. À titre d’exemple illustratif, deux hypothèses pourraient en découler : H1, la divulgation d’une origine IA réduit la confiance envers la marque comparativement à une origine humaine déclarée ; H2, cet effet négatif est atténué chez les répondants ayant une familiarité élevée avec les outils d’IA générative. Une matrice d’opérationnalisation transformerait ensuite ces objectifs en variables mesurables : la confiance et l’intention d’achat comme variables dépendantes (mesurées par des échelles existantes de la littérature marketing), l’origine perçue du contenu (manipulée expérimentalement ou déclarée) comme variable indépendante, et la familiarité avec l’IA comme variable modératrice.
Choisir une méthode adaptée à ce type de sujet
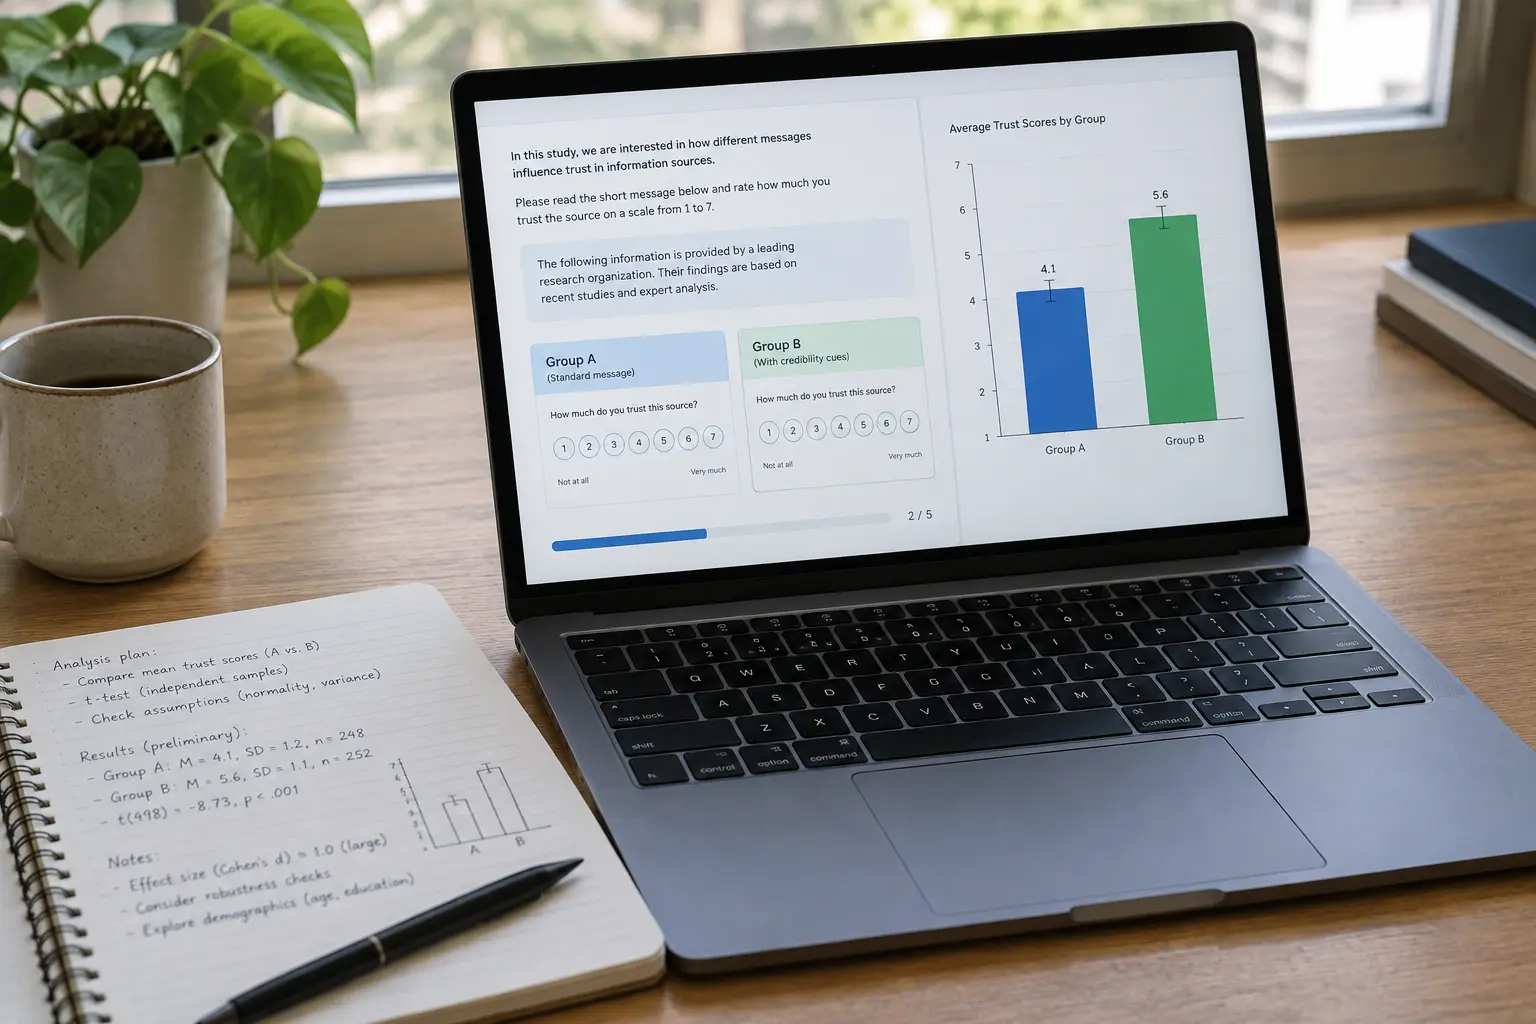
Deux méthodes conviennent particulièrement à cet angle. Un plan expérimental (vignette expérimentale) présente à des groupes de répondants un même contenu publicitaire, en faisant varier uniquement l’information sur son origine (IA déclarée, humaine déclarée, non précisée), puis mesure les variables de réponse par échelle : cette méthode permet d’isoler l’effet causal de la divulgation, ce qu’une simple enquête déclarative ne permet pas. Une étude qualitative par entretiens semi-directifs, alternative ou complémentaire, explore plus finement les raisonnements et les réserves des consommateurs face à un contenu qu’ils identifient comme généré par IA, au prix d’une moindre capacité à isoler un effet causal net. Le choix entre les deux, ou leur combinaison en design mixte, dépend du temps disponible et de l’accès à un panel de répondants suffisant pour un plan expérimental.
Quels outils pour mener cette recherche
Pour la construction du plan expérimental et la diffusion du questionnaire, des outils d’enquête en ligne standards (Google Forms, Qualtrics selon l’accès de l’université) suffisent ; l’essentiel est de garantir une répartition aléatoire des répondants entre les versions du stimulus. Pour l’analyse statistique d’un plan expérimental à groupes indépendants, un test de comparaison de moyennes ou une analyse de variance (ANOVA) permet de vérifier l’effet de la condition sur les variables de réponse, avec un logiciel comme SPSS, Jamovi ou R selon ce qu’enseigne votre formation. Pour la partie qualitative complémentaire, un logiciel d’analyse qualitative assistée par ordinateur facilite le codage des verbatims, sans se substituer à l’interprétation. Le choix d’un outil d’IA générative pour produire soi-même le stimulus expérimental (l’image ou le texte publicitaire testé) fait partie intégrante de la méthode et doit être documenté : lequel a été utilisé, avec quel prompt, et pourquoi ce choix plutôt qu’un autre. Cette documentation du prompt et de l’outil est elle-même un élément de reproductibilité qu’il est facile d’oublier, alors qu’elle est aussi simple à noter qu’une référence bibliographique.
Recruter et diffuser le stimulus expérimental
Un point souvent sous-estimé est la diffusion du plan expérimental à un échantillon suffisamment large et diversifié. Un panel académique ou un réseau personnel élargi via les réseaux sociaux permet généralement de recruter suffisamment de répondants pour un test de comparaison de moyennes entre deux ou trois groupes, à condition de viser au moins une trentaine de répondants par condition expérimentale pour disposer d’une puissance statistique minimale. Vérifier la répartition démographique de l’échantillon obtenu (âge, familiarité déclarée avec les outils d’IA) permet ensuite de discuter honnêtement les limites de généralisation du résultat en conclusion, plutôt que de les découvrir a posteriori.
Ce que ce sujet ne doit pas devenir
Un piège fréquent consiste à transformer ce sujet en comparatif d’outils d’IA générative (lequel produit le meilleur visuel publicitaire), ce qui relève d’un travail technique ou professionnel plutôt que d’une recherche marketing sur le comportement du consommateur. Un autre piège consiste à formuler des affirmations générales sur « l’IA qui remplace les créatifs » sans les rattacher à une donnée empirique récente et vérifiée : ce type d’affirmation évolue vite et doit être daté et sourcé plutôt que présenté comme une évidence stable. Un troisième piège, plus subtil, consiste à présenter la divulgation de l’origine IA comme systématiquement négative pour la marque avant même d’avoir collecté la moindre donnée : la littérature sur la divulgation publicitaire montre au contraire des effets contrastés selon le secteur et la catégorie de produit, ce qui justifie précisément de le tester plutôt que de le supposer.
Transposer cette méthode à un autre angle
La même démarche s’applique aux deux autres angles mentionnés en introduction. Pour l’angle production (comment les équipes marketing adoptent l’IA générative), le cadre théorique se déplacerait vers les modèles d’adoption technologique en organisation (TAM, UTAUT) et la méthode vers des entretiens avec des professionnels du marketing plutôt qu’avec des consommateurs. Pour l’angle organisationnel (transformation des métiers), une approche qualitative longitudinale ou une étude de cas d’entreprise serait plus appropriée qu’un plan expérimental. Dans les trois cas, la même exigence s’applique : un objectif général, des objectifs spécifiques vérifiables, une méthode alignée sur la question posée, plutôt qu’un thème à la mode laissé à l’état de titre.
Anticiper la discussion des résultats, quelle que soit leur direction
Un mémoire bien cadré anticipe, dès la méthodologie, les deux scénarios possibles de résultat plutôt que de n’envisager que celui qui confirmerait l’hypothèse de départ. Si la divulgation d’une origine IA ne modifie pas significativement la confiance ou l’intention d’achat, ce résultat est tout aussi discutable et publiable qu’un effet significatif : il questionnerait alors la robustesse de l’authenticité perçue comme variable clé, ou suggérerait que d’autres facteurs (la catégorie de produit, l’implication du consommateur) pèsent davantage que l’origine du contenu. Anticiper cette discussion dès la rédaction de la problématique, plutôt que de la découvrir après le recueil des données, évite de se retrouver démuni si l’hypothèse de départ n’est pas confirmée.
Questions fréquentes
Faut-il déjà maîtriser les statistiques pour choisir l’angle expérimental ?
Un test de comparaison de moyennes ou une ANOVA à un facteur reste accessible avec les enseignements de méthodes quantitatives standards d’un master en marketing. Si le plan expérimental prévoit plusieurs facteurs croisés, l’appui d’un enseignant ou d’un tuteur méthodologique devient recommandé.
Peut-on utiliser un contenu réellement généré par IA comme stimulus expérimental ?
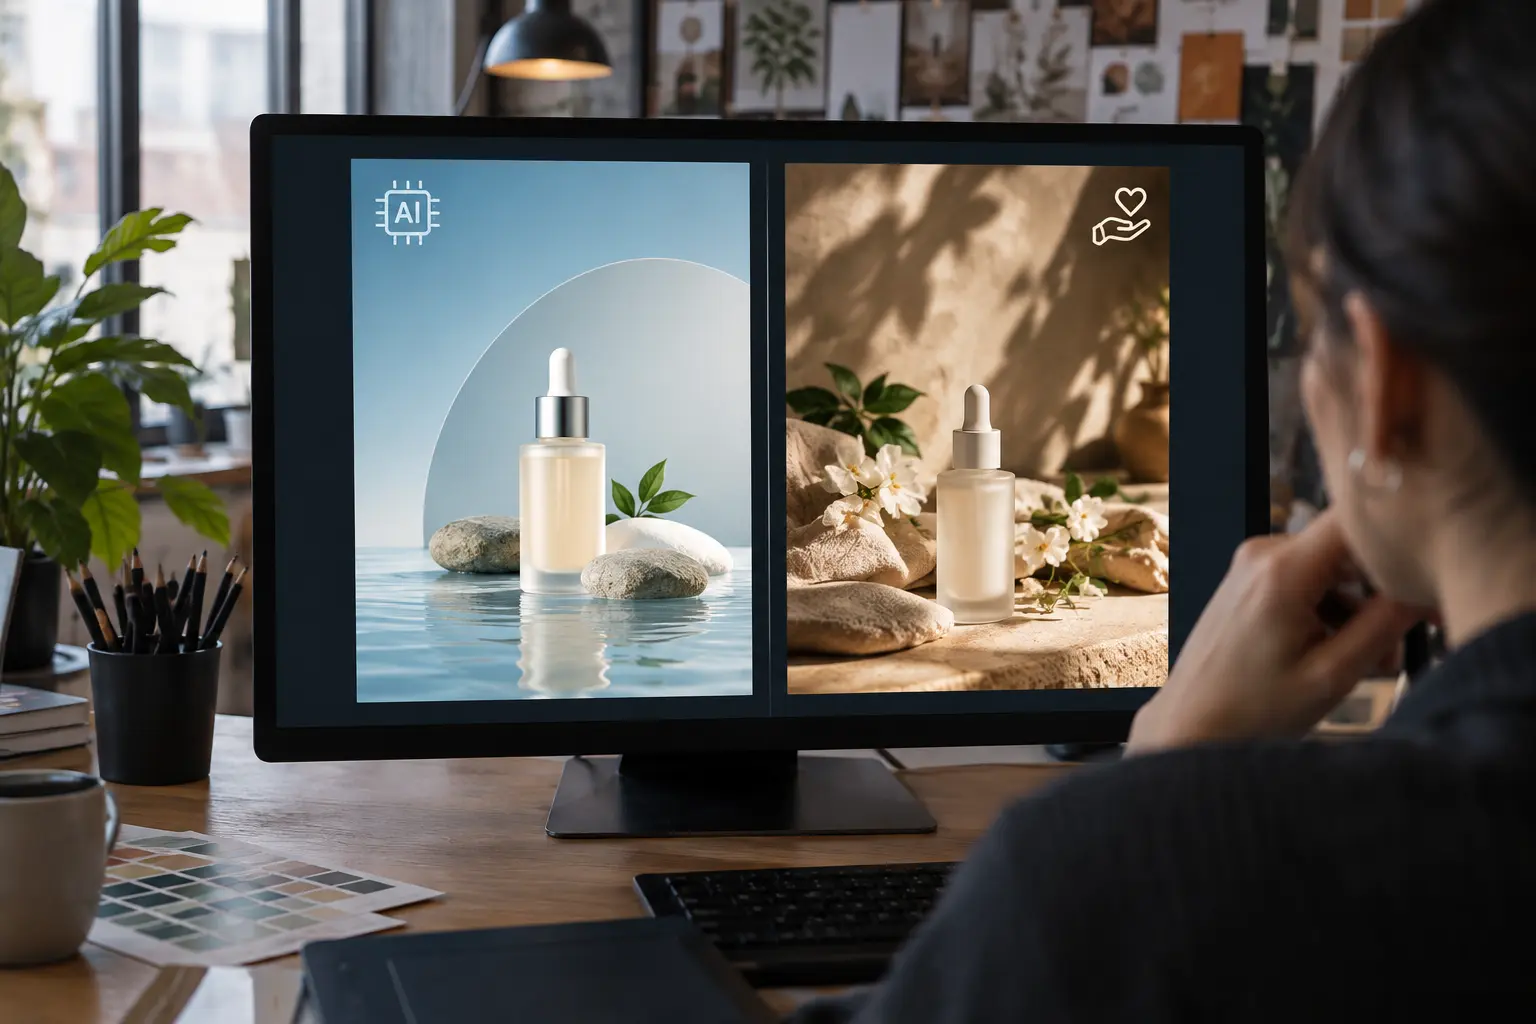
Oui, c’est même préférable à un contenu fictif décrit uniquement par du texte, car le stimulus visuel réel renforce la validité de l’expérience. Documentez précisément l’outil et le prompt utilisés pour le générer, comme n’importe quel matériel de recherche.
Ce sujet convient-il à un mémoire quantitatif seul, sans partie qualitative ?
Oui, un plan expérimental avec questionnaire post-exposition constitue à lui seul un mémoire quantitatif complet. La partie qualitative reste une option pour enrichir l’interprétation, pas une obligation.
Combien de répondants faut-il pour un plan expérimental de ce type ?
Une trentaine de répondants par condition expérimentale est un repère courant pour un mémoire de master, suffisant pour des tests de comparaison de moyennes simples, à condition de le justifier dans le chapitre méthode plutôt que de le présenter comme un choix arbitraire.
Une fois l’angle choisi, la formulation précise des hypothèses et du modèle de recherche suit la méthode détaillée dans le guide sur les hypothèses et le modèle de recherche en marketing, et le choix des échelles de mesure (confiance, intention d’achat) dans le comparatif des échelles de mesure en marketing. Pour cadrer le chapitre théorique complet, le guide sur le cadre théorique d’un mémoire de marketing détaille le modèle TAM évoqué ici, ainsi que la TPB et le modèle AIDA.
Plus de 9 000 étudiants rédigent déjà leur mémoire avec Tesify, et chaque ligne reste 100 % écrite par vous. Créez votre espace de rédaction sur Tesify pour avancer sur votre mémoire de marketing, de la problématique à la méthode.